Análisis del paisaje sonoro (ISO/TS 12913)
Normas aplicables: ISO/TS 12913ISO 12913
Un nivel sonoro dice cuánto sonido llega a un lugar. No dice si la gente que está allí lo encuentra agradable, animado, tranquilizador o molesto, y dos plazas con el mismo pueden oírse como lugares opuestos. El paisaje sonoro es el entorno acústico tal como lo percibe una persona, en su contexto (ISO 12913-1), y su estudio «relies primarily upon human perception and only then turns to physical measurement» (ISO/TS 12913-2): se apoya primero en la percepción humana y solo después en la medición física.
Eso hace de esta la primera página de la biblioteca cuya entrada no es una señal sino un cuestionario: las casillas que la gente marcó en un paseo sonoro. ISO/TS 12913-2 imprime los cuestionarios y dice qué tiene que contar un estudio; ISO/TS 12913-3 convierte las marcas en números, sitúa cada lugar en un modelo de dos dimensiones de lo agradable y lo eventual que suena, correlaciona las respuestas con las mediciones acústicas y dice cómo se analiza una grabación binaural hecha en el mismo sitio.
Esta página implementa la edición de 2019 de ISO/TS 12913-3. ISO ha publicado una edición de 2025 que revisa el Anexo A, donde están las fórmulas de agradabilidad y actividad; no se ha leído para esta implementación, así que un estudio que cite la edición de 2025 debe cotejar esas fórmulas con ella.
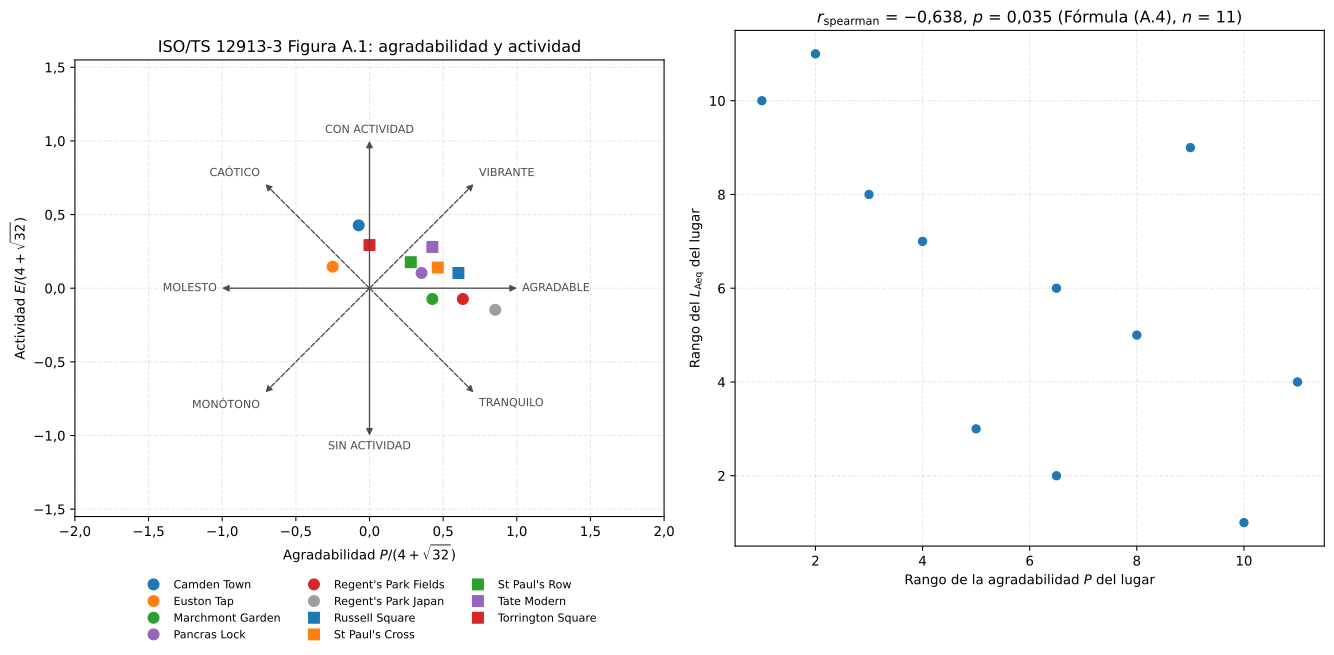
Once lugares de Londres de la International Soundscape Database sobre el
modelo de la Figura A.1 (izquierda) y la correlación por rangos de su
agradabilidad con su nivel (derecha), ambos dibujados por el propio .plot()
de los resultados, con los dos ejes de rango rotulados con lo que se ordenó.
1. El cuestionario y sus valores de escala
Sección titulada «1. El cuestionario y sus valores de escala»El Método A de ISO/TS 12913-2 (apartado C.3.1) es un cuestionario de cuatro partes, todas de cinco casillas: qué fuentes se oyen y cuánto (Figura C.2, o la Figura C.3 de tres fuentes), cómo se percibe el lugar en ocho atributos (Figura C.4), lo bueno que es el entorno sonoro en conjunto (Figura C.5) y lo adecuado que es al lugar (Figura C.6). La biblioteca lo publica entero, cada pregunta, elemento y categoría de respuesta tal como se imprime, con los valores de escala que asigna la Tabla A.1 de ISO/TS 12913-3:
from phonometry import environment
part2 = environment.METHOD_A_SCALES[2]print(part2.figure, part2.categories[0], part2.scale_values)  # C.4 Strongly agree (5, 4, 3, 2, 1)print(environment.method_a_scale_values([1, 2, 5], part=2))  # [5. 4. 1.]print(environment.method_a_scale_values([1, 2, 5], part=4))  # [1. 2. 5.]
Lo que hay que acertar es la orientación. Las partes 1 y 4 van de 1 a 5 desde
la casilla de la izquierda, así que «not at all» vale 1; las partes 2 y 3 van
de 5 a 1, así que «strongly agree» y «very good» valen 5.
method_a_scale_values convierte la posición de la casilla marcada, contada
desde la izquierda, en el valor de su parte; todo lo que viene después toma
valores de escala, nunca posiciones de casilla.
Las tablas guardan el texto tal como se imprime, incluidos dos deslices de la página: las preguntas de las Figuras C.2 a C.4 dicen «to what extend» y sus instrucciones «reponse alternative». Un estudio que imprima su cuestionario a partir de ellas debe corregir ambos; el registro de erratas tiene la entrada. Los ocho atributos se dejan con las palabras inglesas del cuestionario, porque son esas las que el participante lee; las figuras los rotulan en castellano de forma descriptiva, no como una traducción validada del cuestionario.
2. Mediana y recorrido por lugar
Sección titulada «2. Mediana y recorrido por lugar»Todas las escalas del Método A son ordinales, así que A.2 de ISO/TS 12913-3 da la mediana de cada elemento por lugar como medida de tendencia central y el recorrido como medida de dispersión. Una respuesta en blanco queda fuera de las dos:
answers = {"pleasant": [5, 4, 4, 2, 5], "annoying": [1, 2, 1, 4, 1]}summary = environment.method_a_summary( answers, part=2, sites=["park", "park", "park", "road", "road"])print(summary.sites) # ('park', 'road')print(summary.medians.tolist()) # [[4.0, 1.0], [3.5, 2.5]]print(summary.ranges.tolist()) # [[1.0, 1.0], [3.0, 3.0]]Un array 2-D (respuestas, elementos) se lee en el orden de la figura de la
parte, y summary.plot() dibuja la mediana de cada elemento con su recorrido
como una barra, un lugar junto a otro.
3. Agradabilidad y actividad
Sección titulada «3. Agradabilidad y actividad»Los ocho atributos de la parte 2 no son ocho juicios independientes. Cuando la gente describe cómo se siente un entorno, sus respuestas caen sobre dos dimensiones: lo agradable que es, y lo eventual, cuánta actividad humana o de otro tipo hay en él. Girar esos dos ejes 45 grados da los otros dos pares de atributos: vibrante es agradable y con actividad, caótico es con actividad y molesto, monótono es molesto y sin actividad, tranquilo es sin actividad y agradable. Las Fórmulas (A.1) y (A.2) proyectan las ocho respuestas sobre los dos ejes principales, con como peso de los diagonales:
con pleasant, annoying, calm, chaotic, vibrant, monotonous, eventful y uneventful, cada uno un valor de escala de 1 a 5. Todos los términos son diferencias, así que quien da a todos los atributos la misma respuesta queda en el origen, y los extremos son : 4 del eje principal y de los dos diagonales. Dividir por lleva las coordenadas a .
Los once lugares de Londres de la International Soundscape Database se encuestaron casi por completo con el cuestionario inglés del Método A; diez respuestas, en cuatro de los lugares, se dieron con la versión española de la encuesta de la base de datos y también se cuentan. Estas son las medianas por lugar de sus respuestas y la mediana del de sus grabaciones:
sites = ["Camden Town", "Euston Tap", "Marchmont Garden", "Pancras Lock",         "Regent's Park Fields", "Regent's Park Japan", "Russell Square",         "St Paul's Cross", "St Paul's Row", "Tate Modern", "Torrington Square"]# Medianas por lugar de los ocho atributos, en el orden de la Figura C.4:# pleasant, chaotic, vibrant, uneventful, calm, annoying, eventful, monotonous.medians = [    [3, 4, 4, 2, 2, 3, 4, 3], [2, 4, 3, 3, 2, 3, 3, 3], [4, 2, 3, 3, 4, 2, 3, 2],    [4, 3, 3, 2, 4, 2, 3, 2], [5, 2, 3, 3, 4, 1, 3, 2], [5, 1, 4, 3, 5, 1, 3, 2],    [4, 2, 4, 2, 4, 1, 3, 2], [4, 2.5, 4, 2, 4, 2, 3, 2], [4, 3, 4, 2, 3, 2, 3, 3],    [4, 3, 4, 2, 4, 2, 4, 2], [3, 4, 4, 3, 2, 3, 3, 2],]laeq_db = [69.96, 69.45, 55.14, 59.02, 53.12, 59.74, 66.12, 61.83, 63.34, 63.00, 63.51]
pe = environment.pleasantness_eventfulness(medians, sites=sites)print(round(pe.normalized_pleasantness[5], 2), round(pe.normalized_eventfulness[5], 2))  # 0.85 -0.15print(round(pe.normalized_pleasantness[0], 2), round(pe.normalized_eventfulness[0], 2))  # -0.07 0.43print(round(environment.PLEASANTNESS_EVENTFULNESS_RANGE, 2))  # 9.66
El jardín japonés de Regent’s Park (índice 5) sale el más agradable y algo sin
actividad, en el cuadrante tranquilo; Camden Town (índice 0) es el de más
actividad y queda un poco del lado molesto. pe.plot() dibuja el modelo de la
Figura A.1 con todos los lugares, el panel izquierdo de la figura de arriba.
Con las respuestas de cada encuestado en lugar de las medianas,
pleasantness_eventfulness devuelve las dos cosas: las coordenadas propias de
cada encuestado (respondent_pleasantness, respondent_eventfulness) y las
del lugar. El punto del lugar son las fórmulas aplicadas a la mediana del
lugar de cada atributo, porque A.2 hace de la mediana la tendencia central de
la escala; central_tendency="mean" usa la media. Cuando todos los
encuestados han contestado los ocho atributos, ese punto de medias es también
la media de las coordenadas de los encuestados, al ser lineales las fórmulas;
una respuesta en blanco rompe la igualdad, porque cada media de atributo se
toma entonces sobre los encuestados que contestaron ese atributo.
pe.plot(respondents=True) añade cada encuestado como un punto tenue del
color de su lugar.
El apartado A.3 presenta las fórmulas como un tratamiento de «the results from part 3». Los atributos que leen son la parte 2, como dicen la Tabla A.1, el resto del Anexo A y la Figura C.4 de ISO/TS 12913-2; la parte 3 es la valoración global única de la Figura C.5. La biblioteca las aplica a la parte 2, y el registro de erratas tiene la entrada.
4. Enlazar las valoraciones con los datos acústicos
Sección titulada «4. Enlazar las valoraciones con los datos acústicos»Después un estudio pregunta si lo que dice la gente va con lo que se midió. Para datos ordinales A.4 prescribe la correlación por rangos de Spearman: sin empates, la Fórmula (A.3),
con la diferencia de los rangos del par , y con empates en cualquiera de las dos variables, la Fórmula (A.4), que corrige las varianzas de los rangos con las sumas de empates y de las dos variables y es el coeficiente de Pearson de los rangos medios. Las medianas de arriba tienen empates, así que:
rho = environment.spearman_rank_correlation(pe.pleasantness, laeq_db)print(rho.formula, round(rho.coefficient, 3), round(rho.p_value, 3))  # (A.4) -0.638 0.035
r = environment.pearson_correlation(pe.pleasantness, laeq_db)print(r.formula, round(r.coefficient, 3), round(r.p_value, 3))  # (B.1) -0.66 0.027
En estos once lugares los sitios más ruidosos son los menos agradables, y de
forma significativa. Sobre las 26 localizaciones de la base de datos la
correlación por rangos es de unos (). A.4 y B.3 piden la
probabilidad sin nombrar ninguna prueba; las dos funciones usan el estadístico
de Student con grados de libertad, exacto para
el coeficiente de Pearson de datos normales bivariantes y la aproximación
habitual para el de Spearman. alternative="greater" o "less" da el valor
unilateral.
Conviene saber tres detalles de la página. La Fórmula (A.3) se imprime como
, con un factor 1 suelto que la
biblioteca lee como el resto de composición que es. La lista de definiciones
bajo la Fórmula (A.4) define como «the number of in tied ranks» y
como «the numbers of tied ranks»; la biblioteca las lee como el tamaño
de cada grupo de valores empatados y el número de esos grupos, la corrección
por empates habitual. Y la Fórmula (B.2), la covarianza de Pearson para datos
de intervalo, divide por ; las desviaciones típicas de (B.1) se toman
entonces también con , que es lo que hace de el coeficiente habitual.
Las dos primeras, y una mayúscula suelta en la lista de definiciones de (B.2),
están en el registro de erratas. rho.plot() dibuja los pares ordenados
por rango, el panel derecho de la figura de arriba.
5. Método B: escalas continuas y la ordenación de fuentes
Sección titulada «5. Método B: escalas continuas y la ordenación de fuentes»El Método B (ISO/TS 12913-2 C.3.2) es la recogida de datos del paseo sonoro: en cada parada los participantes marcan escalas continuas, apuntan las fuentes que han notado de la más perceptible a la menos y escriben lo que les ha pasado por la cabeza. Una marca puede caer en cualquier punto de la escala; su valor va de 1 en la marca de la izquierda a 5 en la de la derecha y se toma con un decimal (ISO/TS 12913-3 B.2). El nivel de medida es de intervalo, así que B.2 da la media, la desviación típica y el intervalo de confianza del 95 % por lugar:
print(environment.method_b_scale_values([0.0, 0.37, 1.0]))  # [1.  2.5 5. ]
ratings = {"How loud is it here?": [3.9, 4.2, 3.1, 4.4, 3.6, 4.0]}b = environment.method_b_summary(ratings)print(round(b.means[0, 0], 2), round(b.standard_deviations[0, 0], 2))       # 3.87 0.46print(round(b.confidence_lower[0, 0], 2), round(b.confidence_upper[0, 0], 2))  # 3.38 4.35
ranking = environment.method_b_source_ranking(    [["traffic", "voices", "birds"], ["traffic", "birds"], ["voices", "traffic"], ["traffic"]])print(ranking.sources, ranking.median_ranks[0].tolist())  # ('traffic', 'voices', 'birds') [1.0, 1.5, 2.5]
El intervalo es el de Student alrededor de la media con la desviación típica muestral; la mediana se da a su lado, como los «statistics for an ordinal scale level» que B.2 admite. La ordenación de fuentes también es ordinal: el rango mediano de cada fuente y su recorrido, sobre los participantes que la apuntaron.
El texto de C.3.2.3 describe tres escalas rotuladas de «not at all» a
«extremely»; la Figura C.7 imprime cuatro, la cuarta («How often would you like
to visit this place again?») rotulada de «never» a «very often».
METHOD_B_SCALES guarda las cuatro tal como se imprimen y method_b_summary
acepta una tabla con tres o con cuatro; la contradicción está en el
registro de erratas.
6. El análisis binaural
Sección titulada «6. El análisis binaural»Un estudio de paisaje sonoro graba el lugar con una cabeza artificial a
1,6 m, durante al menos 3 min, con una frecuencia de muestreo de 44,1 kHz o más
(ISO/TS 12913-2, Anexo D), y ecualiza la grabación para aproximarla a una
medición monoaural antes de analizarla. Cada métrica de la Tabla D.1 de
ISO/TS 12913-3 se determina entonces en cada oído, y la mayor de las dos
es el valor representativo único que indica «the overall experience»; su media
puede darse además (D.2). binaural_indicators hace eso con una grabación
calibrada de dos canales, el oído izquierdo primero, con la implementación
propia de la biblioteca de cada métrica. Una calle sintética, ocho segundos
con un vehículo que pasa de izquierda a derecha:
import warnings
import numpy as np
fs = 48_000rng = np.random.default_rng(12913)t = np.arange(8 * fs) / fsbackground = 0.02 * rng.standard_normal(t.size)swell = np.exp(-0.5 * ((t - 4.0) / 0.9) ** 2)vehicle = 0.08 * rng.standard_normal(t.size)left = background + swell * vehicleright = 0.9 * background + 10 ** (-3 / 20) * np.roll(swell, int(0.3 * fs)) * vehicle
with warnings.catch_warnings():    # Ocho segundos quedan por debajo de los 3 min de ISO/TS 12913-2 D.3, que    # el análisis diría si no con un SoundscapeWarning.    warnings.simplefilter("ignore", environment.SoundscapeWarning)    bi = environment.binaural_indicators(        np.vstack([left, right]), fs, parameters=("sound_pressure_level", "loudness", "sharpness")    )laeq = bi.metrics["LAeq,T"]print(round(laeq.left, 1), round(laeq.right, 1), round(laeq.representative, 1))  # 63.5 61.1 63.5print(round(bi.representative("N5"), 1), round(bi.representative("N5/N95"), 2))  # 22.2 2.27print(sorted(bi.not_implemented))  # ['S5', 'S95', 'Saverage']
Cada fila de la tabla sale de una función que la biblioteca ya tiene, y cada
métrica dice cuál en su method:
| Fila de la Tabla D.1 | Métricas por oído | Calculadas con |
|---|---|---|
| Nivel de presión acústica (ISO 1996-1) | , , , | signals.laeq, signals.leq de la señal ponderada C, signals.ln_levels con ponderación temporal F |
| Sonoridad (ISO 532-1) | , , , , | psychoacoustics.loudness_zwicker, variable en el tiempo |
| Agudeza (DIN 45692) | , , | sin calcular, ver más abajo |
| Tonalidad psicoacústica (ECMA 74) | psychoacoustics.tonality_ecma (ECMA-418-2:2025) | |
| Aspereza | , | psychoacoustics.roughness_ecma (ECMA-418-2:2025) |
| Intensidad de fluctuación | , | psychoacoustics.fluctuation_strength_ecma (ECMA-418-2:2025) |
es la raíz cúbica de la media de los cubos de la sonoridad en
el tiempo, tal como la imprime la fórmula de la NOTA bajo A.3 f) de
ISO/TS 12913-2; el texto de esa NOTA llama al segundo paso «the exponent 3»
donde la fórmula aplica , y el
registro de erratas tiene la entrada.
es la razón de
variabilidad que sugiere D.2. La Tabla D.1 cita ECMA-74 para la tonalidad; la
edición vigente de ECMA-74 remite su método de tonalidad psicoacústica al
apartado 6 de ECMA-418-2, que es lo que implementa tonality_ecma. Para la
aspereza y la intensidad de fluctuación la tabla cita un libro de texto, e
ISO/TS 12913-2 advertía en su Anexo B en 2018 que no había método
normalizado; la biblioteca usa para las dos el modelo auditivo de
ECMA-418-2:2025, y es el valor que ese modelo da como su aspereza (el
superado el 10 % del tiempo).
La fila de la agudeza se deja vacía, a propósito. ,
y son percentiles de una agudeza que varía con
el tiempo. La agudeza DIN 45692 de la biblioteca se calcula a partir de la
sonoridad específica estacionaria, y su sonoridad variable en el tiempo no
publica la sonoridad específica a lo largo del tiempo que necesita una agudeza
variable, así que not_implemented explica por qué en lugar de poner un
número estacionario bajo el nombre de un percentil.
Las métricas del modelo auditivo son caras: con una grabación de 3 min la
tonalidad, la aspereza y la intensidad de fluctuación tardan minutos cada una,
la tonalidad la que más. parameters elige las filas que se calculan. Una
grabación de menos de 3 min o muestreada por debajo de 44,1 kHz produce un
SoundscapeWarning; la ecualización, la posición y la calibración son cosa de
quien llama.
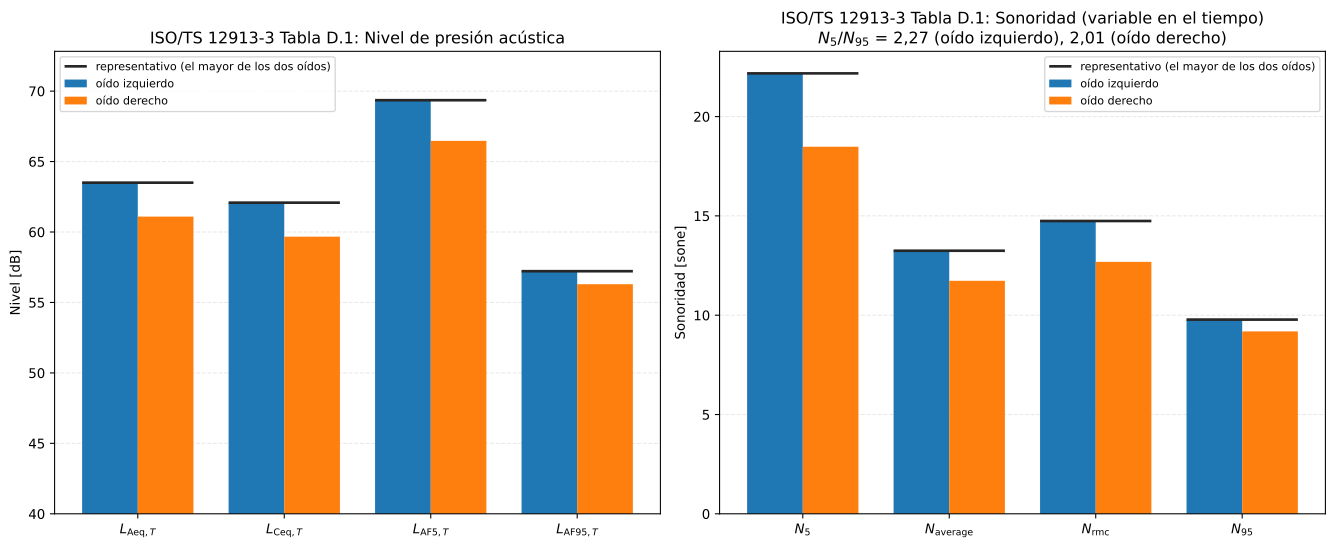
Dos filas de la Tabla D.1 en los dos oídos de la calle sintética, de
bi.plot(parameter="sound_pressure_level") y bi.plot(parameter="loudness").
El oído izquierdo oye el vehículo antes y más fuerte, así que es el oído
representativo en todas las métricas.
7. Lo que tiene que decir el informe
Sección titulada «7. Lo que tiene que decir el informe»El Anexo A (normativo) de ISO/TS 12913-2 enumera el mínimo que da un estudio
de paisaje sonoro: quiénes fueron los participantes y cómo se eligieron (A.2),
el entorno acústico con los resultados de sus mediciones (A.3) y cómo se
recogieron los datos de percepción (A.4), con una copia del cuestionario.
SoundscapeReport reúne los tres registros y se niega a construirse si falta
un elemento obligatorio, nombrando su apartado; los siete resultados de A.3 f)
salen directamente del análisis binaural:
report = environment.SoundscapeReport( participants=environment.SoundscapeParticipants( selection="visitors approached at the entrance, one in three", residents_or_visitors="visitors", lay_or_expert="lay people", age_and_gender_distribution="18 to 74 years, 52 % women", other_relevant_information="self-reported normal hearing", ), acoustic_environment=environment.SoundscapeAcousticEnvironment( environment_type="real", sound_sources="road traffic in the background, a passing car in the foreground", weather_and_wind="dry, wind under 2 m/s", time_of_year_and_day="June, 14:00 to 16:00", measurement_points="kerbside, artificial head at 1,6 m facing the road", measurement_results=bi.reporting_results(), site_description="urban street, residential", ), data_collection=environment.SoundscapeDataCollection( methods="Method A questionnaire, parts 1 to 4", questions="Figures C.2 to C.6 of ISO/TS 12913-2, answers on paper", language="English, as printed in Annex C", instrument_copy="Appendix B", rating_scale_construction="five-category scales of Figures C.2 to C.6", ),)print(round(report.acoustic_environment.measurement_results["N5"], 1)) # 22.2Cada elemento es texto libre, porque el anexo dice qué se declara y no cómo. La descripción del lugar es obligatoria en un estudio de campo o con grabaciones, y la grabación y reproducción en un entorno grabado o virtual; un registro que existe cumple el mínimo hasta donde un registro puede saberlo, y si lo que dice es cierto y suficiente queda en manos de quien lo firma.
Ver el código de estas figuras
import matplotlib.pyplot as plt
fig, (ax_model, ax_rank) = plt.subplots(1, 2, figsize=(14.0, 6.6))pe.plot(ax_model, language="es")    # la Figura A.1 con los once lugaresrho.plot(ax_rank, language="es")    # los pares ordenados de la Fórmula (A.4)ax_rank.set_xlabel(r"Rango de la agradabilidad $P$ del lugar")ax_rank.set_ylabel(r"Rango del $L_\mathrm{Aeq}$ del lugar")plt.tight_layout()   # sitio para la leyenda de lugares bajo la Figura A.1
fig, (ax_levels, ax_loudness) = plt.subplots(1, 2, figsize=(14.0, 5.8))bi.plot(ax_levels, parameter="sound_pressure_level", language="es")bi.plot(ax_loudness, parameter="loudness", language="es")plt.tight_layout()plt.show()
Qué cubre esta guía
Sección titulada «Qué cubre esta guía»Cubierto
ISO/TS 12913-3:2019, el análisis cuantitativo: los valores de escala de la Tabla A.1 con la orientación de cada parte, la mediana y el recorrido por lugar y elemento (A.2), la agradabilidad y la actividad de las Fórmulas (A.1) y (A.2) por encuestado y por lugar, en bruto y normalizadas, con el modelo de la Figura A.1 como gráfico; el coeficiente de Spearman con las Fórmulas (A.3) y (A.4) y el de Pearson con (B.1) y (B.2), cada uno con su probabilidad; los valores de escala, la media, la desviación típica, el intervalo de confianza y la ordenación de fuentes del Método B del Anexo B; y el análisis binaural del Anexo D, cada métrica de la Tabla D.1 que implementa la biblioteca en cada oído, con el valor representativo de D.2 y la razón . ISO/TS 12913-2:2018: los cuestionarios del Anexo C como tablas publicadas, las comprobaciones de la grabación del Anexo D (3 min, 44,1 kHz) y los requisitos mínimos de informe del Anexo A como registro.
No cubierto
La edición de 2025 de ISO/TS 12913-3, que revisa el Anexo A, no está implementada. La agudeza variable en el tiempo , y de la Tabla D.1 no se calcula. No se modelan los análisis cualitativos (la teoría fundamentada y el análisis de contenido del apartado 6 y del Anexo C, los comentarios libres del Método B, la guía de entrevista del Método C), la triangulación del Anexo E, los estudios de laboratorio del Anexo F, el agrupamiento y los mapas psicoacústicos de D.2 y D.3, la varianza no explicada de D.1 ni el coeficiente de variación de mediciones repetidas. La ecualización de la grabación binaural y el protocolo de medición binaural de ISO/TS 12913-2 D.7 son cosa de quien llama.
Referencias
Sección titulada «Referencias»- International Organization for Standardization. (2014). Acoustics — Soundscape — Part 1: Definition and conceptual framework (ISO 12913-1:2014). La definición de paisaje sonoro y los términos que usan las otras dos partes.
- International Organization for Standardization. (2018). Acoustics — Soundscape — Part 2: Data collection and reporting requirements (ISO/TS 12913-2:2018). Los cuestionarios del Anexo C transcritos como tablas publicadas, los requisitos de la medición binaural del Anexo D que el análisis comprueba y los requisitos mínimos de informe del Anexo A como registro.
- International Organization for Standardization. (2019). Acoustics — Soundscape — Part 3: Data analysis (ISO/TS 12913-3:2019). El análisis implementado: los valores de escala y los estadísticos ordinales del Anexo A (Tabla A.1), la agradabilidad y la actividad de las Fórmulas (A.1) y (A.2) con el modelo de la Figura A.1, el coeficiente de Spearman de las Fórmulas (A.3) y (A.4), los estadísticos del Método B y el coeficiente de Pearson del Anexo B, y las métricas binaurales y sus valores representativos del Anexo D (Tabla D.1). Es la primera edición. ISO ha publicado después ISO/TS 12913-3:2025, que revisa el Anexo A; no se ha leído para esta implementación.
- Mitchell, A., Oberman, T., Aletta, F. y et al. (2024). The International Soundscape Database (ISD), v1.0. Zenodo. Con licencia CC BY 4.0. Los once lugares de Londres de esta página se derivan de sus datos de encuesta: la mediana de cada uno de los ocho atributos por lugar y la mediana del LAeq de las grabaciones del lugar. Se usan como datos reales para los ejemplos y como comprobación de coherencia de las fórmulas, no como referencia de calibración.