Qué muestran
Un dashboard, renderizado una vez por almacén. Diecisiete secciones, ciento cincuenta y cuatro paneles, en los mismos sitios y con los mismos títulos sea cual sea la base de datos elegida. Abajo hay una captura por sección, en el orden en que el dashboard las coloca.
Todas las secciones salvo Overview se abren plegadas. Abiertas, las siete primeras eran veintitrés pantallas de teléfono antes de que el lector supiera que había diez más; plegadas, la segunda pantalla de un teléfono es el índice de las dieciséis, cada una a un toque, y Grafana conserva en la URL lo que se abrió. En un escritorio cuesta un clic por sección, y la primera carga pide los paneles de Overview y no todos.
Un repositorio se distingue por su nombre completo en todos los paneles. Dos
propietarios pueden dar el mismo nombre a un repositorio, como una cuenta y una
organización a la que pertenece, que tienen cada una su .github, y una
consulta que agrupaba, unía, contaba o tomaba la fila más reciente solo por el
nombre corto convertía los dos en uno: “Open the longest” listaba alice/x#5 y
acme/x#5 como una sola pull request, y cada gráfica por repositorio los
dibujaba como una sola serie. Desde la 2.6.1 todos los almacenes identifican un
repositorio por su nombre completo, y el exportador conserva el nombre completo
en cada gauge que nombra uno. Una tabla sigue mostrando el nombre corto, así que
los dos son dos filas con el mismo nombre, y el selector de repositorio sigue
filtrando por él. Una gráfica en InfluxDB y PostgreSQL nombra una serie por su
nombre corto salvo que dos repositorios del rango lo compartan, y entonces por
sus nombres completos; los otros tres almacenes nombran ambas por el nombre
corto.
Una tarjeta que es una mediana o una proporción no tiene número en un rango sin nada que medir, y desde la 2.6.2 dice qué le faltó al rango en vez de dibujar un hueco bajo su etiqueta: “none merged” bajo el tiempo hasta fusionar y las líneas por pull request, “no issue closed”, “none decided” bajo la tasa de éxito, “no runs” y “no jobs” bajo la duración de la ejecución y la espera en cola, “no commits” bajo la proporción firmada, y “no deliveries” en la tasa de fallo de los webhooks. Las palabras bajo una tarjeta se dibujan en el color del texto, no en el del umbral más bajo de la tarjeta, que es rojo para la tasa de éxito y la proporción firmada: “none decided” no es una compilación fallida. Un recuento sobre un rango así da 0. Un total tampoco tiene número, ya que en los almacenes SQL la suma de ninguna fila es nula, y también dice qué le faltó al rango: “no traffic” bajo las visitas y los dos recuentos únicos, “not read” bajo las estrellas y los forks, el almacenamiento de artefactos y la caché, “no commits” bajo las líneas añadidas y eliminadas, “no releases” bajo el total de descargas, “none open” bajo las alertas abiertas, y “no usage” bajo el gasto. Antes de la 2.6.2 un grupo de totales de los que el rango no tenía ninguno, el tráfico o las alertas abiertas de un repositorio sin ellos, era un panel sin nada en absoluto, ni siquiera los nombres: Grafana dimensiona el texto de una tarjeta por su valor, y uno vacío se dibuja sin tamaño.
Sobre un rango o un repositorio sin nada, todos los almacenes dibujan las tarjetas que dibujan los almacenes SQL, con 0 o sin valor donde ellos lo hacen: Graphite para una ruta que nunca ha tenido, Elasticsearch para un rango en el que no tiene ningún documento, y Prometheus para una consulta que no encuentra ninguna serie. Antes de la 2.6.2 una tarjeta así salía de su grupo en esos tres, y sobre un repositorio sin nada faltaban dieciocho tarjetas en Graphite y veinte en Elasticsearch. Hasta la 2.6.4 quedaba un caso, en Elasticsearch: un valor sumado del documento más reciente de cada repositorio, release o alerta, los recuentos de estrellas y forks, el almacenamiento de artefactos y la caché, el total de descargas y las alertas abiertas, salía de su grupo cuando no había tal documento, ya que el datasource falla sin más con esa agregación sobre nada, y la tasa de éxito, la duración de la ejecución y la espera en cola junto a los dos totales de bytes salían también, porque ese panel sumaba todos sus valores y habría leído como 0 un valor de nada. Esos cuatro grupos suman ahora sus valores en las propias transformaciones del panel: cada valor llega con el nombre de su tarjeta, una vez por repositorio, release o alerta donde se suma, los valores de un mismo nombre se suman entre sí, y un nombre bajo el que no se leyó nada queda sin valor. Una consulta que responde solo el nombre, sobre cualquier rango, ocupa el lugar de cada total donde nada responde, así que todos los grupos dibujan lo que dibujan los demás almacenes.
Sobre un rango al que no llegó ningún barrido, los grupos de las instantáneas de la propia cuenta, de las que los almacenes SQL leen la fila más reciente del rango, también dicen qué le faltó al rango: desde la 2.6.4 cada tarjeta de Community, Account, Since the account began, Sponsorship y Repositories dice “not read” en todos los almacenes, y también cada barra de Contribution mix (last year), que lee la instantánea que leen las contribuciones de Account. Hasta entonces los cuatro primeros grupos decían “No data” en los cinco, ya que los almacenes SQL no tenían fila que leer, el recuento de repositorios salía de su grupo en los cinco, llevándose consigo las estrellas y los forks en Elasticsearch, y el medidor de barras decía “No data” en todos los almacenes menos Graphite, que dibujaba sus cuatro nombres sin nada al lado. Antes de la 2.6.2 Graphite, cuyas rutas responden con nulos a un rango en el que no tienen nada, dibujaba tres de los grupos como un panel sin nada, ni siquiera los nombres, y Elasticsearch dibujaba los cuatro nombres de Sponsorship sin nada al lado. Un año sin ninguno de los cuatro tipos de contribución tampoco tiene mezcla que dibujar. Las barras leen la instantánea más reciente del rango, como la tarjeta Contributions, así que cuando esa instantánea no tiene ninguno de los cuatro cada barra dice “not read” junto a una tarjeta Contributions de 0, en todos los almacenes y aunque una instantánea anterior del rango sí tuviera alguno. Hasta la 2.6.4 los almacenes SQL y Graphite dibujaban ahí la mezcla de esa instantánea anterior: los almacenes SQL dejaban fuera toda instantánea cuyos cuatro tipos sumaban 0, y las barras de Graphite tomaban la última proporción que tenía el rango, pasando por alto la instantánea que no tiene ninguna.
Overview
Sección titulada «Overview»Una cabecera y no un panel: la marca, grande y centrada, el nombre debajo, y
bajo el nombre un botón a esta documentación y otro al código, sobre la propia
página y sin caja alrededor. Después cuatro grupos de cifras: Repositories (repositorios, estrellas, forks),
Traffic in range (visitas, visitantes únicos, clonadores únicos), Community (seguidores,
seguidos, patrocinadores, patrocinados) y Account (contribuciones del último
año, edad de la cuenta, vigilados, estrellas dadas, gists, paquetes). Un grupo
es un panel de estadística con varios valores y no una tarjeta por cifra: en un
escritorio se lee como la fila de tarjetas a la que sustituye, y en un
teléfono, donde cada panel es una columna, dieciséis tarjetas eran cuatro
pantallas de cifras sueltas y cuatro grupos son una. La variable de repositorio
que hay al lado filtra todas las secciones a la vez. Estrellas y forks suman la
fila más reciente de cada repositorio y no todas las del rango, porque ambas son
estado actual y una suma sobre el rango contaría cada pasada. La fila de un
repositorio vivo es su gh_repo, que una pasada escribe cada hora, y la de uno
archivado es su gh_repo_total. Un repositorio que el filtro por omisión aparta
por estar archivado no recibe fila de gh_repo de ninguna pasada, así que el
selector deja de ofrecerlo cuando el último relleno histórico queda atrás, pero
la gente sigue dándole estrellas y haciéndole fork y cada pasada de totals
vuelve a leer sus contadores. Con All seleccionado las sumas lo incluyen. Los
cuatro almacenes que suman sobre el rango del dashboard pueden dejar fuera su
fila en un rango más corto que la cadencia de totals, una hora por omisión;
Prometheus no toma rango aquí, porque cada suma es una consulta instantánea
sobre lo último que empujó el recolector en marcha. Un repositorio archivado que la configuración ya no recoge
se queda fuera, como el selector deja fuera a uno vivo: la fila que escribió un
relleno histórico con una configuración anterior sigue en el almacén, y en la
cuenta con la que se comprobó esto un fork archivado así sumaba 8 estrellas y 3
forks, 393 y 106 donde GitHub daba 385 y 103 para lo que recogen las pasadas.
Los dashboards SQL cuentan una fila archivada solo de un repositorio con una
fila de gh_repo_total en los últimos siete días, la ventana del propio
selector. Elasticsearch y Graphite no pueden preguntar eso de una ventana
mientras leen otra, así que cuentan un repositorio archivado por sus filas de
los últimos siete días, y un rango que terminó hace más de una semana deja
fuera los archivados en esos dos. Prometheus solo guarda lo que empuja el
recolector en marcha, así que no tiene esa fila que dejar fuera. Elegir
repositorios cuenta solo esos. Cada repositorio
cuenta una vez, por su nombre completo: dos repositorios del mismo nombre de
dos dueños son dos, y uno archivado mientras el recolector funciona no se
cuenta a la vez por su fila viva y por la archivada. El recuento de
repositorios junto a las sumas es el que da GitHub de los repositorios públicos
de la cuenta, que es otro conjunto: tiene los forks públicos que el filtro por
omisión deja fuera, y ninguno de los repositorios privados que las sumas
incluyen.
La tarjeta SVG solo suma gh_repo, así que sus estrellas y
forks dejan fuera los repositorios archivados que el filtro por omisión aparta,
y que estas sumas sí cuentan. En la cuenta en la que se midió, el 2026-09-27,
el filtro por omisión apartaba diecisiete, con 80 estrellas y 24 forks.
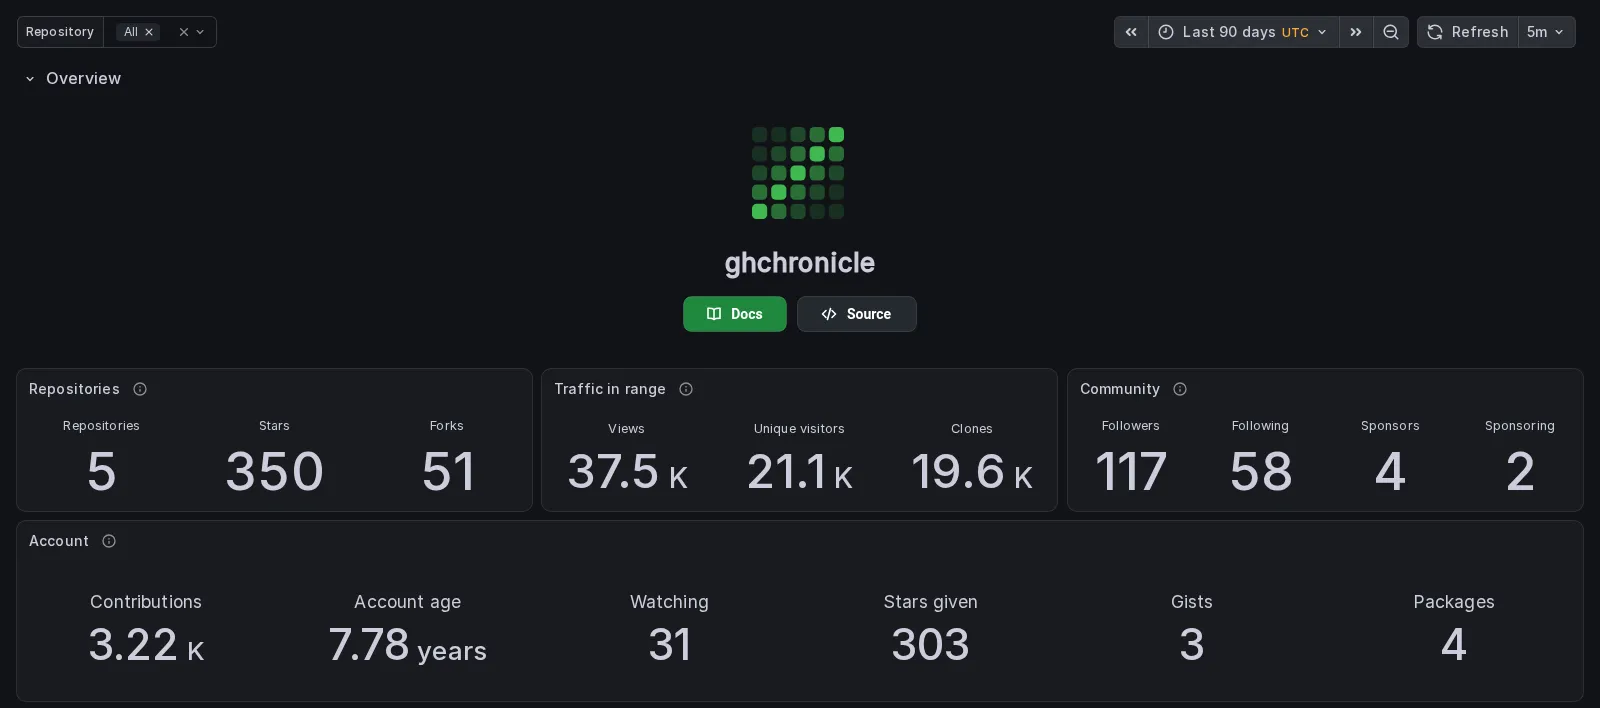
La tercera tarjeta de tráfico cuenta a quienes clonaron y no los clones. La integración continua clona todo el día, así que el recuento de clones va junto a la cifra que lo explica y no en un titular: medido en la cuenta con la que se leyó esto, un repositorio se clonó 135.683 veces en quince días desde 1.807 clonadores, y 186 K junto a 2,89 K visitas se lee como audiencia. El recuento está en dos paneles de la sección Audience. La captura de arriba es anterior a ese cambio y todavía pone “clones”.
Lee gh_account, gh_repo, gh_repo_total, gh_traffic y
gh_contributions_total.
Lifetime
Sección titulada «Lifetime»Seis cifras que son ciertas desde que existe la cuenta, en un solo panel, y una fila por repositorio con su vida entera: pull requests fusionadas y revisadas alguna vez, commits totales, issues abiertas, lo fusionado en repositorios ajenos y en cuántos hilos se comentó allí.
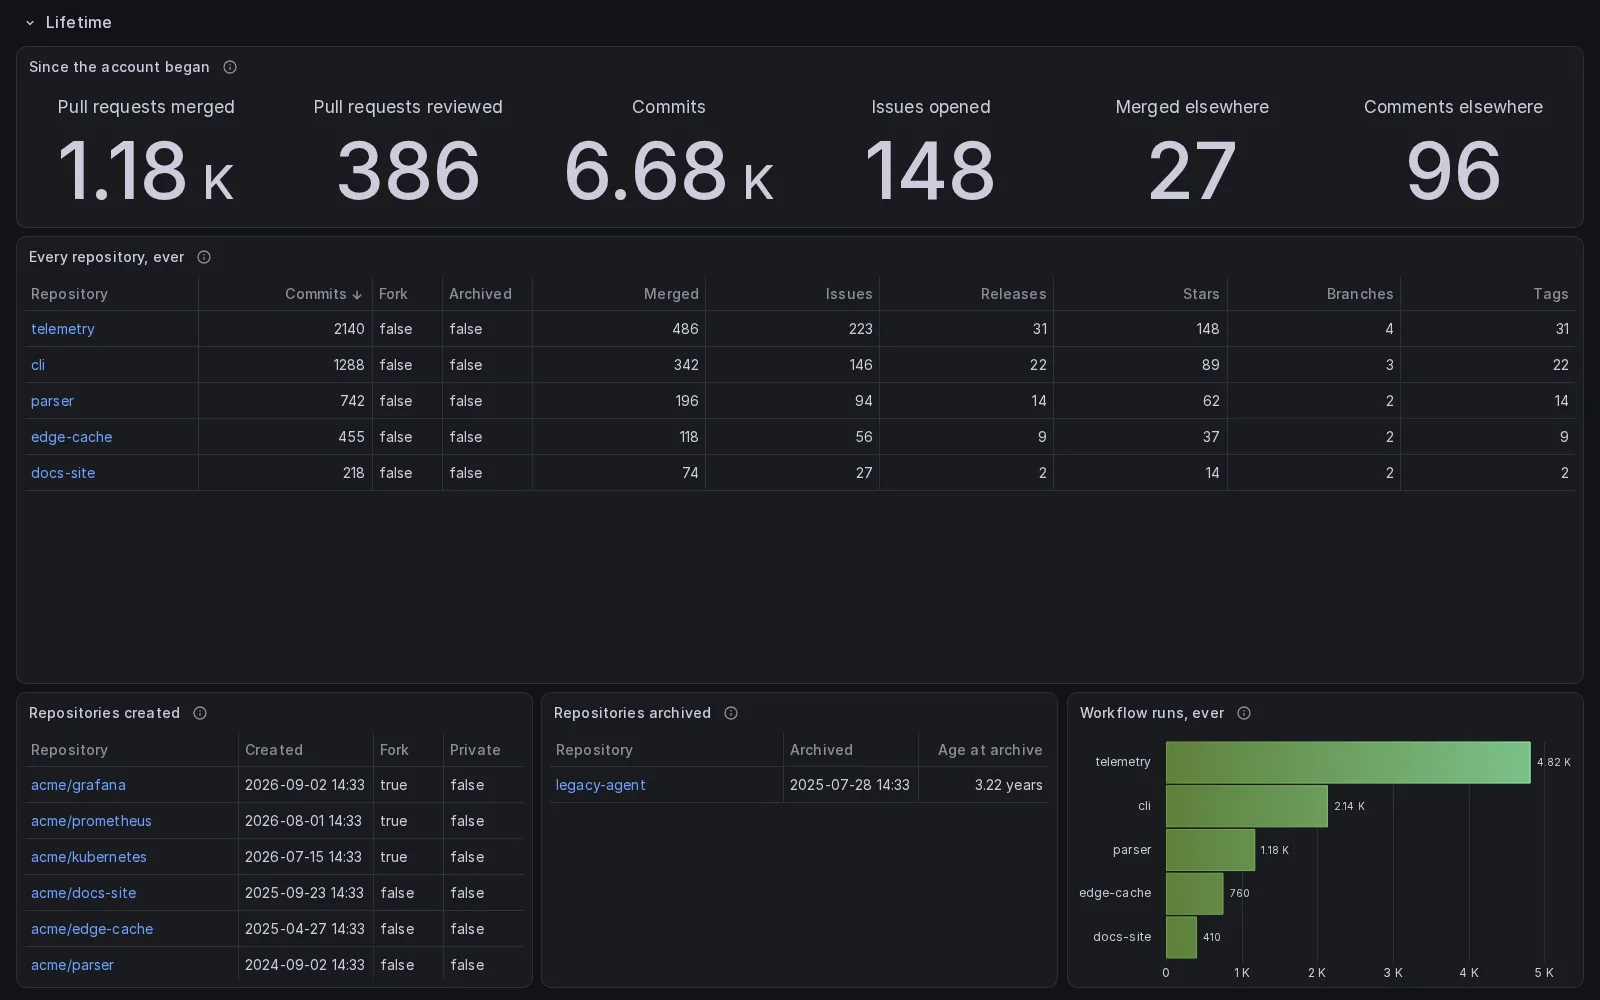
La última tarjeta cuenta hilos y no comentarios, cada issue o pull request una vez por muchos comentarios que dejara la cuenta en ella, y solo en repositorios que no son suyos, el mismo fuera que la tarjeta de al lado. La captura de arriba es anterior a ambas cosas: su tarjeta pone “Comments elsewhere”, y sus 96 incluían hilos de los repositorios propios de la cuenta.
Todas las demás secciones cuentan filas dentro del rango del dashboard. Estas no: las cuenta GitHub, en una búsqueda o un campo de GraphQL cada una, y el colector guarda la respuesta como una sola fila. Por eso son instantáneas y por eso ya son correctas en la primera pasada de una instalación nueva, cosa que un contador acumulado por esta herramienta no sería. Es además la forma que un almacén puede responder sin leer todo lo que guarda: InfluxDB 3 Core rechaza una consulta que abra más ficheros que su tope, cuarenta mil donde esto se midió, y “cuántas en total” a partir de una fila por hecho es exactamente esa consulta.
“Every repository, ever” lista todos los repositorios que tiene el selector,
forks y archivados incluidos cuando las pasadas los recogen, porque eso es lo
que dice el título. Se ordena
por commits, lo que en una cuenta con forks de proyectos concurridos significa
que la historia de otra persona supera a todo lo que ha escrito la cuenta:
370.296 commits frente a 3.385 donde se leyó esto. Así que las marcas de fork y
archivado son columnas, y la tabla se abre ordenada por la primera y luego por
commits, lo que pone los repositorios propios en la primera pantalla y los
forks debajo sin dejar ninguno fuera. Con All seleccionado lista también los
repositorios archivados que el filtro por omisión aparta, con sus contadores
actuales, los ofrezca o no el selector: ninguna pasada les escribe fila de
gh_repo, que es lo que lista el selector, pero la misma fila de cada uno se
vuelve a leer en cada pasada de totals. Uno que la configuración ya no recoge
se queda fuera, como en el Overview, y Elasticsearch y Graphite aplican aquí
también la regla de los siete días del Overview: un rango que terminó hace más
de una semana deja fuera los repositorios archivados que el filtro por omisión
aparta. Cada fila es la más reciente del repositorio dentro del rango, una por
nombre completo, y no el valor más alto que alcanzó cada columna en él:
estrellas, ramas, etiquetas, releases e issues abiertos bajan, y una tabla de
máximos daba a un repositorio 4 estrellas por la fila de un relleno histórico
de hacía nueve días donde GitHub y su fila más reciente decían 3. Un
repositorio archivado dentro del rango tiene filas de antes del archivado y de
después, y sigue siendo una fila en todos los almacenes. Cuatro de ellos lo
marcan como archivado; Graphite guarda solo los commits, sin columna de fork
ni de archivado. Elasticsearch solo toma una fila archivada si es de los
últimos siete días, así que un repositorio archivado dentro de un rango que terminó
hace más de una semana aparece allí por sus filas de antes del archivado, como
no archivado.
Debajo de la tabla, los repositorios creados y los archivados, cada uno con la fecha en que ocurrió y no la de la pasada que lo vio, y las ejecuciones de workflow que ha tenido cada repositorio, del total del propio listado de ejecuciones.
Lee gh_account_total, gh_repo_total, gh_repo_created,
gh_repo_archived y gh_workflow_run_total.
Audience
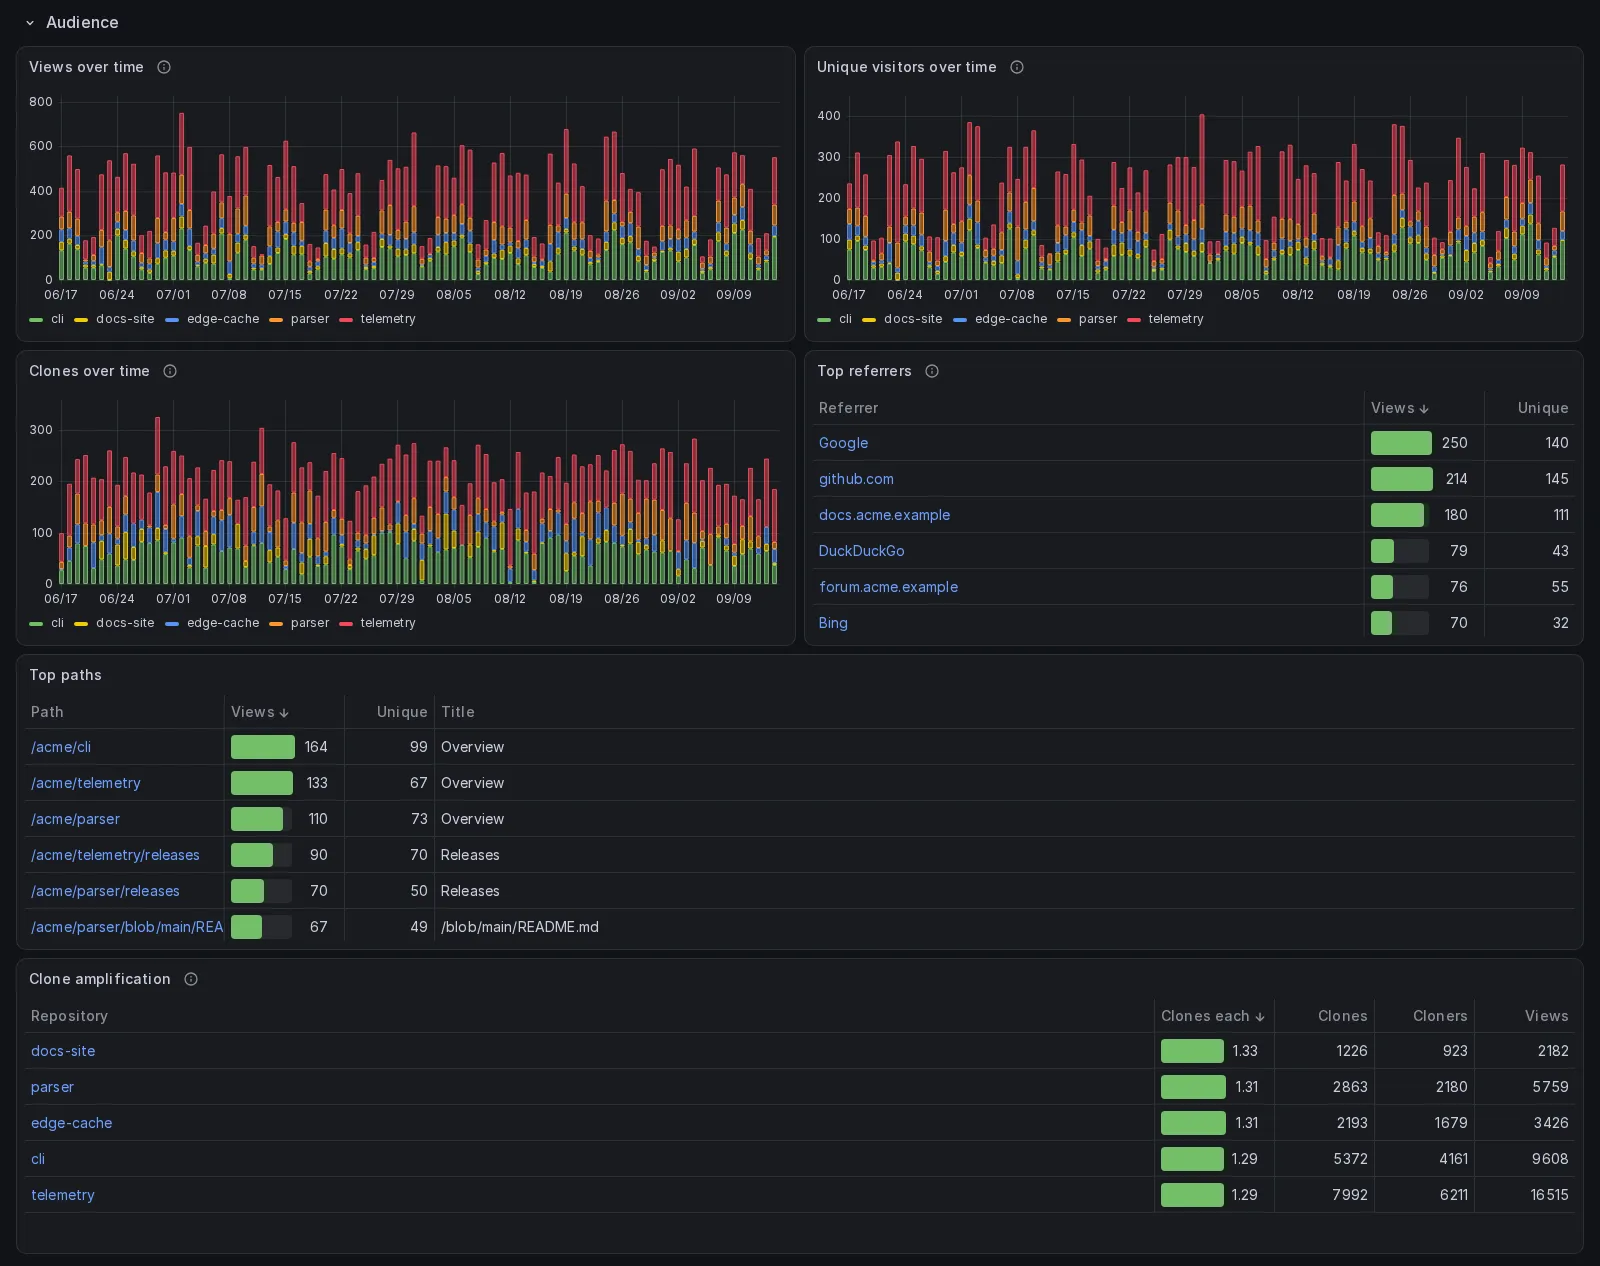
Sección titulada «Audience»Visitas, visitantes únicos y clones en el tiempo, los referrers y las rutas principales. GitHub sirve catorce días y reescribe la ventana entera en cada pasada, así que las series se extienden tan atrás como lleve corriendo el colector y no catorce días. Los referrers y las rutas no llevan fecha propia, de modo que son la instantánea más reciente de esa ventana y no una serie.
Lee gh_traffic, gh_traffic_referrer y gh_traffic_path.
Stars and forks
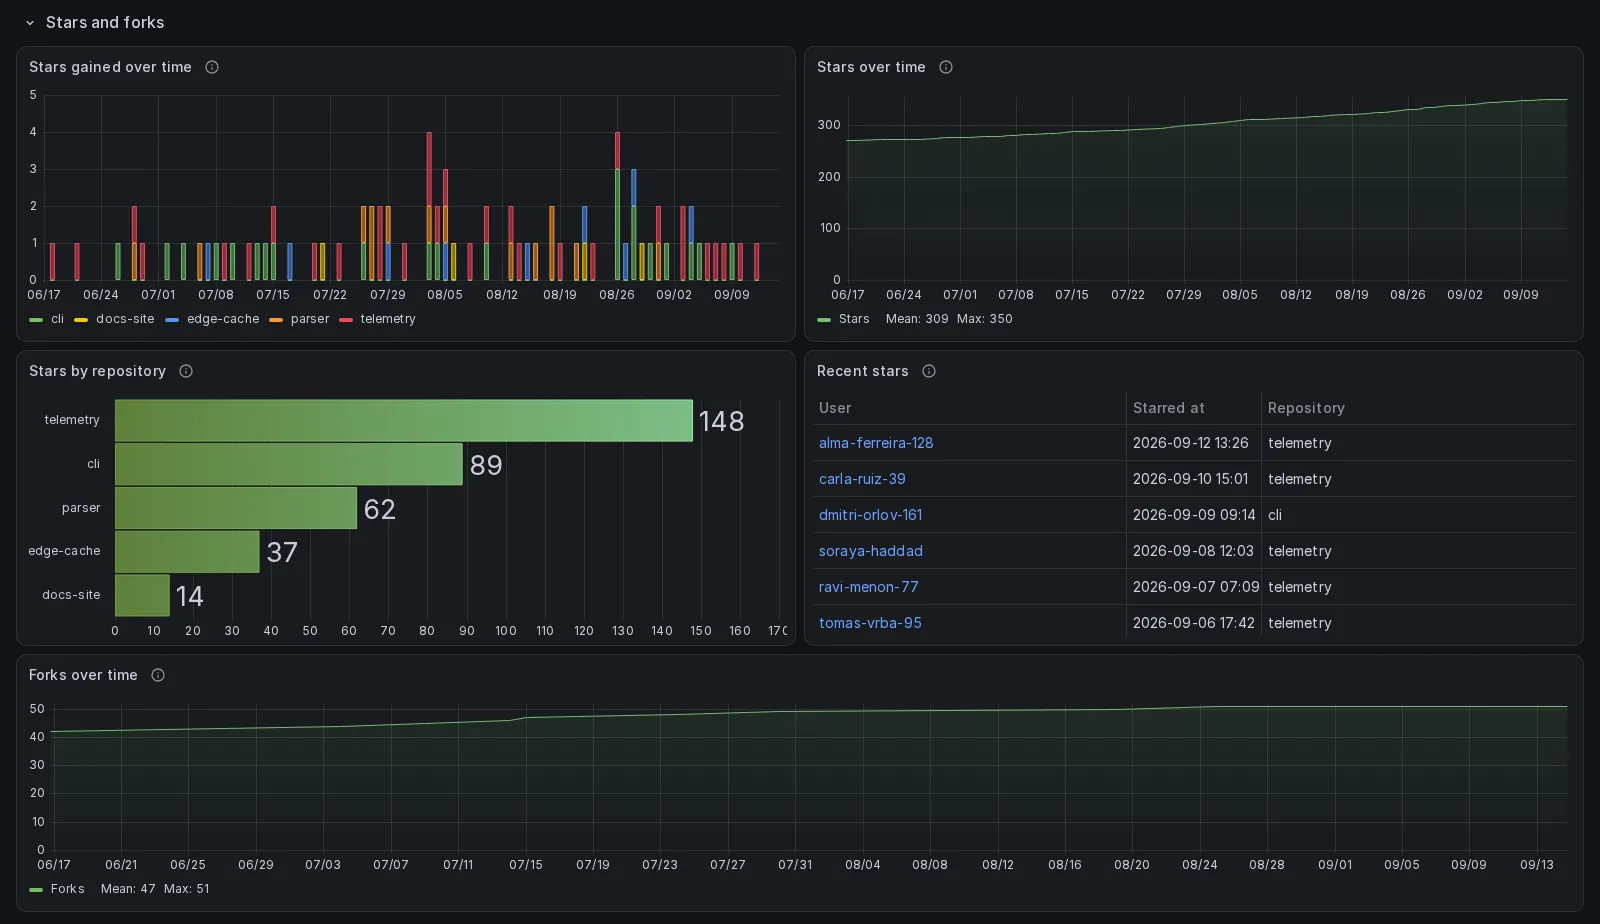
Sección titulada «Stars and forks»Estrellas ganadas en el tiempo, la curva acumulada, estrellas por repositorio,
las cincuenta estrellas más recientes con el usuario y el momento, y forks en el
tiempo. Se nombran los ocho repositorios que más ganaron en el rango y el resto
van a other: de los diecisiete que ganaron alguna estrella en dos años, nueve
ganaron entre una y tres, y diecisiete entradas de leyenda escondían un tercio
del trazado.
Stars gained over time cuenta gh_star_day, el historial diario de estrellas
de GitHub, y también la curva acumulada en InfluxDB y PostgreSQL; ghchronicle
lee el historial entero en la primera pasada para cada repositorio, salvo con
GitHub Enterprise Server, que no lo sirve. Así la curva se remonta a la primera estrella sin que el
colector lleve corriendo tanto tiempo, y un repositorio cuya lista de stargazers
GitHub oculta al token se cuenta con los demás: desde julio de 2026 GitHub solo
sirve esa lista a los
administradores y colaboradores
del repositorio, y el historial a cualquiera que pueda ver el repositorio. Cada
día es el día natural del Pacífico de GitHub, así que una estrella dada una
mañana europea puede quedar un día antes del momento que muestra Recent stars, y
quitar una estrella dada en las últimas treinta semanas la saca del día en que
se dio. La curva suele quedar en el número que muestra GitHub o un poco por
debajo, ya que ese número también cuenta cuentas que GitHub ya no lista, pero
una estrella dada hace más de treinta semanas y retirada después puede seguir en
ella, así que también puede quedar por encima: solo un backfill que llegue hasta
su día rebaja ese día, y solo mientras el día conserve otra estrella. Recent
stars nombra a personas, así que lee gh_star, y un repositorio cuya lista está
oculta tiene sus estrellas en los dos paneles de encima y ningún nombre ahí.
Prometheus sigue contando Stars gained y Recent stars desde la lista de
stargazers, así que solo donde el token puede leerla, mientras que su Stars over
time es el número actual de cada repositorio; en Graphite y Elasticsearch la
curva es el número de estrellas de los repositorios tal como lo leyó cada
pasada, y empieza el día en que arrancó el colector.
Los forks en el tiempo son también un recuento acumulado en InfluxDB y
PostgreSQL, desde gh_fork, cada fork con la fecha en que se hizo, así que
también se remontan más allá del día en que arrancó el colector en vez de
empezar en la primera instantánea. Los otros tres dibujan el número de forks
que leyó cada pasada, desde el día en que arrancó el colector o el exportador. Las dos
curvas se dibujan hasta los dos bordes del rango: un recuento acumulado sobre
filas fechadas solo tiene punto donde hay fila, así que una curva de forks sobre
un mes tranquilo era una línea del primer fork al último y nada a los lados, lo
que se lee como que la recogida se paró. Cada extremo lleva un bucket de cero,
así que la línea mantiene su valor hasta el final del rango.
Lee gh_star_day, gh_star, gh_fork y gh_repo.
Contributions
Sección titulada «Contributions»El calendario de contribuciones como serie y después como la rejilla que dibuja GitHub, una columna por semana y una fila por día de la semana, con el tono de cada celda en función del recuento de ese mismo día; commits por semana, los totales del último año y la mezcla que forman esos totales, los cuatro tipos de contribución como partes de su suma, que es el radar que dibuja el perfil, al lado de la rejilla como lo pone el perfil; commits por hora del día y por día de la semana, commits por repositorio y una fila por cada año pasado. La rejilla es un panel de historial de estado sobre un campo por día de la semana, porque Grafana no tiene panel de calendario y ese es el único panel del núcleo que dibuja una rejilla de celdas coloreadas por valor. Es la rejilla de GitHub medida en la página del perfil el 2026-09-14 y copiada: diez unidades de ancho por cinco dibujan la celda del propio perfil, diez píxeles en cuadro en una ventana de 1920, con una separación de tres a cuatro píxeles a lo ancho y de cinco a seis a lo alto, donde la del perfil son tres en ambos ejes; los cuatro verdes son los del tema oscuro de GitHub leídos de esa misma página ese mismo día, sobre el gris de un día vacío; tres filas llevan nombre, lunes, miércoles y viernes, como las nombra el perfil; y el tono son los quintos del día más activo del año, la regla que reprodujo los 366 cuadrados del perfil al aplicarla a los recuentos del propio GitHub. El panel mantiene ese año sea cual sea el rango del dashboard, igual que la rejilla del perfil es siempre de un año: a cinco años esas mismas 53 columnas serían 262 de seis píxeles, y a una semana, dos barras. Tres cosas que un panel del núcleo de Grafana no puede copiar. El nombre del mes sobre la primera semana de cada mes: un historial de estado construye sus propias marcas del eje x, una cada varias columnas, así que una marca siempre cae en una semana y el paso depende del ancho en píxeles del panel, que a tres semanas escribe el mismo mes dos veces; en su lugar las marcas nombran el domingo en que empieza cada columna, que no se repite en ninguna otra. El cuadrado a cualquier tamaño: la celda es una fracción de la banda que recibe su fila, así que el cuadrado aguanta a 1920 y otra vez a 768, donde el panel ocupa todo el ancho de un teléfono, y entre medias se mantienen los diez píxeles de alto mientras el ancho se estrecha, ocho a 1600, siete a 1280, cinco a 430; y donde el panel está en el dashboard se estira hasta una barra alta al maximizarlo, 27 por 67 píxeles en una ventana de 1920 por 900 y 27 por 84 en una más alta. Y un tooltip que diga el día y el recuento, porque la celda se colorea por el valor que lleva, así que ese valor tiene que ser el tono y una columna es una semana. Los dos punch cards son estado actual y no historia: cada pasada reescribe la rejilla entera, un punto por día de la semana y hora, así que una suma sobre un rango contaría todas las pasadas. Cada panel suma todas las celdas de la rejilla más reciente de cada repositorio en el rango, por hora o por día de la semana, y lo que se lee en esos paneles es la forma. Graphite guarda cada celda como una serie propia, así que una celda que un historial reescrito dejó vacía mantiene allí su última cuenta, donde los almacenes SQL y Elasticsearch leen solo la rejilla más reciente.
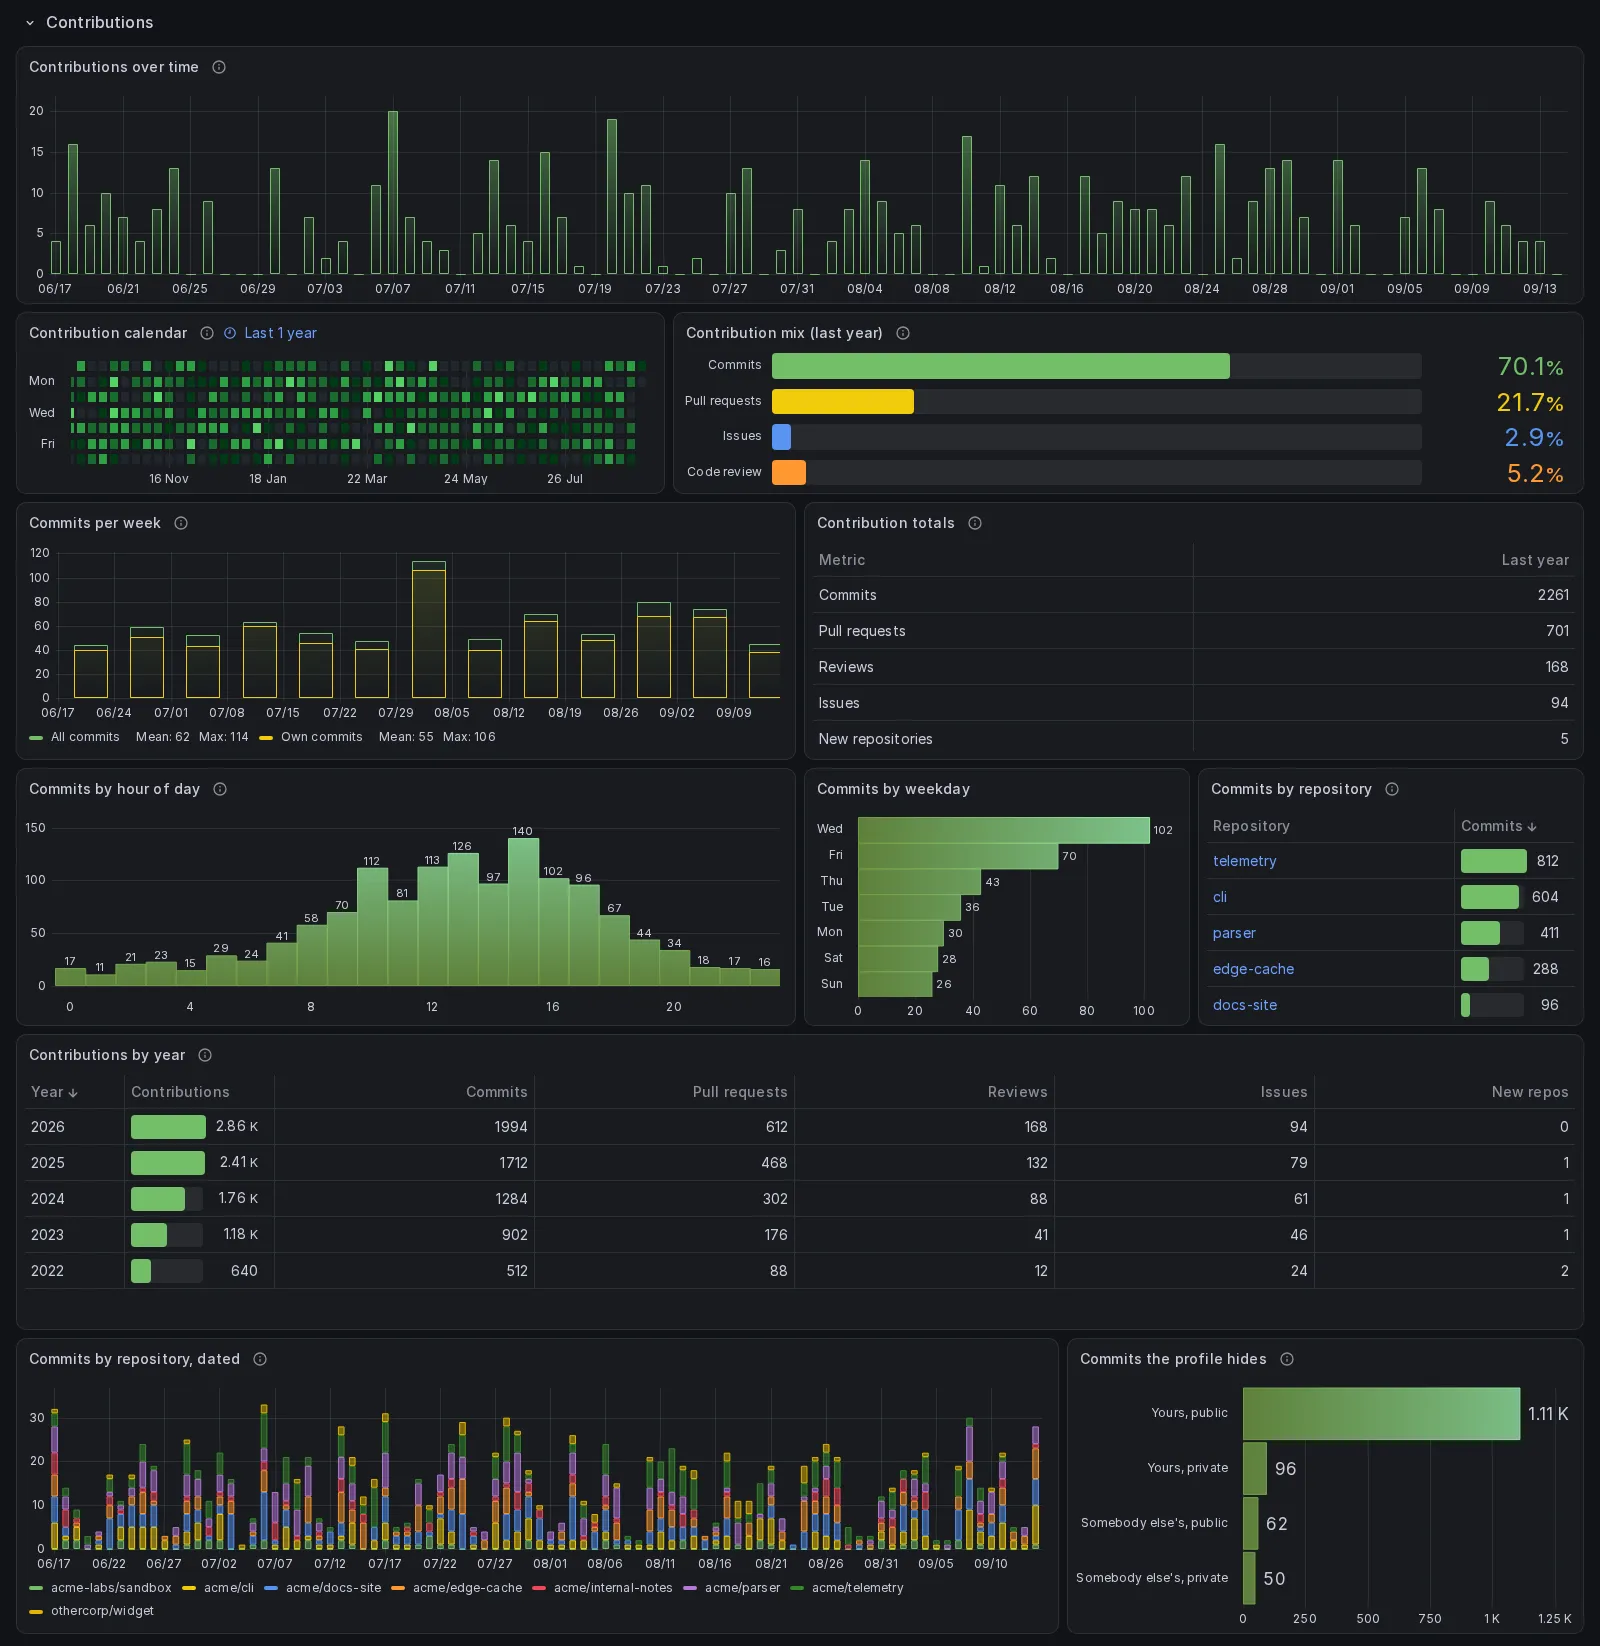
Lee gh_contribution_day, gh_contribution_day_repo, gh_commits_week,
gh_contributions_total, gh_commit_punchcard, gh_contribution_repo y
gh_contribution_year.
Pull requests and issues
Sección titulada «Pull requests and issues»Catorce paneles, y la sección donde la recolección por elemento se paga sola. Fusionados, tiempo hasta fusionar, tiempo hasta la revisión de otra persona, issues cerrados, tiempo hasta cerrar y líneas cambiadas como un grupo de seis valores; luego el mismo reparto por estado en el tiempo, las pull requests fusionadas más grandes y los desgloses por autor, por repositorio y por revisor. Un elemento que sigue abierto se escribe una vez al día mientras lo esté, y esas filas se quedan cuando se cierra, así que los paneles fechados cuentan los abiertos como números distintos bajo “Open that day” y los dibujan como una línea junto a la pila de lo que se cerró, y las tablas de “open the longest” leen cada elemento de su fila más reciente. Cada una guarda los veinticinco que llevan más tiempo abiertos, el más antiguo primero; Prometheus, que no guarda ninguna pull request suelta, lista los veinticinco repositorios cuyas pull requests abiertas llevan más tiempo esperando de media. Elasticsearch solo puede quedarse con los valores de arriba dentro del bucket de cada repositorio, así que guarda los que llevan más tiempo abiertos en cada uno y la tabla los corta a veinticinco; antes de 2.6.1 guardaba los veinticinco de cada repositorio con más filas, que en un repositorio con más elementos abiertos podían ser cualesquiera.
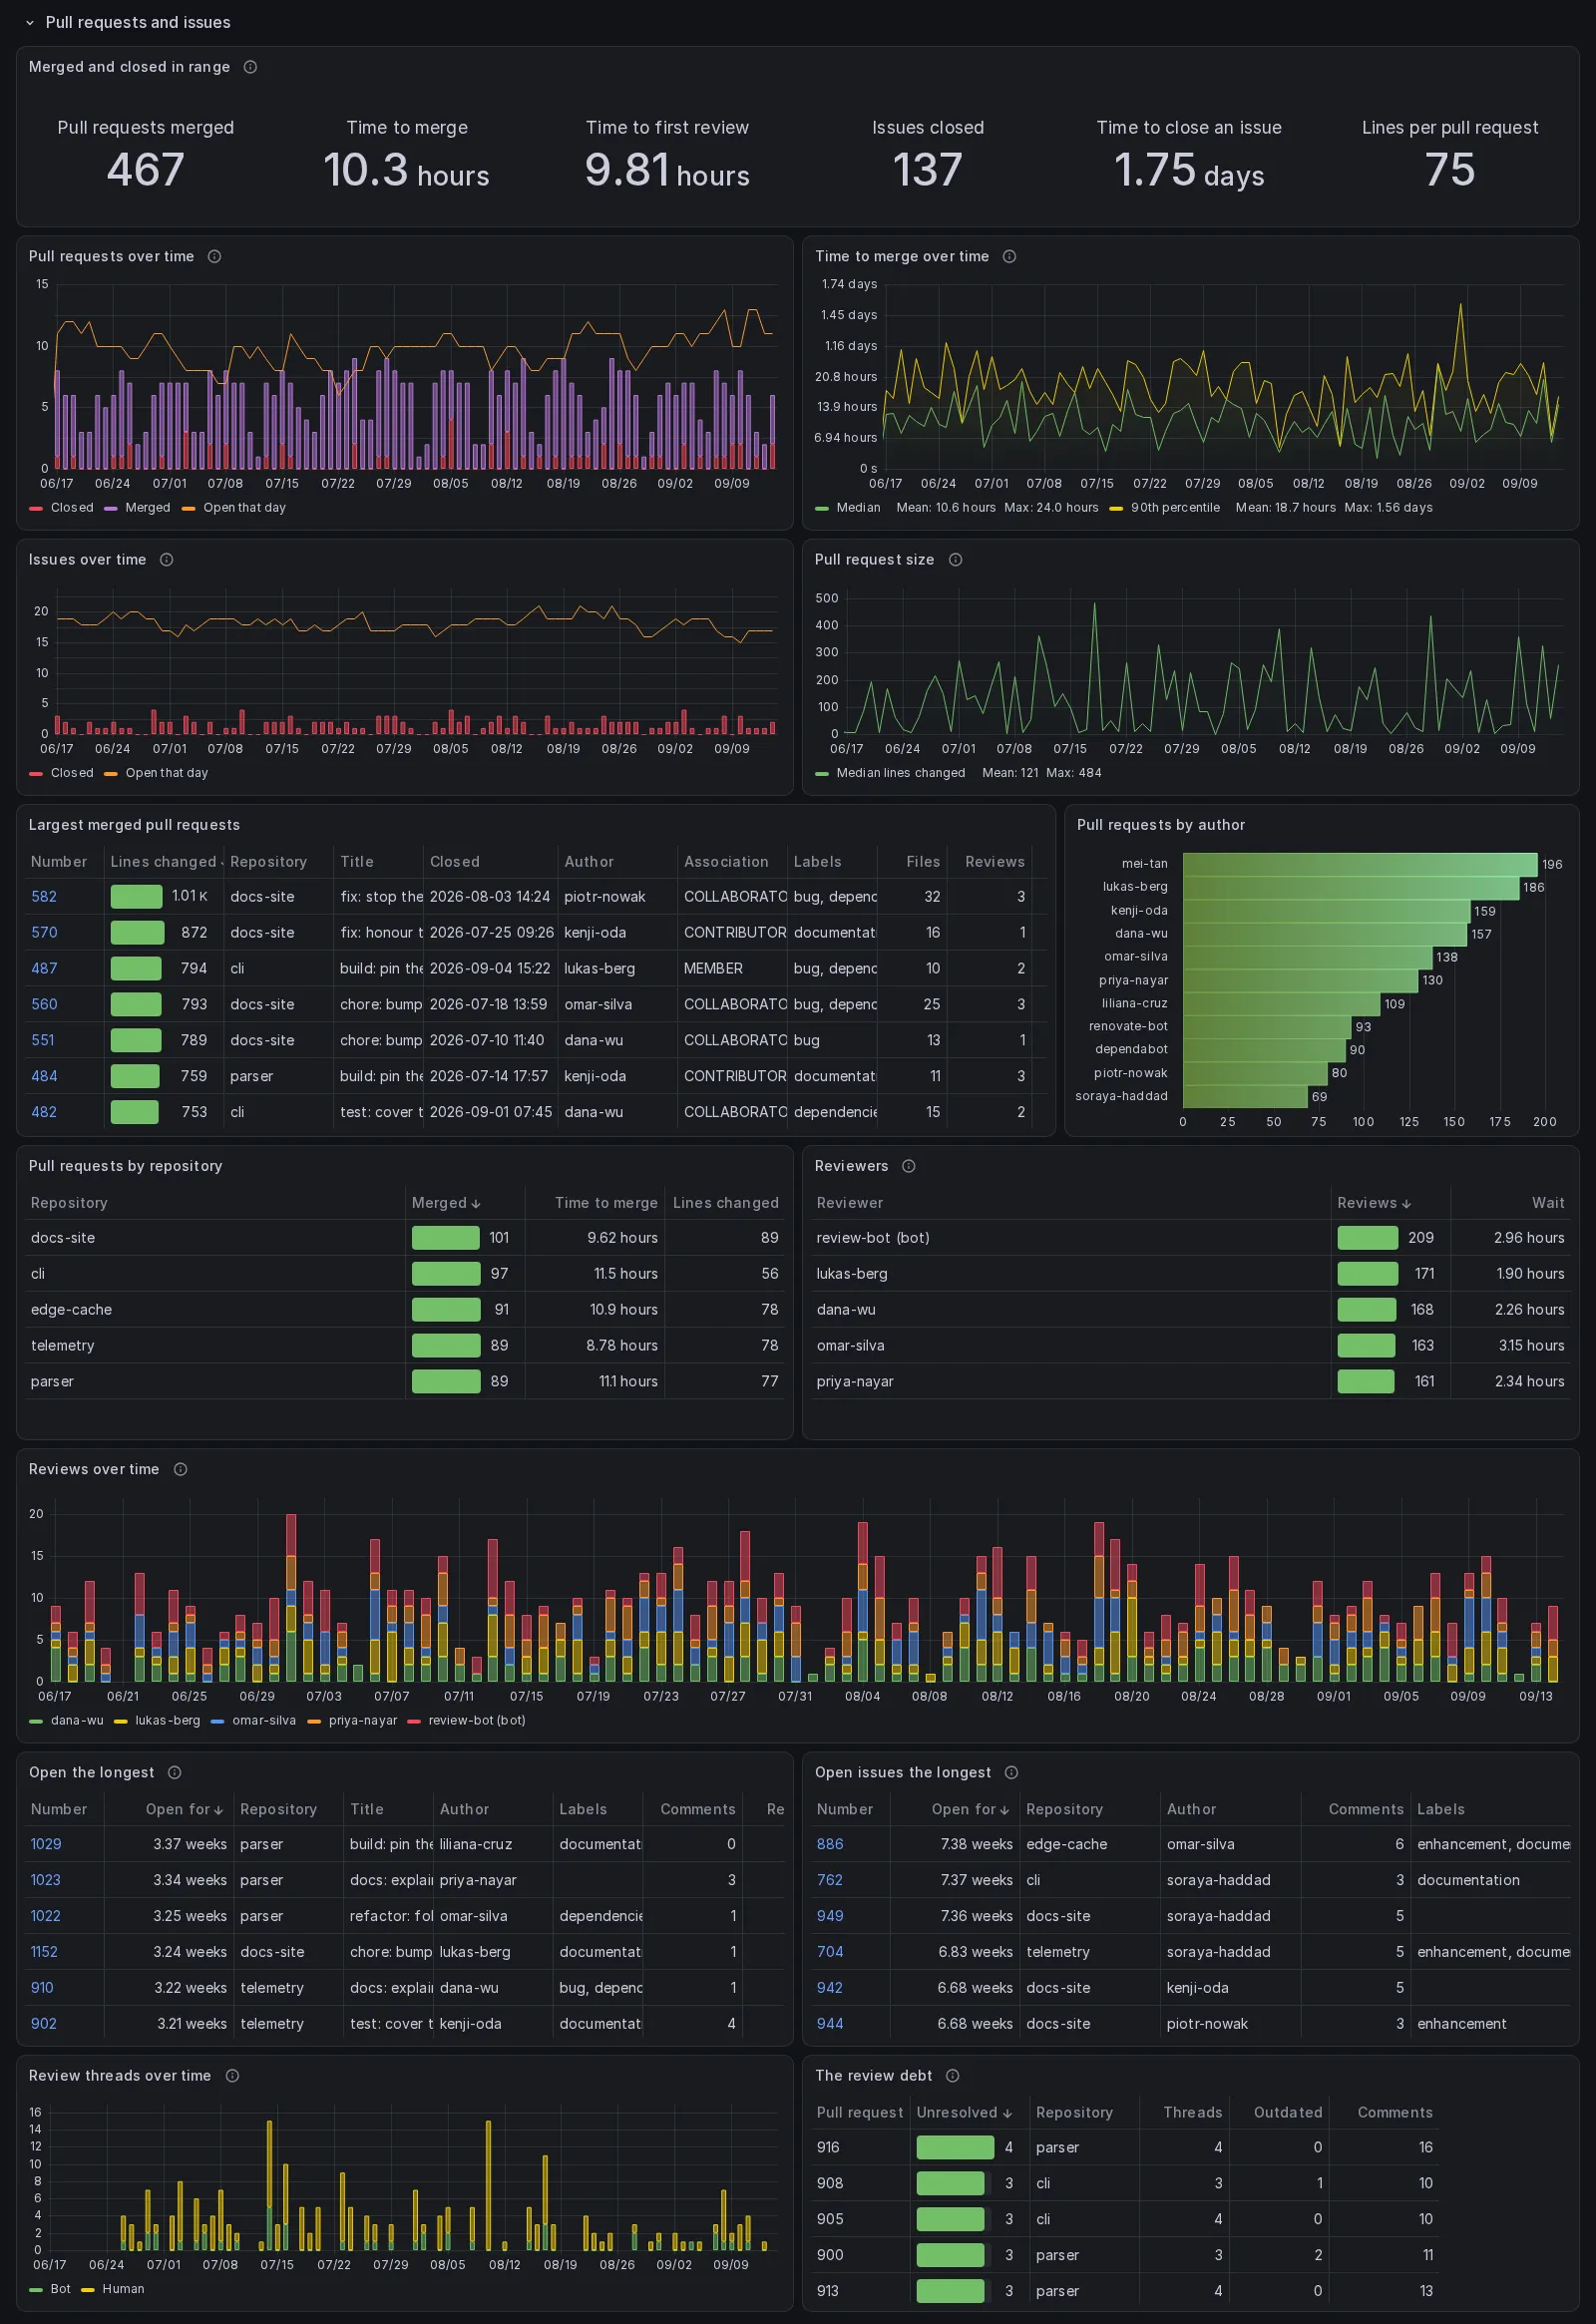
Lee gh_pull_request, gh_pull_request_review, gh_review_thread,
gh_issue y, para las marcas de archivado y de fork, gh_repo.
Continuous integration
Sección titulada «Continuous integration»Catorce paneles: número de ejecuciones, tasa de éxito sobre las ejecuciones que acabaron bien o mal, las canceladas y omitidas al lado, duración, espera en cola, almacenamiento de artefactos y tamaño de la caché, las siete como un solo grupo; luego las mismas cifras en el tiempo, los workflows, los jobs y los pasos más lentos, y luego los seis que dicen qué hacer al respecto: minutos gastados en ejecuciones que fallaron, los workflows que fallan siempre, el paso que falla en vez del job, los workflows declarados que nunca se han ejecutado, los artefactos creados en el tiempo y cuánto del almacenamiento de artefactos se llegó a contar.
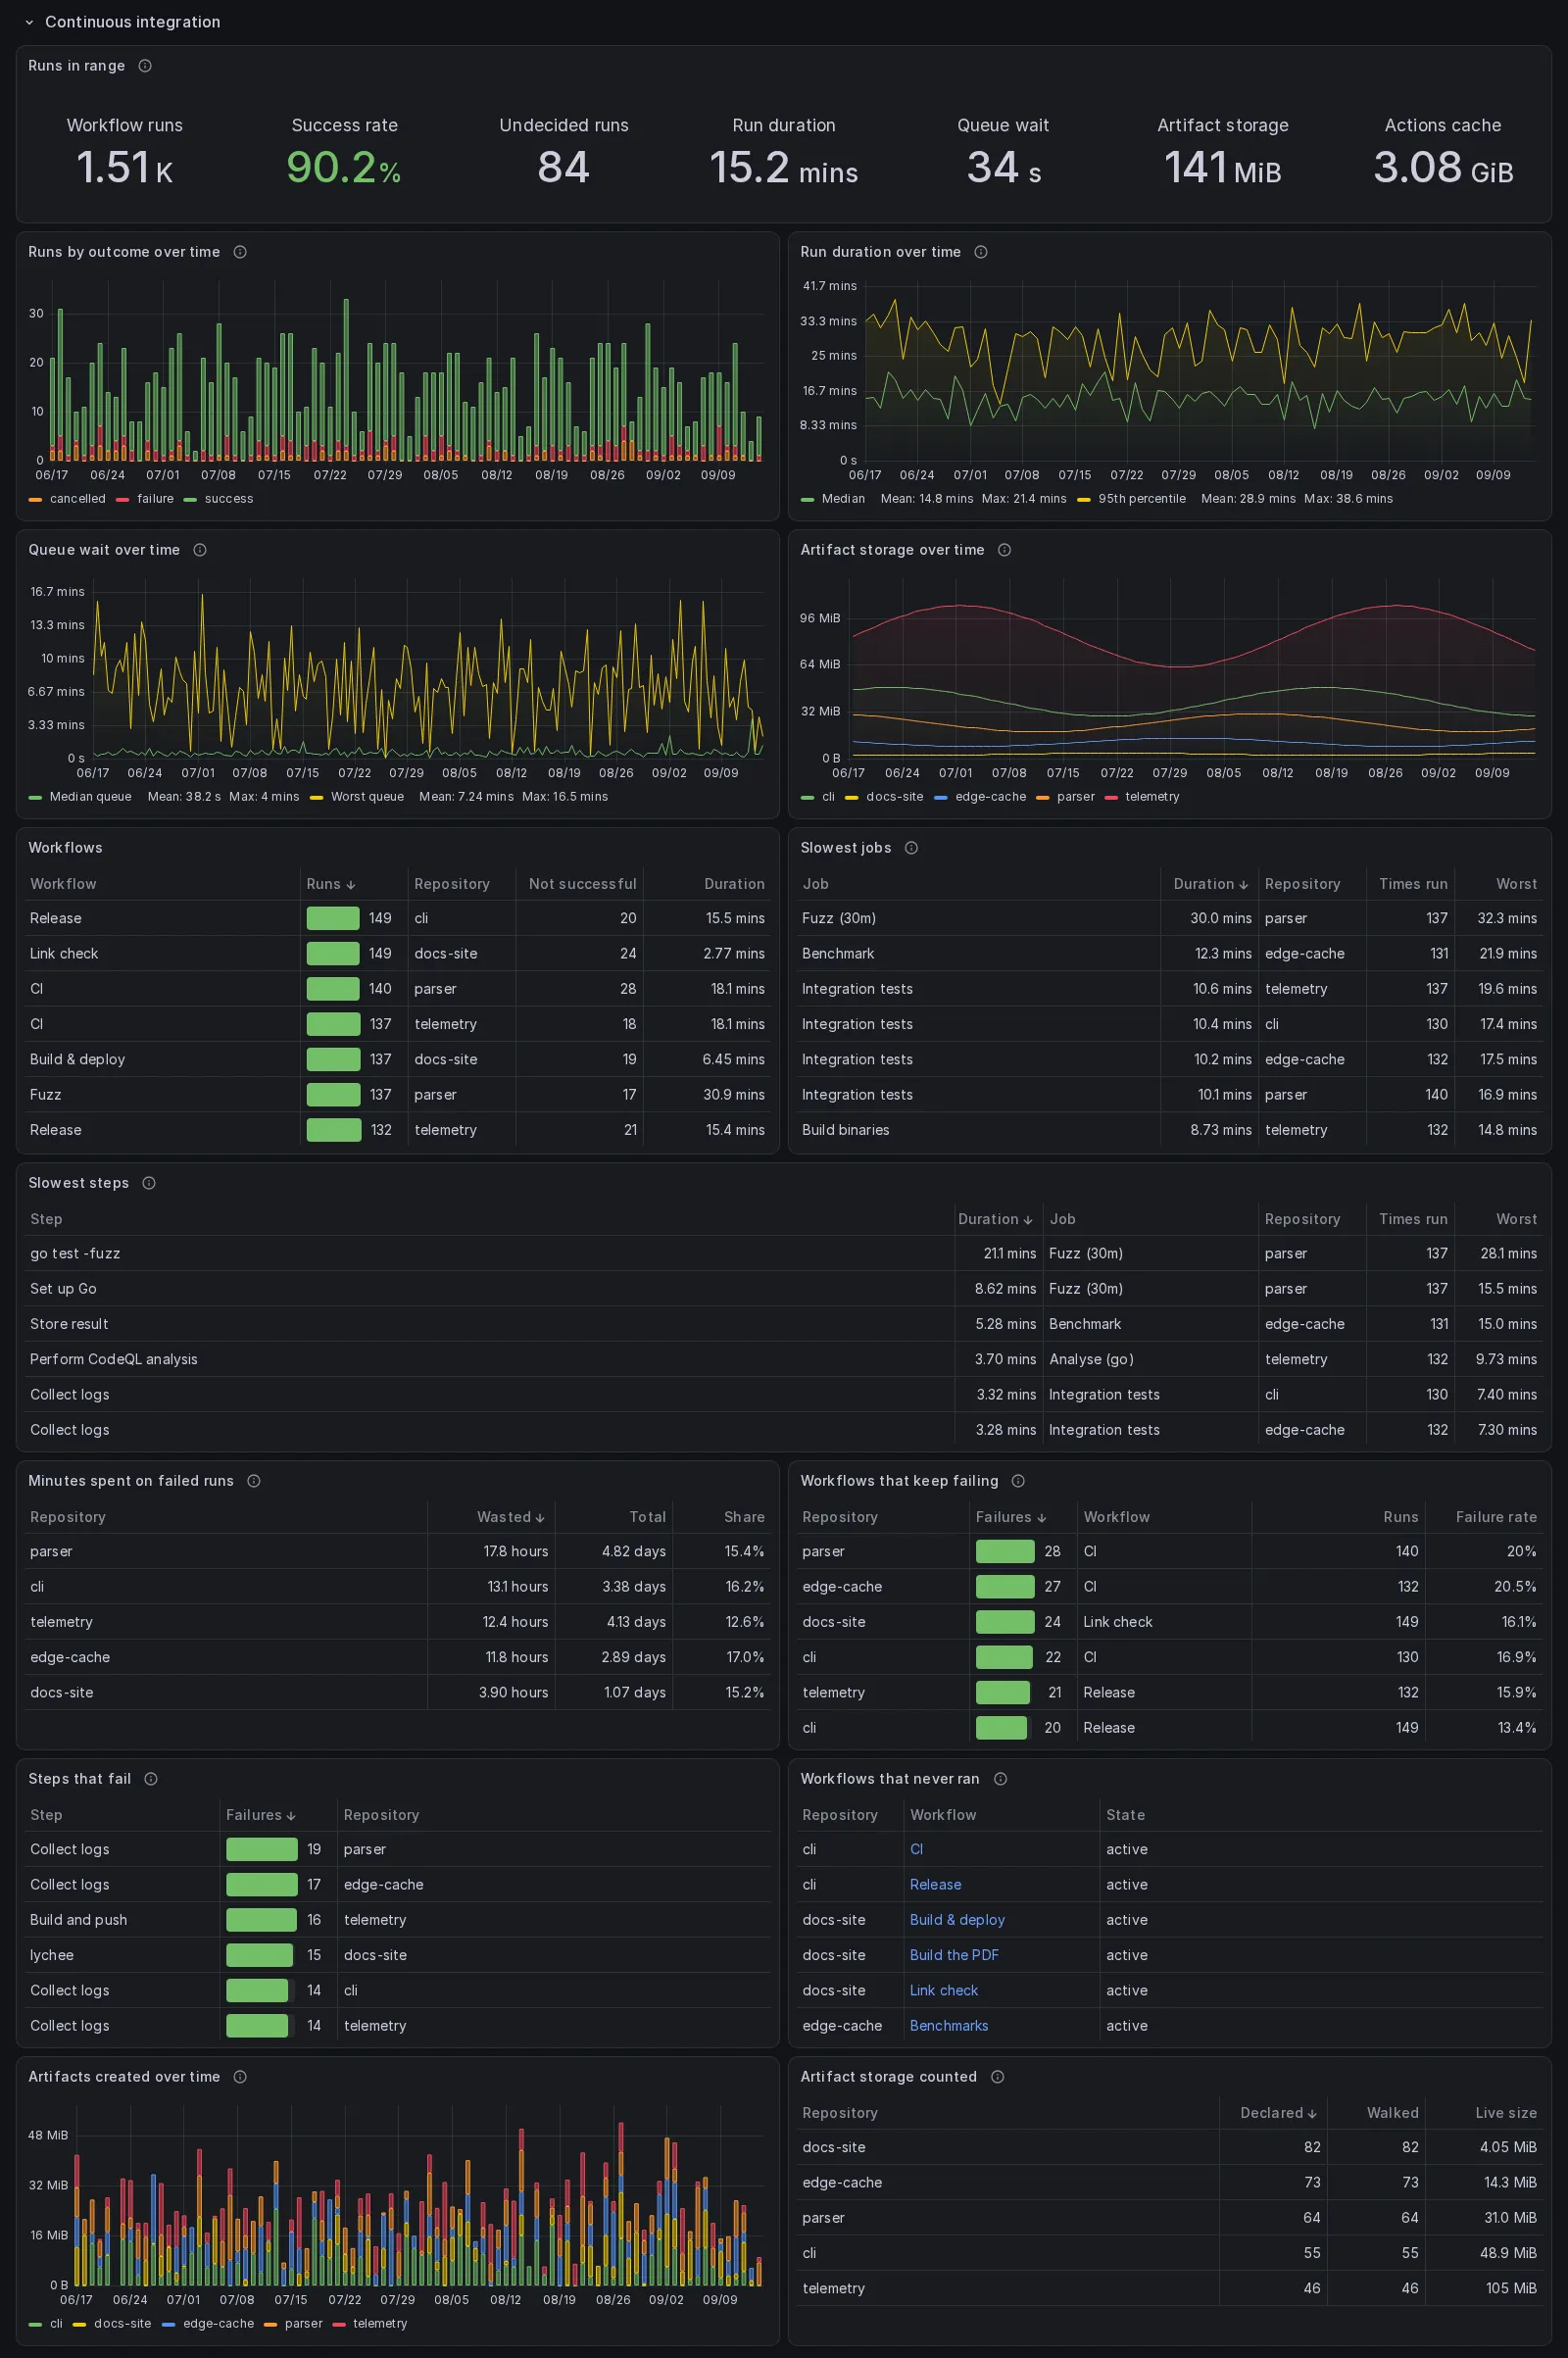
La espera en cola es una cifra de job. La de la ejecución mete la espera dentro de la duración, así que una ejecución que tardó veinte minutos porque un job esperó dieciocho por un runner es idéntica a una que pasó dieciocho ejecutando.
Toda mediana de los dashboards de InfluxDB y PostgreSQL es exacta, así que cuatro jobs que esperaron 30, 35, 60 y 65 segundos leen 47,5 en los dos, donde la estimación con la que respondía InfluxDB leía 52. El percentil 95 de la duración de las ejecuciones y el 90 del tiempo hasta la fusión siguen siendo estimaciones en InfluxDB, porque InfluxDB 3 Core no tiene un percentil exacto antes de la 3.9.0, y los dos paneles lo dicen.
Dos de ellos son los primeros que hay que mirar. “Workflows that keep failing”
no va de flakiness: medido, dos workflows habían fallado en todas y cada una de
sus ejecuciones, decenas de ejecuciones cada uno, y nadie los había apagado.
Lista un workflow en cuanto ha fallado más de tres veces en el rango, siendo un
fallo cualquier conclusión que no sea success, y los cinco almacenes hacen esa
misma pregunta.
“Workflows that never ran” es la otra cara de lo mismo, y necesita
gh_workflow y gh_workflow_run a la vez, que es por lo que es el único panel
aquí que solo pueden responder los dos almacenes SQL.
“Artifact storage counted” existe porque el total es un suelo. GitHub dice cuántos artefactos tiene un repositorio, el colector anota cuántos recorrió de verdad, y cuando el segundo es menor el tamaño vivo se queda corto: en un repositorio de aquí, por un factor de cincuenta y seis. El recorrido de una pasada se para en cinco páginas, quinientos artefactos, y cualquier recorrido se para antes cuando falla una página del listado y la pasada se queda con lo que había leído, así que cualquiera de las dos cosas puede dejarlo corto. Lleva una tercera cuenta, los artefactos vivos entre los recorridos, porque el total del propio GitHub incluye los que ya ha caducado y el tamaño no. Las cuentas salen de la fila más reciente de cada repositorio, la misma que lee la tarjeta, así que un recorrido más completo antes dentro del rango no puede tapar uno corto. La tarjeta del principio de la sección se llama por aquello sobre lo que está, y todo panel que enseña el tamaño enseña esas cuentas o dice en su descripción que es un suelo.
Lee gh_workflow_run, gh_workflow_job, gh_workflow_step, gh_workflow,
gh_artifact, gh_artifact_total, gh_actions_cache y, para las marcas de
archivado y de fork, gh_repo.
Commits, líneas añadidas y eliminadas, la proporción de commits firmados, líneas cambiadas en el tiempo, actividad del repositorio por tipo, commits por autor y por firma, y los force push con quién los hizo y en qué rama.
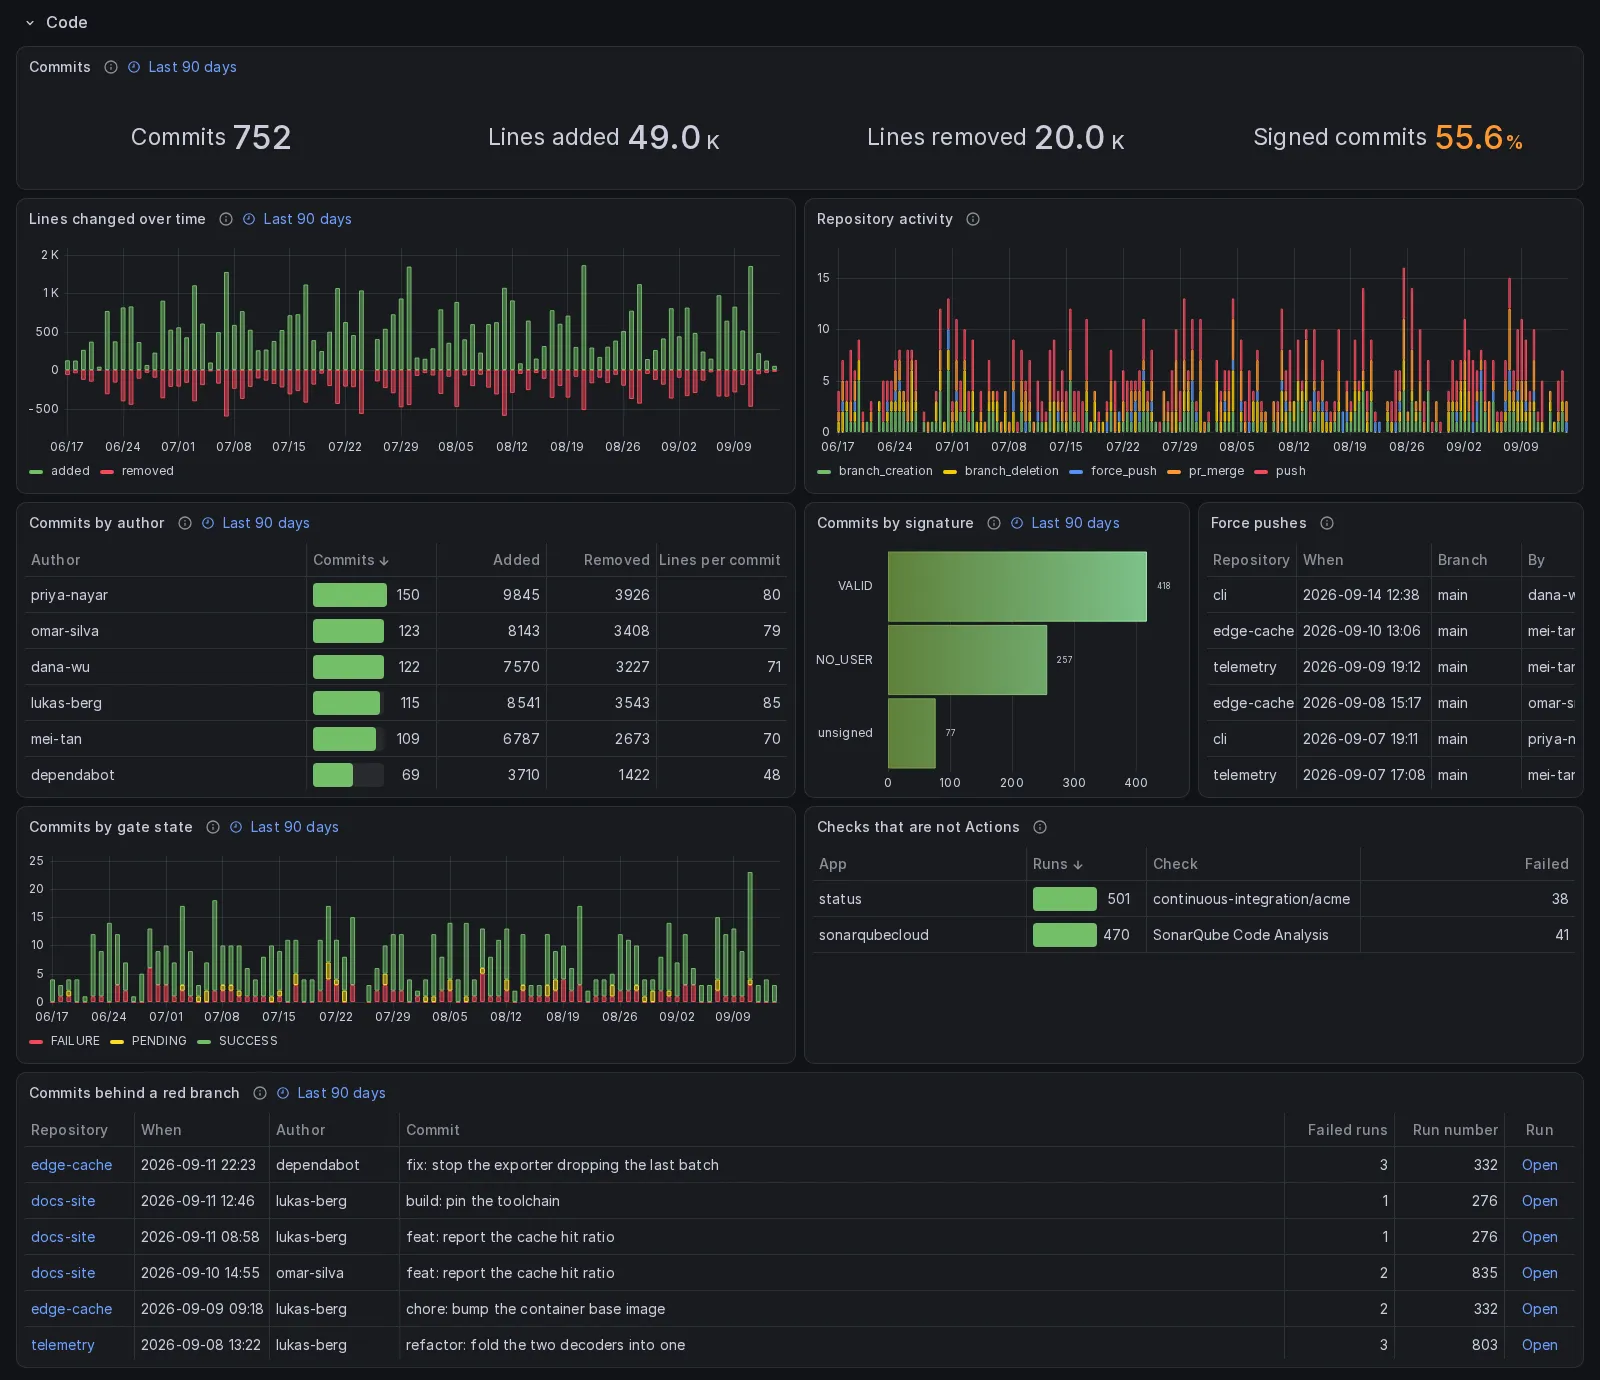
signature distingue unsigned, que significa que no había firma en absoluto,
de una firma que no se pudo verificar. Son hechos distintos y el gráfico de
barras los mantiene separados.
Los tres últimos paneles van de la puerta, no del código. “Commits by
gate state” no dice lo mismo que una ejecución fallida: una ejecución dice que
falló un job, el rollup dice que el commit salió en rojo, y en la cuenta medida
veintisiete de cincuenta commits de la rama principal salieron así. “Checks that
are not Actions” guarda lo que las dos secciones anteriores no ven, el servicio
de calidad de código y el bot de dependencias. Y “Commits behind a red branch”
une los dos por el hash del commit, que es el único panel que
justifica guardar oid y head_sha.
Lee gh_commit, gh_commit_check, gh_workflow_run y gh_repo_activity.
Planning and community
Sección titulada «Planning and community»Las etiquetas con cuánto se usa cada una, los hitos con su progreso, los forks ganados en el tiempo, la lista de forks, las discusiones por categoría y según estén respondidas o no, y junto a ese recuento las discusiones mismas: las cincuenta más recientes una a una, con su categoría, cuántos comentarios tienen, si están respondidas y un enlace a cada una, sea cual sea el rango, porque una cuenta tiene un puñado y un rango de un mes las escondía todas menos una bajo una fila que decía “Ideas”.
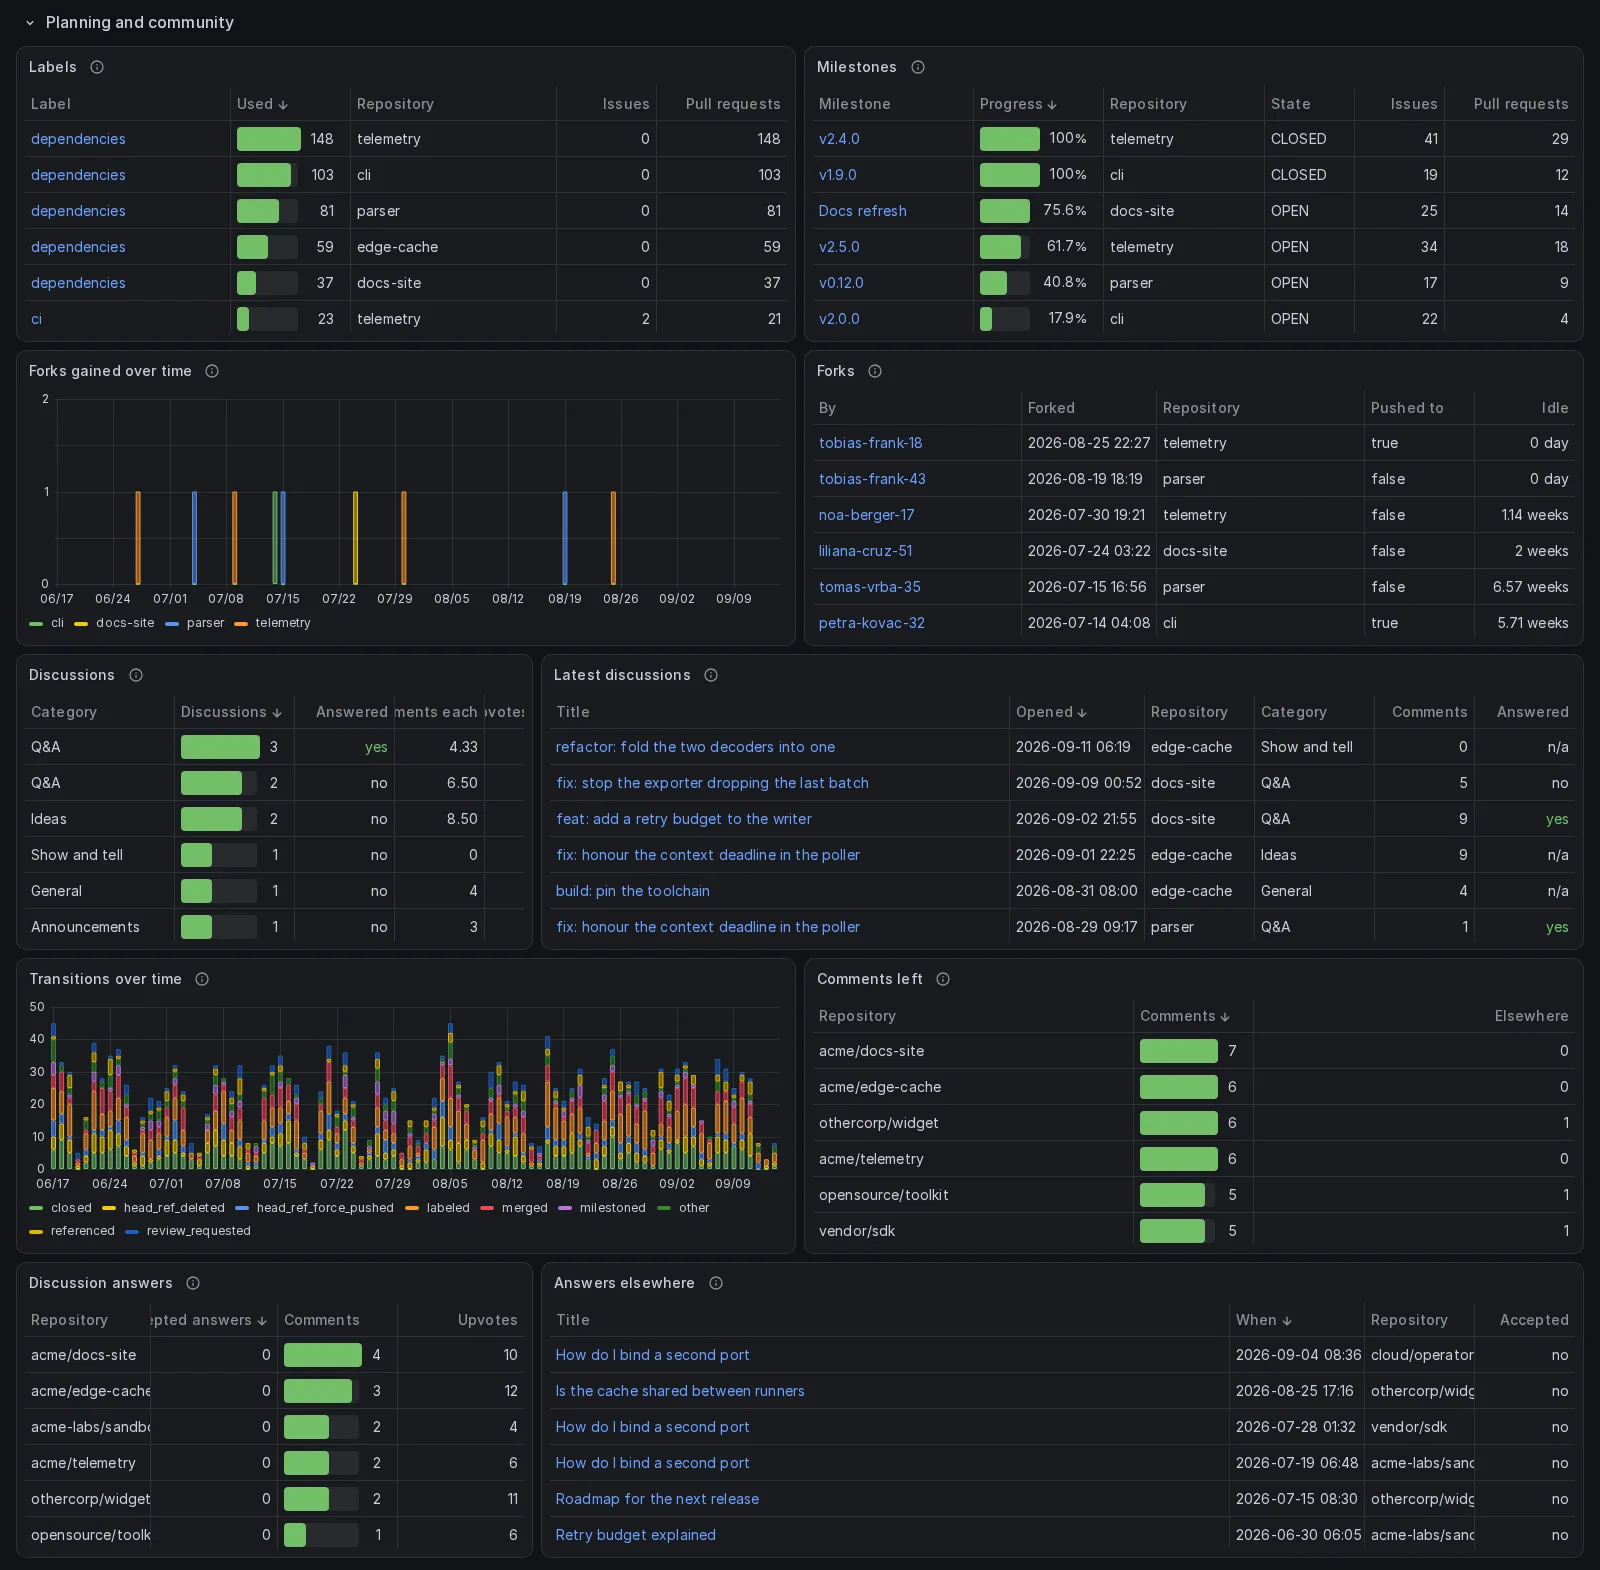
La lista de forks lleva advanced, que es lo que separa una derivación real de
un marcador. La mayoría de los forks son marcadores.
Otros tres paneles van de la conversación y no del plan. Las transiciones por día son cuándo se etiquetó, se cerró, se reabrió o se renombró algo, que el estado de una issue no registra: una reapertura no existe en ninguna otra medida. Las dos tablas de comentarios cuentan lo escrito en cualquier sitio, incluidos los repositorios que la cuenta no posee, que es donde ocurre casi todo: cuando se midió, los comentarios dejados en repositorios ajenos superaban en más de un orden de magnitud a las discusiones de dentro de la cuenta. Junto al recuento por repositorio de comentarios en discusiones, los comentarios mismos: cada uno dejado en una discusión de un repositorio ajeno, del más reciente al más antiguo, con si el mantenedor lo aceptó como respuesta y un enlace al comentario en su hilo. Las dos leen una fila por comentario en todos los almacenes, aceptado si cualquiera de sus filas lo dice, porque un almacén escrito antes de 2.6.1 y después puede guardar un comentario en más de una fila, por la razón que da Cómo leer las tablas.
Lee gh_label, gh_milestone, gh_fork, gh_discussion, gh_issue_event,
gh_issue_comment y gh_discussion_comment.
Delivery and access
Sección titulada «Delivery and access»La tasa de fallo de los webhooks, las entregas por código de estado, los endpoints ordenados por fallos, los rulesets y las claves de despliegue con cuánto tiempo llevan sin usarse. Debajo, los webhooks configurados, los entornos, las ramas estancadas, las reglas de protección de rama, las reglas de cada ruleset con quién puede saltárselas, cuándo cambió cada ruleset, y los despliegues en el tiempo y por entorno.
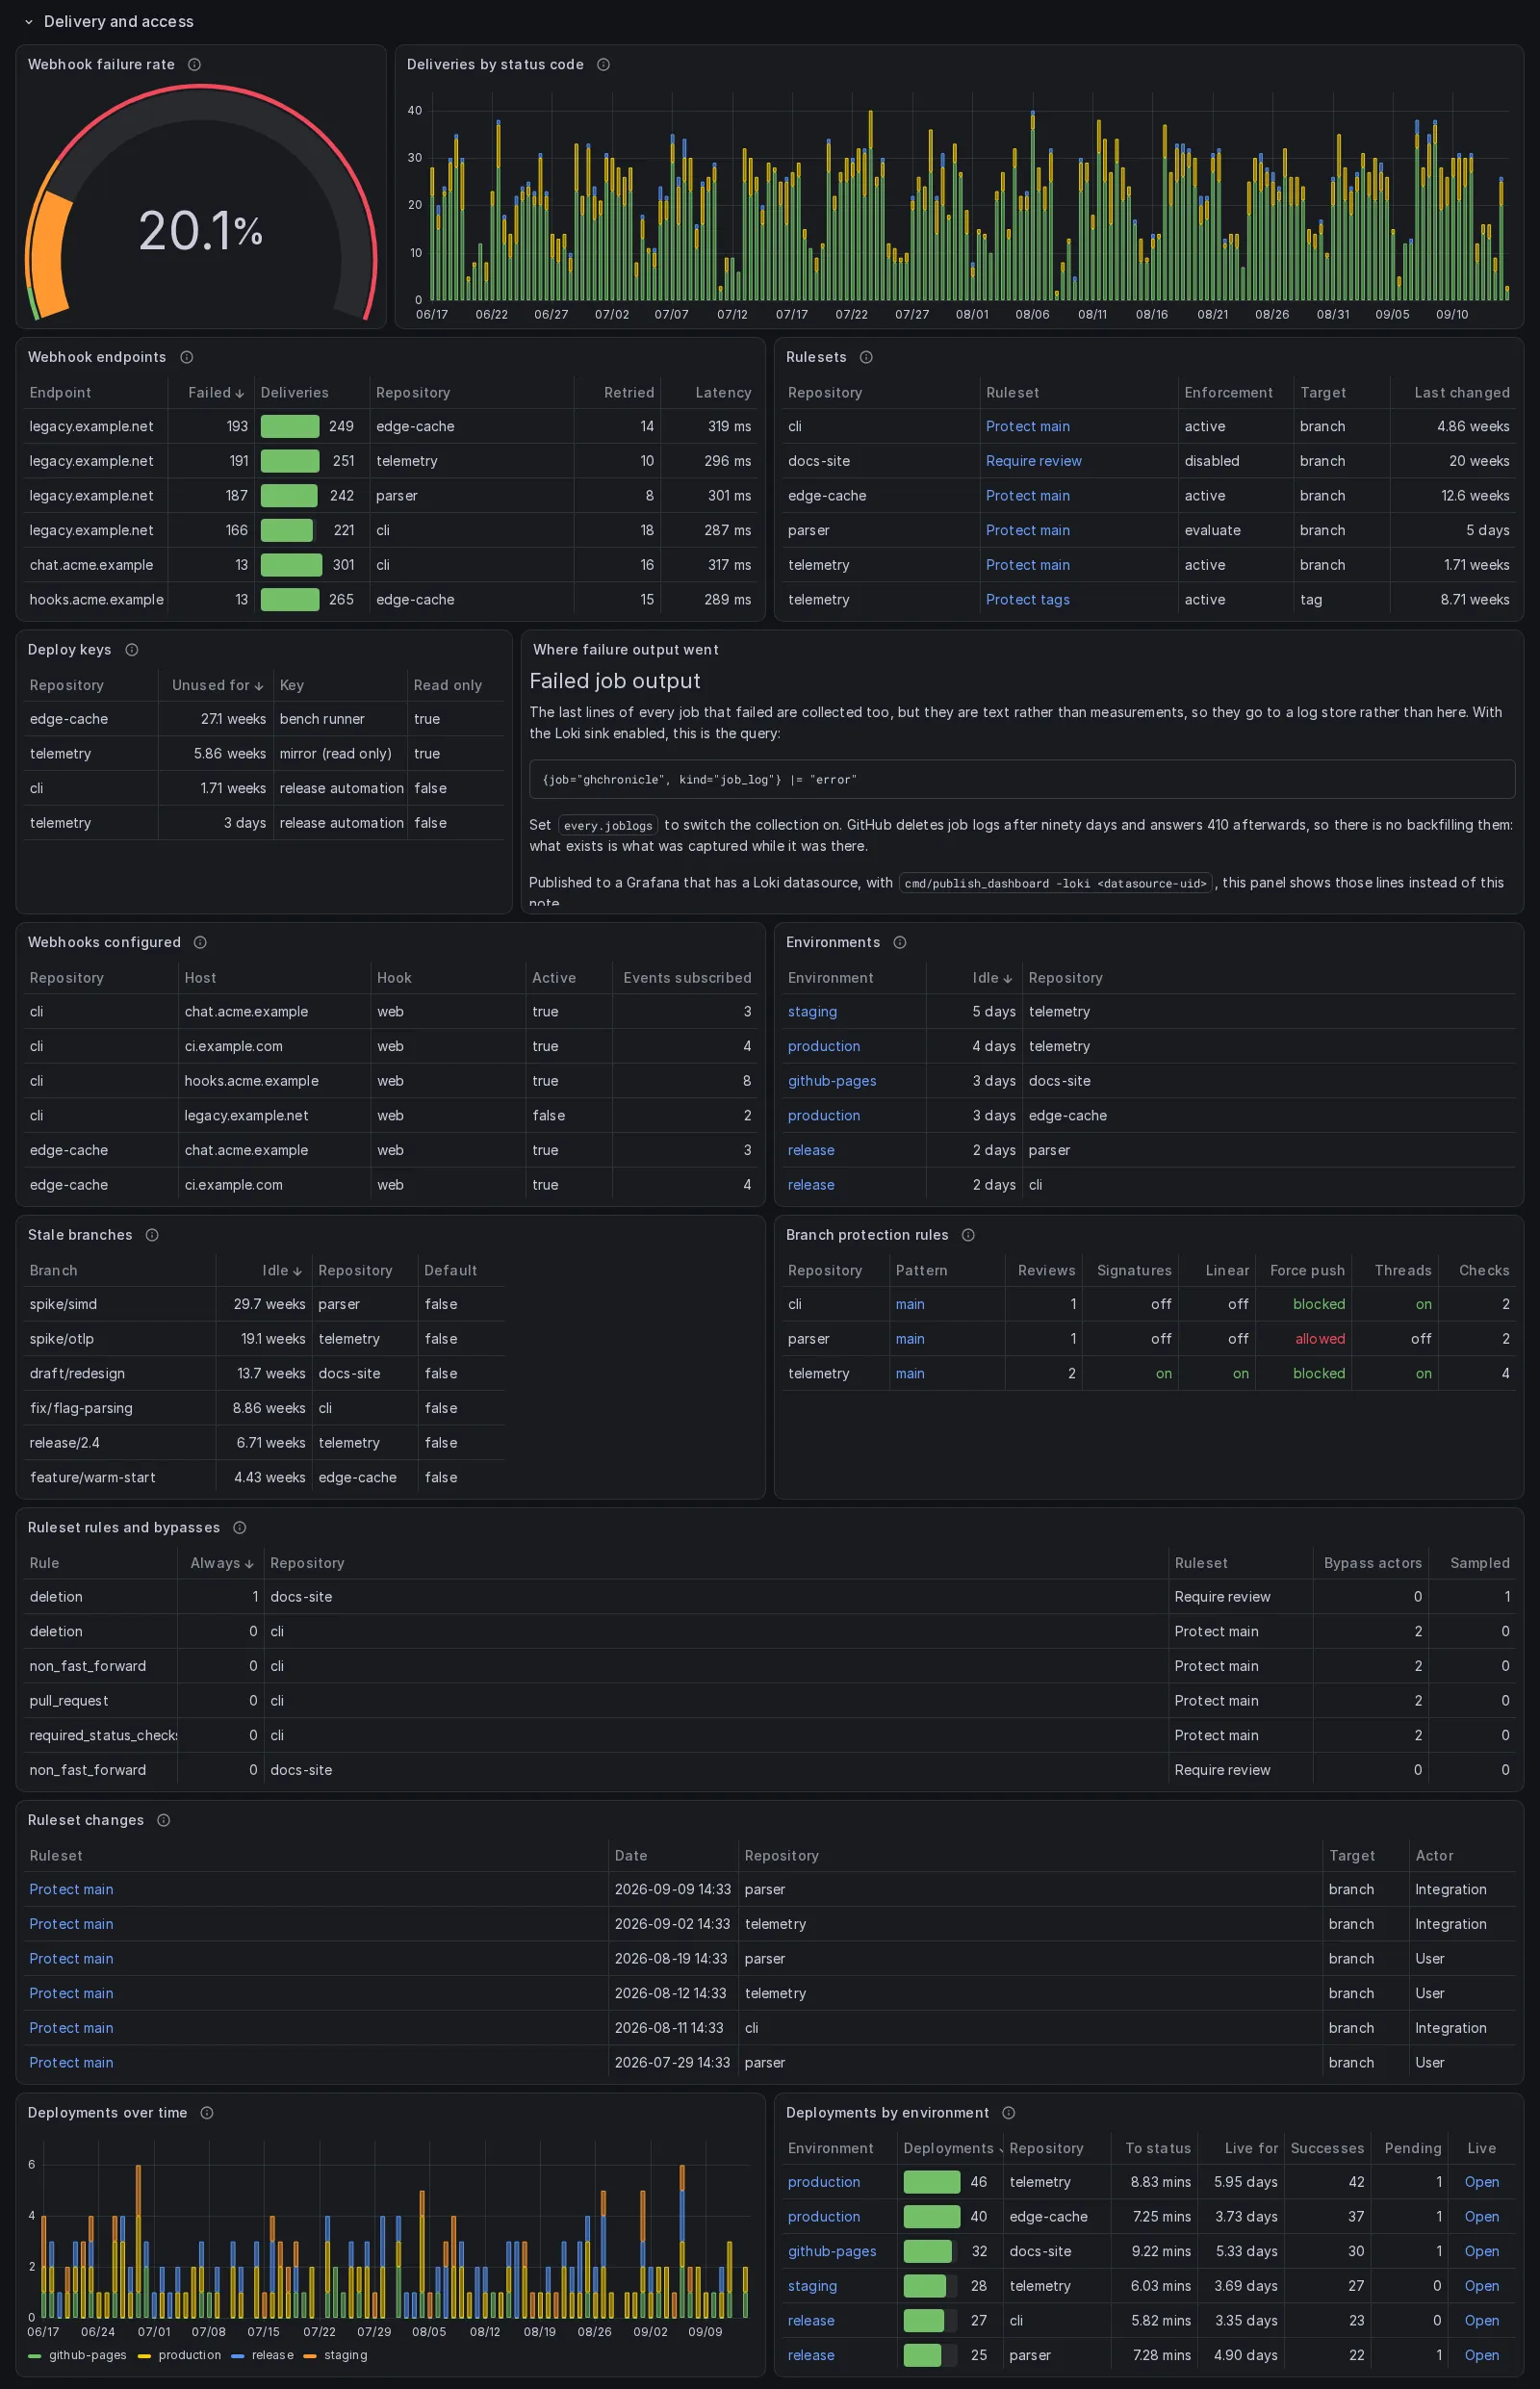
Los webhooks fallan en silencio. Medido, un hook llevaba respondiendo 403 en setenta y ocho de sus últimas cien entregas y no había nada en ninguna parte que lo dijera. Solo se guarda el host de la URL del webhook, porque la ruta suele llevar un secreto.
Un panel es texto en los ficheros exportados, “Where failure output went”,
porque la salida de un job fallido es texto y su sitio es un almacén de logs, y
quien importa el dashboard puede no tener ninguno: un dashboard atado a un solo
datasource no puede consultar dos. Publicado en un Grafana que sí tiene un
datasource de Loki, que el colector adopta o crea a partir de un sink de Loki o
toma de grafana.datasource.loki_uid, el mismo panel dibuja las últimas
líneas de cada job fallido leídas de Loki, las más recientes primero, con el
workflow, el job y la ejecución de cada línea en su cola logfmt. La variable de
repositorio se aplica en los dashboards de InfluxDB, PostgreSQL y Prometheus;
las variables de Graphite y Elasticsearch usan el asterisco de glob como valor
de “All”, que no es una expresión regular, así que allí el panel muestra todos
los repositorios y lo dice.
Los dos últimos son inventarios y no tráfico. “Webhooks configured” existe porque la tabla de endpoints se construye desde las entregas, así que un hook que nunca ha entregado nada no aparece en ella, y un hook activo sin tráfico es justo la fila interesante. “Environments” le hace la pregunta de las claves de despliegue a los destinos de despliegue: un entorno de aquí llevaba mil ciento setenta y siete días sin tocarse.
Lee gh_webhook_delivery, gh_webhook, gh_ruleset, gh_ruleset_rule,
gh_ruleset_version, gh_deploy_key, gh_environment, gh_branch,
gh_branch_protection, gh_deployment y, para las marcas de archivado y de
fork de las ramas estancadas, gh_repo.
Releases
Sección titulada «Releases»Descargas totales, descargas por release y cada asset con su tamaño y su propio recuento de descargas.
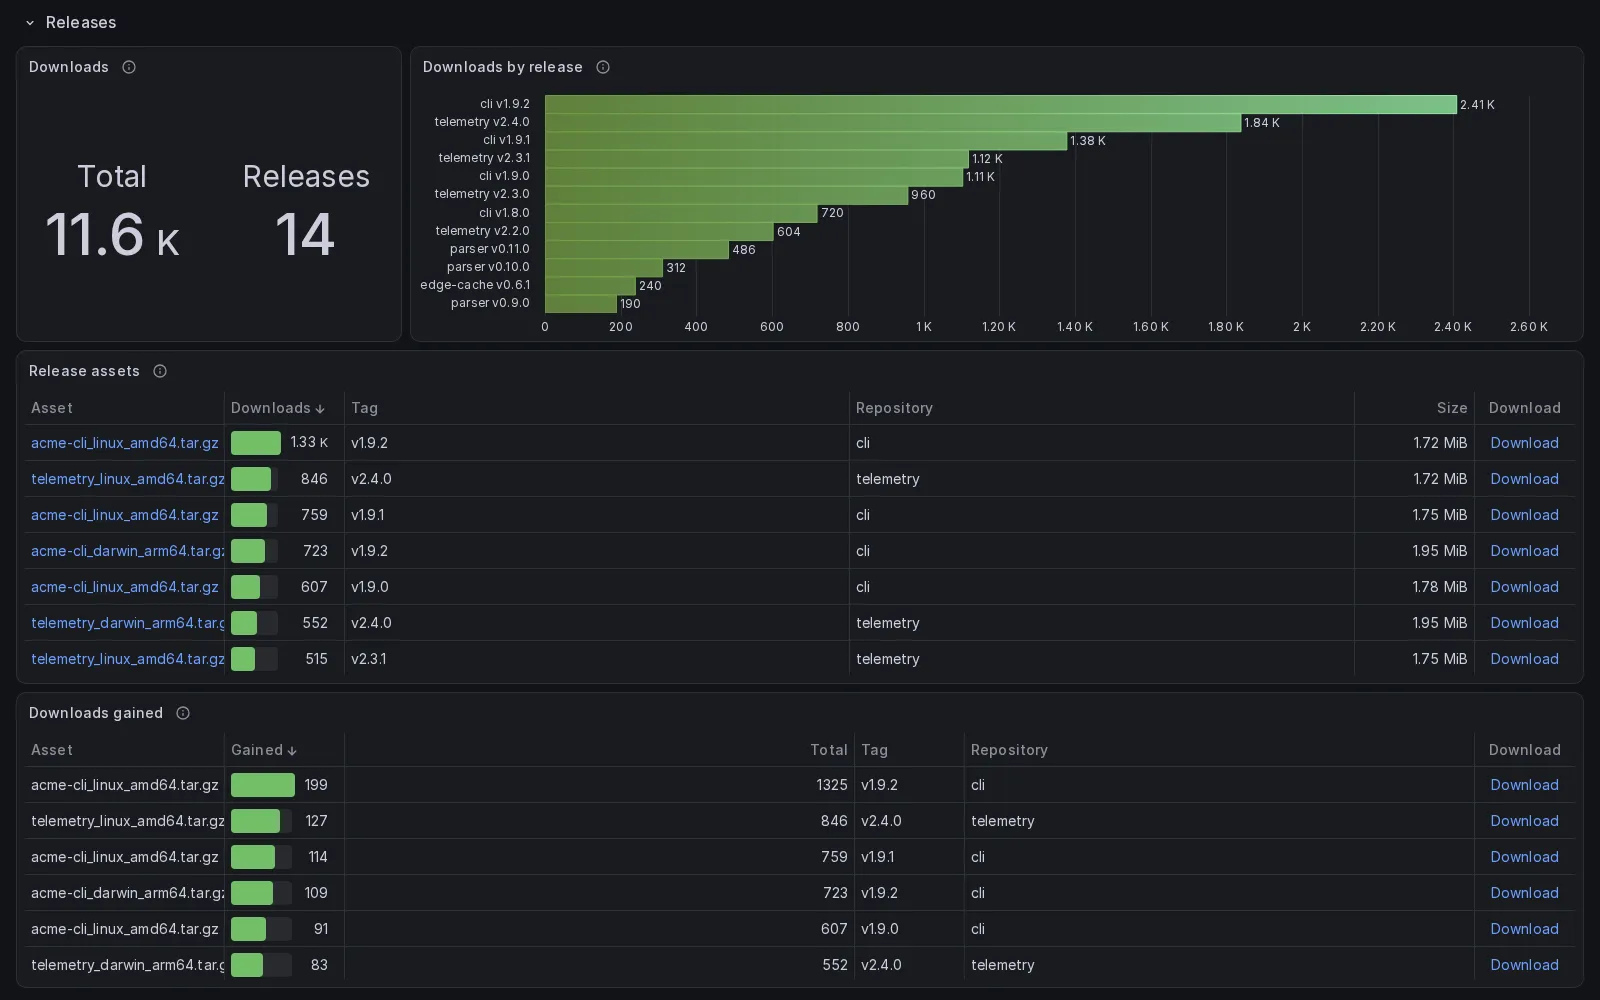
Los tres primeros son estado actual. GitHub da un total acumulado por asset y nunca una historia, así que la serie que necesitaría un panel de descargas por día no existe para recogerla. El cuarto panel es lo que sí se puede recuperar de ahí: la diferencia entre el primer y el último valor dentro del rango, que es lo que cada asset ganó de verdad. Un día de eso en la cuenta medida mostró que el noventa y siete por ciento de las descargas van a un único binario de Linux y a su fichero de checksums, que es un instalador y no una persona.
Lee gh_release y gh_release_asset.
Security
Sección titulada «Security»Alertas abiertas de Dependabot y de code scanning, los desgloses por severidad y por ecosistema, las alertas abiertas en el tiempo, la tabla de funciones y el tiempo que se tarda en resolver una alerta según su severidad. Debajo, las alertas abiertas más antiguas, los ajustes de seguridad, la configuración por defecto de code scanning, los permisos del token de los workflows y los secretos con cuándo se rotó cada uno por última vez.
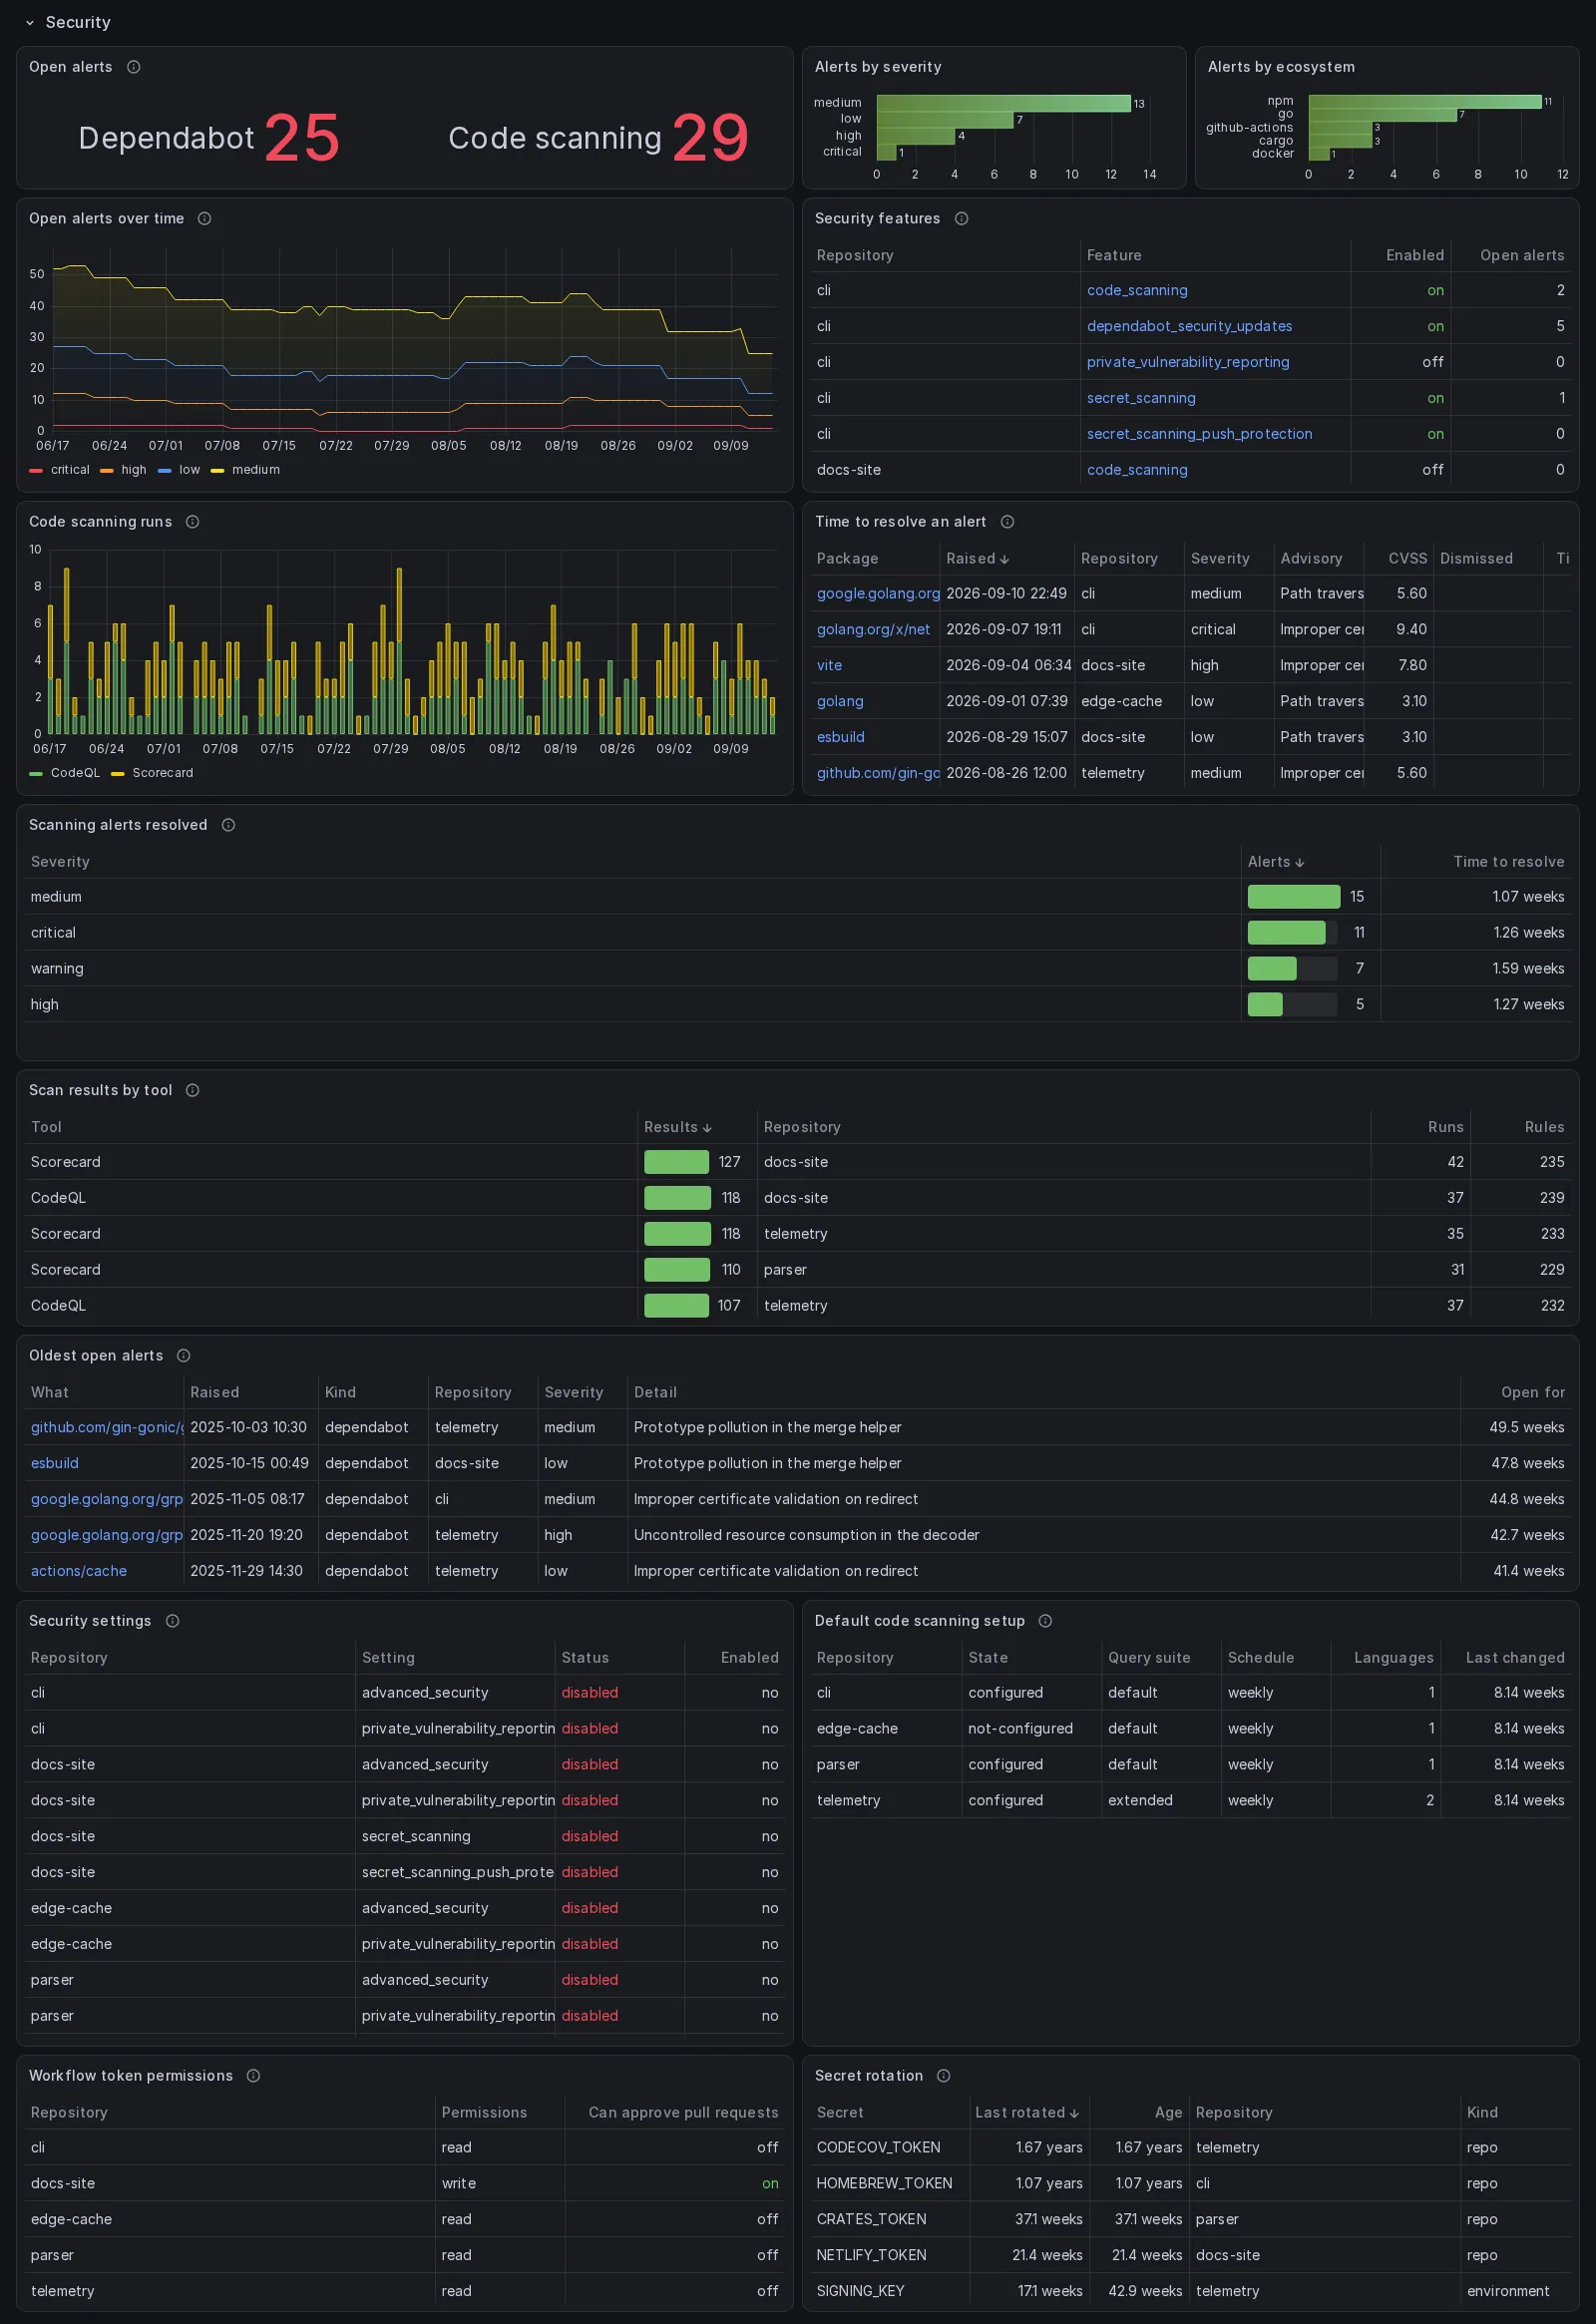
La tabla de funciones es lo que distingue “no hay alertas” de “la función está
apagada”. Sin gh_security_feature, un repositorio con Dependabot desactivado
es indistinguible de uno que no tiene nada que arreglar.
Los recuentos de alertas son estado actual, reescritos en cada pasada, así que
todos los paneles que cuentan alertas abiertas toman la fila más reciente de
cada serie y suman esas, no el rango. Sumar el rango cuenta cada alerta una vez
por pasada: antes de arreglarlo la tarjeta marcaba 3,61 mil donde la cuenta
tiene unas pocas decenas. Una serie es un repositorio por su nombre completo,
así que dos repositorios de dos propietarios con el mismo nombre son dos, como
lo son en los bytes de artefactos y de caché de “Runs in range” y en
“Downloads”, que suman sus lecturas más recientes del mismo modo. La tabla de
funciones y las cuatro tablas del final de la sección, los ajustes, la
configuración de code scanning, los permisos del token y los secretos, también
son estado actual, y leen la fila más reciente de cada repositorio, así que una
función apagada o una alerta arreglada dentro del rango se leen como están y no
como estaban en su punto más alto. Elasticsearch hace lo mismo reduciendo cada
serie a su documento más reciente y leyendo ese, y es la excepción en un sitio,
que lo dice en su descripción: su curva de alertas abiertas toma la serie más
grande de cada severidad en un bucket en vez de sumarlas. Graphite es la
excepción en tres, y lo dice en cada una: sus ajustes, su configuración de code
scanning y sus permisos del token nombran cada fila a partir de la ruta, de la
que forman parte el status de un ajuste, el state, la query_suite y el
schedule de la configuración, y los permissions, así que un cambio dentro
del rango son dos filas, la vieja y la nueva.
Dos paneles son información nueva, no otra vista. El tiempo hasta resolver una alerta de code scanning sale de unas fechas que se descargaban y se tiraban, así que hasta ahora solo existía el recuento de abiertas; de treinta y cuatro alertas de un repositorio, treinta estaban arregladas y tres descartadas, y las treinta y tres eran invisibles. “Scan results by tool” dice qué encontró un análisis en vez de que se ejecutó, que es lo que explica un salto en el número de alertas.
“Oldest open alerts” lista las filas de alerta que dicen abierta, que no siempre son las filas de las que salen esos recuentos. Una pasada escribe una fila por cada una de las cien alertas más recientes de un repositorio, y uno con más toma sus recuentos de una lectura solo de las abiertas. Así que una alerta abierta detrás de cien más nuevas, levantada antes de que arrancara el colector, se cuenta y no se lista, y una alerta arreglada mientras estaba detrás de las cien más recientes sigue listada como abierta, hasta que un relleno histórico lee la lista entera.
Lee gh_dependabot_alert, gh_dependabot_alert_item,
gh_code_scanning_alert, gh_code_scanning_alert_item,
gh_code_scanning_analysis, gh_security_feature, gh_security_setting,
gh_code_scanning_setup, gh_actions_policy y gh_secret.
Bruto, la parte cubierta por el plan, lo que de verdad se facturó, los minutos de Actions, el coste en el tiempo por producto, los minutos en el tiempo por SKU y el uso por repositorio.
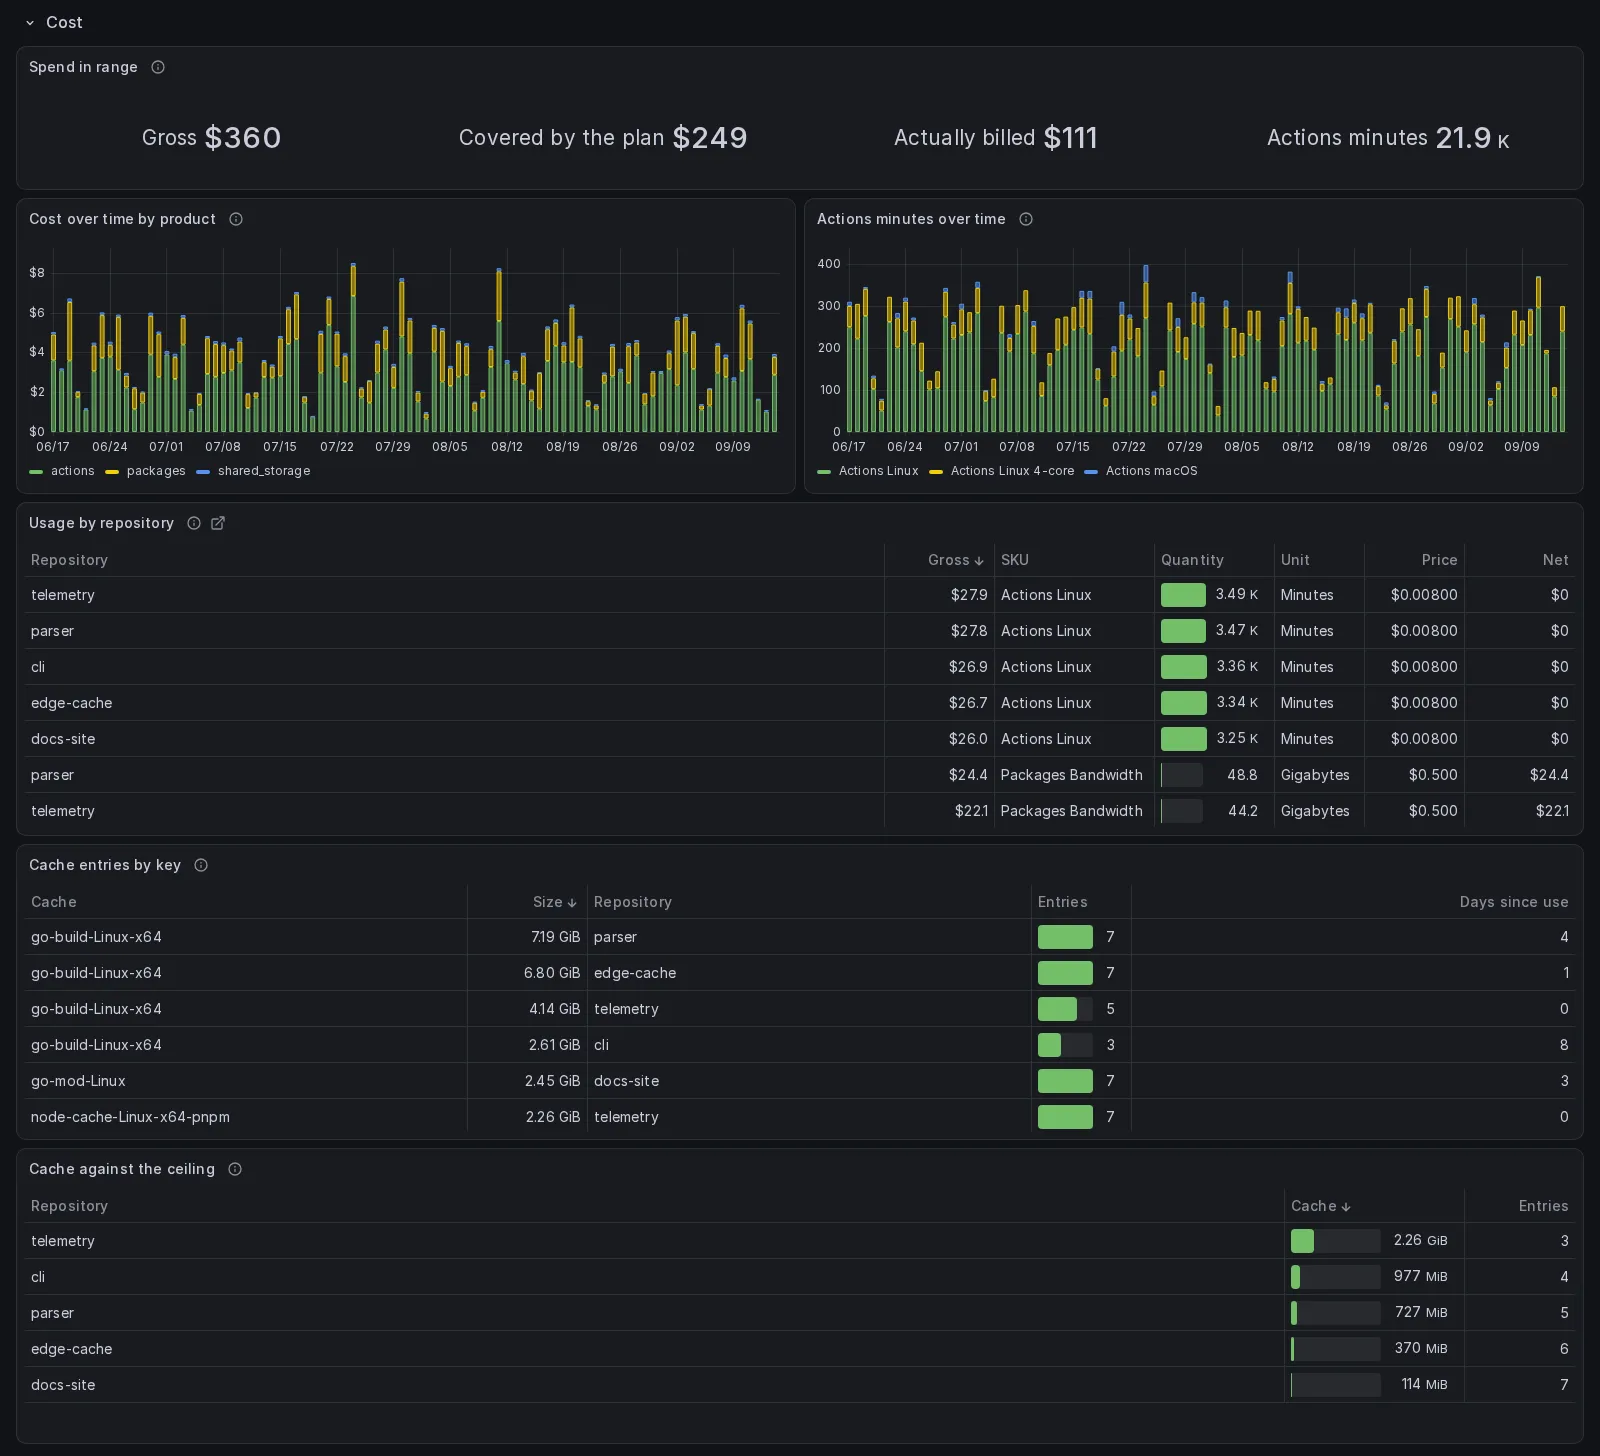
Bruto, descuento y neto se guardan los tres en vez de derivar uno de los otros, porque el neto no siempre es cero y el descuento es donde aparece el crédito mensual. El precio por unidad está en la tabla por el mismo motivo: es lo que explica que treinta mil minutos de macOS cuesten más que doscientos cuarenta mil de Linux. Un repositorio puede salir en esa tabla y en ningún otro panel, porque la lista que factura y la que se recorre no son la misma. Un cargo que no pertenece a ningún repositorio, que es lo que es un asiento de Copilot, se queda fuera de esa tabla en todos los almacenes: es una fila de la factura y no un repositorio llamado (none). Los totales de gasto de arriba sí lo incluyen.
Los dos paneles de caché van del techo. GitHub limita cada repositorio a diez
gigabytes y expulsa la entrada menos usada al pasarlo, así que la barra es cada
repositorio contra ese tope y el panel se lee por lo que queda de margen; la
tabla de entradas dice qué clave se está tirando y cuál lleva una semana sin
tocarse. Cada fila de esa tabla es una caché de un repositorio tal como está:
las filas del último día del rango en que el recolector leyó las cachés de ese
repositorio, una por ref, sumadas, así que Entries cuenta las entradas que
guarda GitHub y no las filas que leyó la tabla. Una ref que GitHub expulsó
conserva su última fila en el almacén, y sumar la fila más reciente de cada ref
del rango la contaba: en la cuenta con la que se comprobó esto, una caché daba
128 entradas y 9,46 GiB en 108 refs donde el día más reciente, y GitHub,
tenían 44 y 3,08 GiB en 24. InfluxDB, PostgreSQL y Elasticsearch leen el día
más reciente de cada repositorio. Graphite no puede encontrarlo, así que lee el
último día UTC del rango: su tabla está vacía desde la medianoche UTC hasta la
primera pasada de actions del día, y muestra solo el tamaño, porque una tabla
de Graphite se queda con una columna. Prometheus guarda el último valor
empujado de cada ref, así que una ref expulsada sigue contando ahí hasta que el
exportador la descarta un día después o, empujada por OTLP, hasta que el
proceso se reinicia.
Lee gh_billing_usage, gh_actions_cache y gh_actions_cache_entry.
Activity
Sección titulada «Activity»Eventos a lo largo del tiempo, eventos por tipo y por repositorio, notificaciones por motivo y por tipo, notificaciones a lo largo del tiempo y el trabajo hecho en repositorios de otras personas. Los dos paneles fechados agrupan según el rango, no en una hora ni en un día fijos.
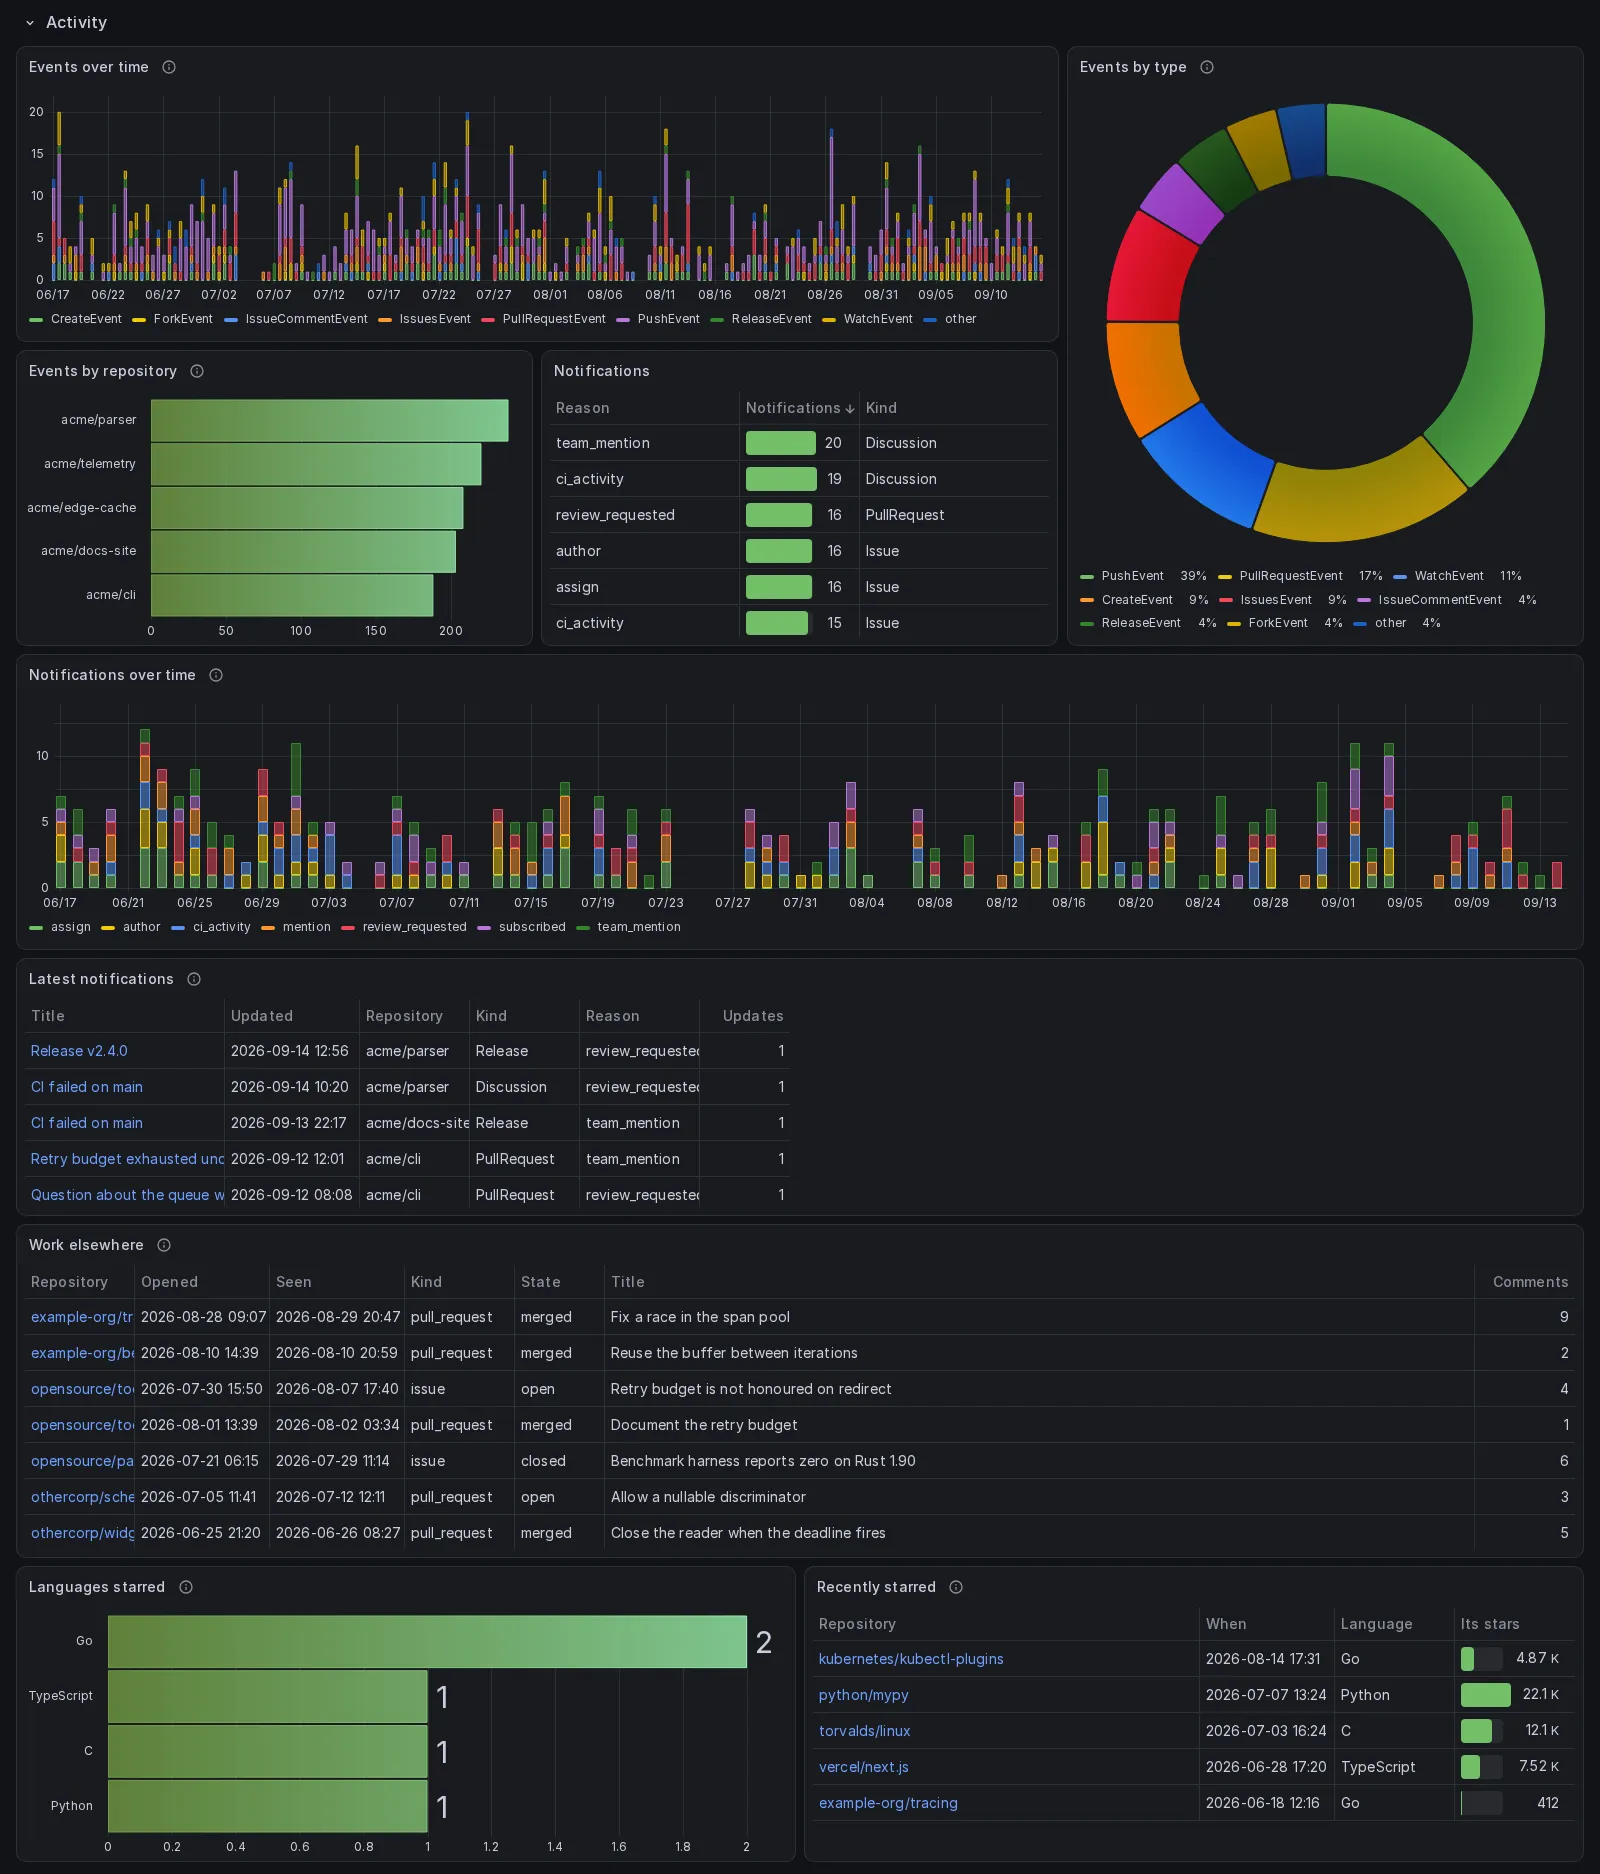
Los eventos y las notificaciones son ventanas, no historias. GitHub guarda los últimos trescientos eventos de los últimos treinta días y descarta las notificaciones a los tres meses salvo las guardadas, así que lo que queda almacenado es lo que había cuando pasó la pasada.
El donut lleva la parte de cada tipo en su leyenda y no escribe nada sobre los sectores, porque Grafana omite la etiqueta del sector en el que no cabe y los sectores finos nunca tenían la suya. La leyenda es una lista debajo del gráfico y no una columna a su lado, por medida y no por gusto: por debajo de 992 píxeles Grafana pone toda leyenda debajo del gráfico y la limita al 35 por ciento del panel, pida lo que pida el panel, y una leyenda colocada al lado se dibuja allí como columna, una entrada por línea, que en un teléfono se cortaba tras siete entradas; una lista colocada debajo se ajusta en varias líneas, y con la altura que tiene el pastel los once tipos de un mes caben enteros a 360 píxeles. Cada tipo es un sector con un color propio y con su propio nombre en todos los almacenes: la consulta responde una fila por tipo, y el panel hace de cada fila un campo, porque Grafana colorea un pastel por campo y una columna de cuentas es un solo campo, que pintaba todos los sectores del mismo verde.
Los dos últimos paneles son el espejo de la sección de estrellas: las estrellas que dio esta cuenta, no las que recibió, por lenguaje y por proyecto, fechadas cuando dio cada una. Si los proyectos son pequeños o famosos es otra pregunta distinta de cuántos son, así que la segunda tabla lleva sus propias estrellas. El exportador de Prometheus guarda el lenguaje de cada estrella y no su repositorio, así que allí la segunda tabla tiene una fila por lenguaje, con la media de estrellas de los repositorios marcados en él.
La tabla del trabajo en otros repositorios lleva ese mismo número para los
repositorios a los que contribuyó la cuenta: las estrellas de cada uno en la
pasada más reciente dentro del rango, de gh_upstream_repo, unidas a cada
elemento en los dashboards de InfluxDB y PostgreSQL y junto a cada repositorio
en el de Prometheus. Graphite y Elasticsearch no pueden unir dos medidas en un
panel y dejan la columna fuera, diciéndolo. La familia outbound escribe esa
medida desde 2.6.0, así que un rango sin ninguna fila suya, que es todo rango
anterior a la actualización, tiene vacía la columna Stars. Hasta que la primera
pasada de outbound de 2.6.0 la escribe, InfluxDB y PostgreSQL no tienen tabla
que unir y rechazan el panel entero en vez de dejar la columna vacía, lo que
cubre la página de problemas.
InfluxDB, PostgreSQL y Elasticsearch listan cada elemento una vez, por su fila
más reciente dentro del rango, y Elasticsearch no tiene columna Opened, porque
esa fecha es la de la fila menos el tiempo que el elemento estuvo abierto, una
resta que un bucket no puede hacer. Prometheus tiene una fila por repositorio,
y Graphite una por elemento y estado, porque el estado forma parte de la ruta:
un elemento visto abierto y luego cerrado dentro del rango son dos filas allí.
Lee gh_event, gh_notification, gh_external_contribution,
gh_upstream_repo y gh_star_given.
Inventory
Sección titulada «Inventory»Código por lenguaje, la puntuación del perfil de comunidad de cada repositorio, la tabla de repositorios, los temas, los paquetes, los gists y las etiquetas de contenedor con el momento en que se publicó cada una. Debajo, los ajustes del repositorio, las claves de la cuenta, las cuentas sociales, los cambios de configuración, los ficheros de política, los ecosistemas de Dependabot, y las dependencias por licencia, por ecosistema y según cambiaron.
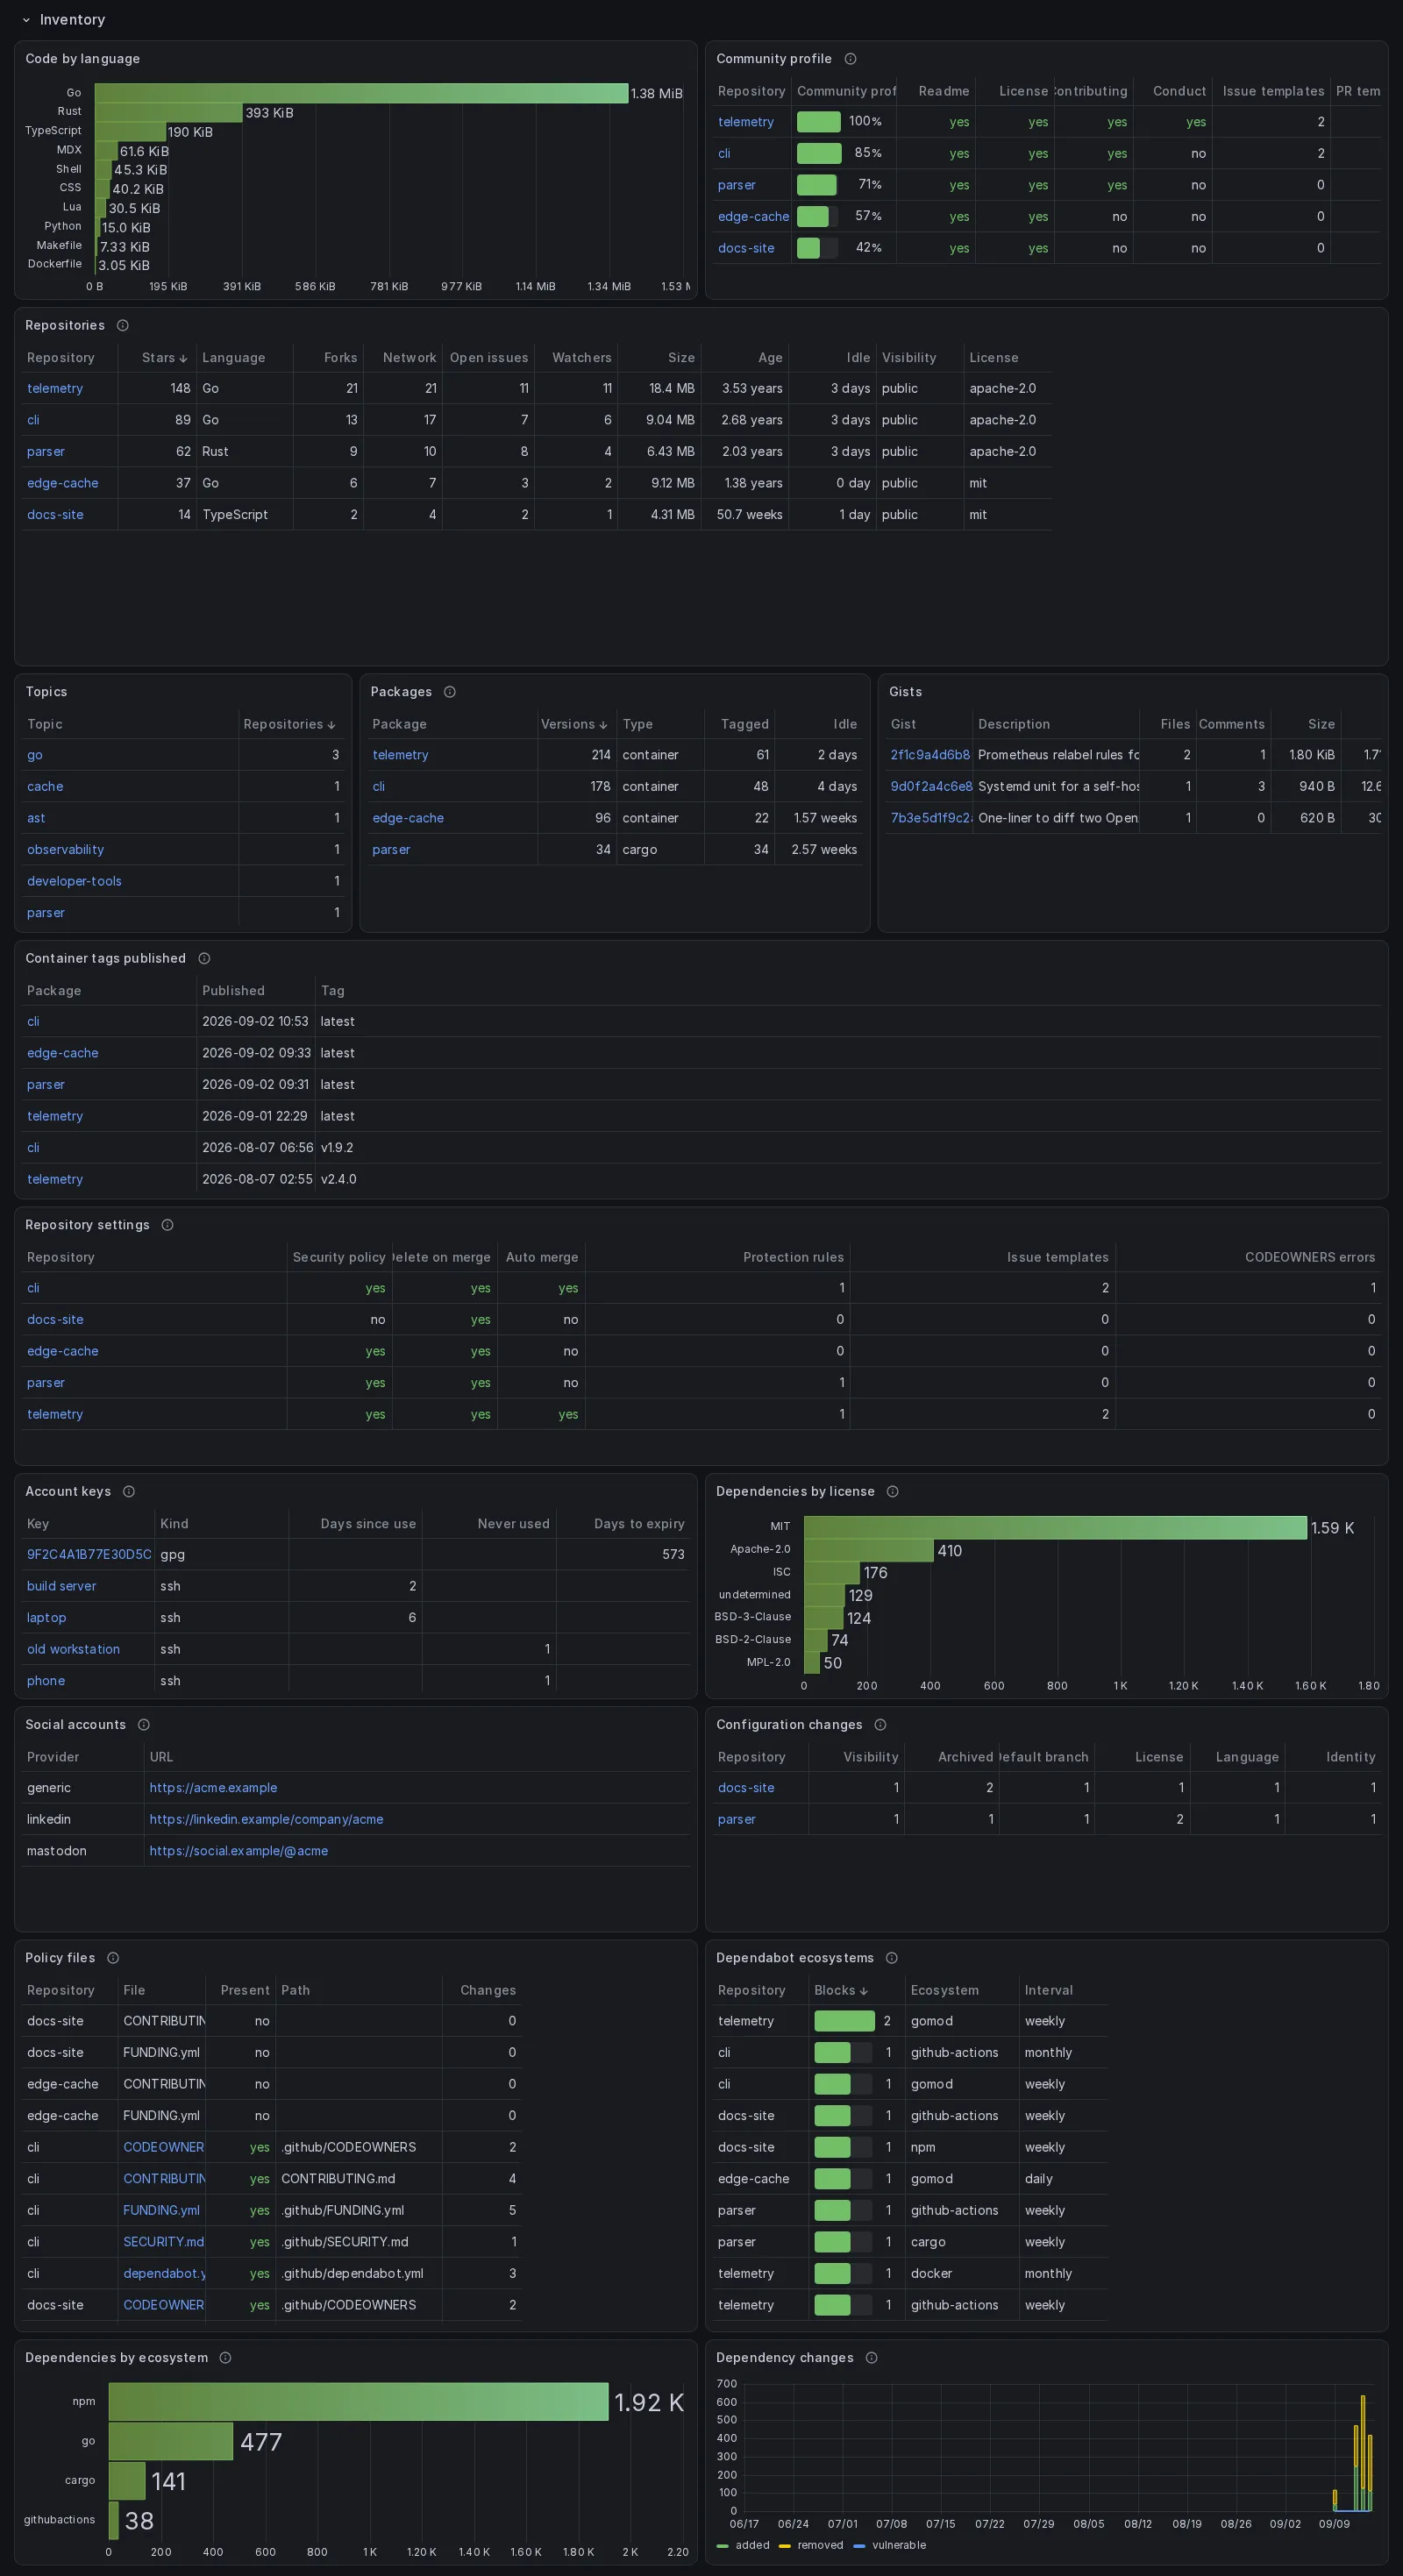
open_issues en la tabla de repositorios es el campo propio de GitHub, y GitHub
cuenta las pull requests dentro. gh_issue es con lo que se cuentan las issues.
El perfil de comunidad enseña las casillas que hay detrás de la nota además de
la nota, porque el porcentaje esconde cuál falta: en la cuenta medida ocho de
treinta y cinco repositorios no tienen licencia. La casilla de plantilla de
issue no es la de GitHub: la bandera issue_template de la API solo informa
del fichero único heredado ISSUE_TEMPLATE.md, no de un directorio de
plantillas, mientras que la página de comunidad y health_percentage sí cuentan
el directorio, así que la bandera decía “no” en todos los repositorios de una
cuenta cuyos repositorios puntúan 100 con cuatro formularios cada uno (el hueco
está reportado en community/community#207706). La columna es el número de
plantillas que el repositorio tiene de verdad, formularios y Markdown, de
gh_repo_policy.issue_templates, unido a la fila del perfil por repositorio en
los dashboards de InfluxDB, PostgreSQL y Prometheus; Graphite y Elasticsearch no
pueden unir dos medidas en un panel y conservan la bandera de la API,
diciéndolo. La tabla de ajustes es la misma idea para lo que permite un repositorio, y
codeowners_errors es la entrada que falla en silencio, porque un fichero
CODEOWNERS roto deja de pedir revisiones y no dice nada. La tabla de claves de la
cuenta es donde aparece una clave SSH que no se ha usado nunca, y donde queda
apuntada la caducidad de la que firma todos los commits.
El último panel está vacío casi siempre, y esa es la gracia: una fila en
“Configuration changes” significa que un repositorio se
renombró, se archivó, se hizo privado, cambió de licencia o movió su rama por
defecto. La columna de identidad cuenta valores distintos de repo_id, que es la
única forma de distinguir un renombrado de un repositorio nuevo, porque GitHub no
publica ningún historial de renombrados.
Lee gh_repo, gh_repo_language, gh_repo_community, gh_repo_topic,
gh_repo_policy, gh_package, gh_package_version, gh_gist, gh_key,
gh_social_account, gh_policy_file, gh_dependabot_ecosystem,
gh_dependency, gh_dependency_license y gh_dependency_change.
Profile and sponsorship
Sección titulada «Profile and sponsorship»Lo que anuncia el perfil y lo que mueve Sponsors: el dinero que entra y sale, los patrocinios en ambos sentidos, los niveles ofrecidos, los ítems fijados, las banderas del perfil, las listas de estrellas y las insignias de logros con la distancia de cada una a su siguiente escalón.
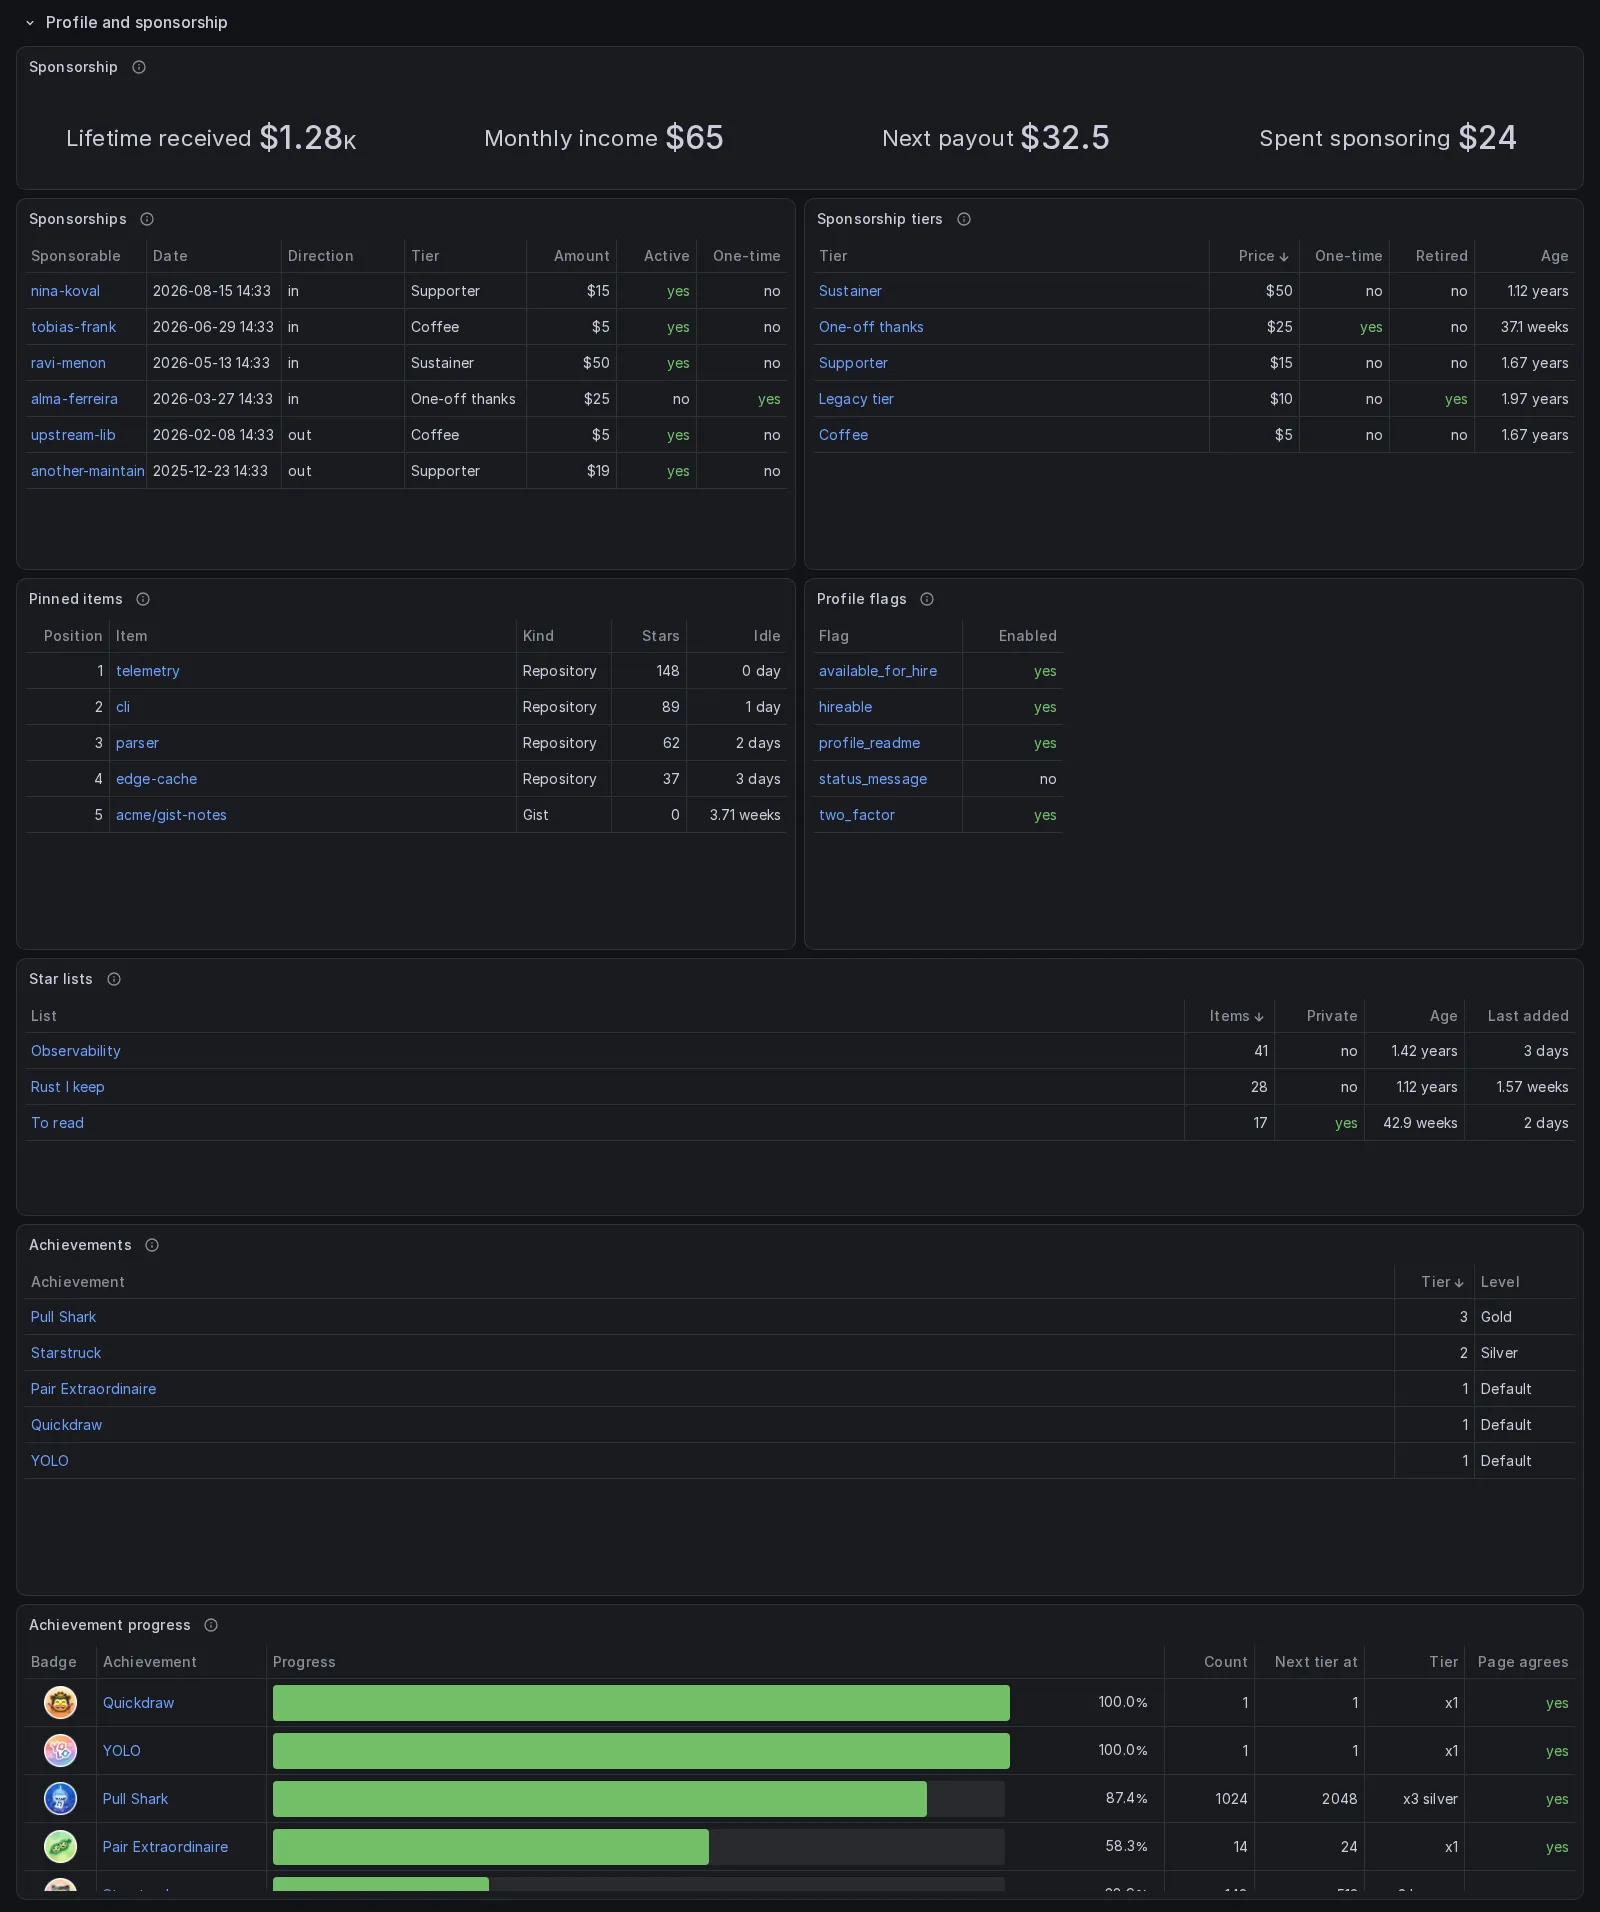
Las cuatro cifras son la lectura más reciente de una instantánea que se reescribe en cada pasada, no una suma sobre el rango, que informaría del total de por vida una vez por pasada. El total de por vida es el que conserva la historia: la estimación mensual se va a cero en cuanto caduca el último patrocinio, y el dinero que sí llegó deja de verse en ningún otro sitio. Lo gastado patrocinando no es el gasto de la sección Cost, que es lo que GitHub cobra por Actions, paquetes y almacenamiento; esto es dinero que se va al trabajo de otra persona.
Las tablas de debajo son inventarios y no historias, y lo dicen nombrando su
propia ventana: un patrocinio hecho en 2021 aparece con los treinta días por
defecto, donde un panel al rango del dashboard dibujaría un eje vacío sobre un
puñado de filas repartidas por años. Un patrocinio se fecha el día en que
empezó y no el día de ningún pago, ambas conexiones se leen con activeOnly
desactivado para recuperar uno caducado, y el patrocinable es la palabra
literal private cuando la otra parte queda oculta, sin adivinar ningún enlace.
Los niveles se anclan al comienzo del día UTC por la misma razón: fechados en
su creación caerían todos fuera de cualquier rango y se leerían como que no hay
ninguno.
Los ítems fijados llevan la posición como campo y no como etiqueta, porque un repositorio que pasa del hueco dos al tres es el mismo fijado, y como etiqueta cada recolocación bifurcaría la serie. El filtro de repositorio de la cabecera del dashboard no llega a ese panel: un fijado puede ser un gist, que se nombra por su hash y no está en ningún repositorio que el filtro conozca.
Los logros se leen cada hora de la página pública del perfil, porque ninguna API los lista. El recuento de Pair Extraordinaire, pull requests fusionadas en repositorios públicos con un commit en coautoría, es un total que guarda el fichero de estado: cada pasada horaria suma las pull requests fusionadas desde el último día que cubre, y la historia entera se vuelve a recorrer una vez por semana, que es cuando un recuento que bajó, por un repositorio hecho privado o borrado, baja en la tabla. Sin fichero de estado cada arranque la recorre entera. “Next tier at” es el umbral observado por la comunidad (Schweinepriester/github-profile-achievements) y no un número que GitHub publique, así que la última columna dice si la página del perfil coincide con el escalón que implica el recuento; una fila que no coincide es una regla que la página contradice, y no lleva objetivo ni barra. Los dos paneles de logros están vacíos hasta que esa familia haya corrido una vez.
Lee gh_sponsors_listing, gh_sponsorship, gh_sponsors_tier,
gh_pinned_item, gh_profile_flag, gh_star_list, gh_achievement y
gh_achievement_progress.
The collector itself
Sección titulada «The collector itself»Lo que le queda al colector por gastar y lo que consiguió hacer: el presupuesto de cada uno de los quince límites de GitHub en el tiempo, una tabla con todos ellos ordenada por cuánto se ha gastado de cada uno, y debajo de esas dos el informe de la fila sobre el propio barrido.
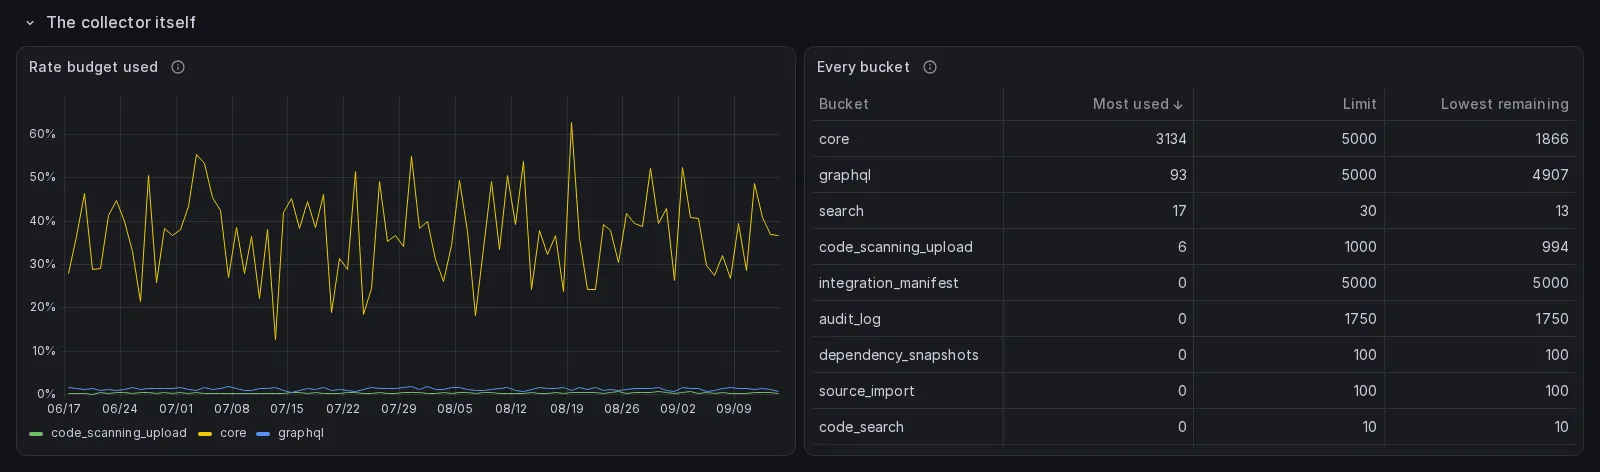
El gráfico muestra solo los cubos con más de treinta peticiones, porque el de
búsqueda tiene treinta por minuto y aplastaría el eje. Leer todo esto no cuesta
nada: GET /rate_limit es el único endpoint que GitHub no cobra. Sin él, una
familia saltada por falta de presupuesto es indistinguible de una que no tenía
nada que contar. Most used y Lowest remaining son en la tabla los extremos del
rango, lo más que gastó cualquier lectura y lo menos que le quedaba a
cualquiera, así que un cubo agotado hace una hora lo sigue diciendo después de
recargarse; Graphite guarda solo el mínimo restante.
“Every family” y “What failed, and where” son los dos paneles de debajo, y la
captura de arriba es anterior a ambos. El primero lista todos los colectores
que corrieron en el rango, qué los detuvo cuando algo lo hizo, en cuántos
barridos corrieron y el mayor número de repositorios por los que les preguntó
uno de esos barridos, que en commits, issueevents e issues incluye los
repositorios en los que la
consulta de movimiento
no encontró nada nuevo y que la familia dejó sin leer; una familia sin fila ahí
no corrió en absoluto. El motivo es columna aparte para que los dos
tipos de fallo se ordenen por separado: un presupuesto de búsqueda agotado
no es el 502 que le costó a un repositorio su historia, y una
familia que tuvo ambos tiene una fila de cada. El segundo es una fila por cada
repositorio que un colector no pudo recoger, el más reciente primero, con lo
que respondió GitHub.
Que la segunda tabla esté vacía es el caso bueno, y se dibuja vacía en lugar de
rechazada porque las filas de la primera se escriben en cada barrido haya
fallado algo o no, así que la medida que hay detrás de las dos existe desde el
primero.
Están ahí por un fallo que esta página no podía explicar. El 2026-09-16 cinco
repositorios de esta cuenta no tenían ninguna ejecución ni trabajo de workflow,
cada uno porque una llamada por los trabajos de una ejecución había respondido
502 una vez y el colector había tirado todo lo que había reunido de ese
repositorio. La fila Continuous integration se dibujaba sobre una cuenta a la
que le faltaban sus cinco repositorios más activos mientras la fila Cost de la
misma página decía que uno de ellos había quemado 27,6 K minutos de macOS.
Ninguno de los dos paneles usa la variable de repositorio: las filas de familia
no pertenecen a ningún repositorio, y un repositorio que un barrido no pudo
recoger puede ser uno que la variable ni siquiera lista, porque la variable se
construye con filas que escribe ese mismo barrido.
Lee gh_rate_limit y gh_collector_family.
La columna Link
Sección titulada «La columna Link»Toda tabla cuyas filas son ítems de GitHub selecciona una columna llamada Link,
la url de la fila, y la oculta: el enlace cuelga de la primera columna de la
tabla, el nombre de la cosa, y abre la página de la propia fila en una pestaña
nueva. En un teléfono la columna del extremo derecho se alcanzaba en dos tablas
de veintiocho, y la primera columna siempre está en pantalla; por la misma
razón la columna por la que se ordena una tabla es la segunda, y una fecha se
muestra al minuto y no al segundo. Unas pocas tablas enlazan desde otra url que
lleva la fila: Recent
stars abre a la persona que dio la estrella, Top referrers el host que envió
las visitas, Deployments by environment tiene una segunda columna, Live, con la
dirección del propio entorno. Release assets conserva su fichero bajo Download,
que descarga el binario, y añade la página de la release como su Link; un clic
en una barra de Downloads by release también abre la release. Cuando la página
es una que GitHub solo muestra al propietario, los ajustes de un repositorio,
su gráfico de tráfico, una alerta, el título al pasar el ratón por el enlace lo
dice.
La columna llega a un almacén solo donde su consulta la devuelve: los dos
almacenes SQL la seleccionan por nombre y Elasticsearch agrupa por
url.keyword, así que un documento sin ella cae en una celda vacía y no fuera
de la tabla. Prometheus no lleva url y Graphite no guarda cadenas, y cada una
de sus tablas dice en su descripción que la columna Link del dashboard de
InfluxDB está ausente allí. cmd/check_dashboards somete cada columna de
enlace de un dashboard renderizado a esa regla: la columna tiene que volver, y
no contener más que urls absolutas y celdas vacías, un nulo de los almacenes
SQL o la cadena vacía de ese bucket.
Cuando un almacén no puede responder
Sección titulada «Cuando un almacén no puede responder»Los almacenes no pueden responder las mismas preguntas, y los paneles lo dicen en vez de fingir.
- InfluxDB y PostgreSQL guardan una fila por hecho, fechada cuando ocurrió, así que dibujan el tráfico de un martes concreto, la curva de estrellas desde 2018 y el tiempo de fusión de una pull request cerrada en julio. El juego de PostgreSQL es el SQL de InfluxDB traducido, porque el destino SQL escribe los mismos hechos como tablas, y compara el texto por sus bytes como InfluxDB, así que una lista sale en el mismo orden en los dos, sea cual sea la intercalación con que se creó la base de datos.
- Prometheus sella cada muestra en el momento del scrape, así que el
exportador reduce las filas por elemento a valores actuales más, para las
medidas que se cuentan, un
_totalmonótono de elementos distintos vistos desde que arrancó.increase()sobre eso es como se responden los paneles “por día” y “sobre el rango”. - Graphite conserva los puntos fechados pero no tiene filas: una tabla ahí es uno o dos números por serie reducidos sobre el rango, así que una tabla que necesita varios campos de una fila se queda con los números que puede llevar una fila y nombra cada columna que suelta, una cadena allí ni siquiera es una métrica, y un booleano se guarda como 1 o 0, igual que cualquier número.
- Elasticsearch conserva los documentos fechados, así que una tabla por
elemento son los documentos más recientes, o el más reciente de cada elemento
cuando un elemento tiene varios, y todo lo demás es una agregación por
buckets, sobre el subcampo
.keywordde cada etiqueta.
Graphite y Elasticsearch comparten dos límites que los almacenes SQL no tienen. Ninguno puede unir dos medidas en un panel, así que allí Work elsewhere no tiene columna Stars y el perfil de comunidad conserva la bandera de plantilla de issue de la API en vez del número de plantillas. Y ninguno puede preguntar por una ventana mientras lee otra, así que los repositorios archivados que el filtro por omisión aparta cuentan en el Overview y en Every repository, ever por sus filas de los últimos siete días, y un rango que terminó hace más de una semana los deja fuera.
Una gráfica o una gráfica de barras que los almacenes SQL pliegan, con sus series más activas nombradas y el resto en una llamada other, se pliega igual en Graphite, y en Prometheus donde el exportador guarda los recuentos que sumaría. Elasticsearch no puede, ya que una agregación terms no dice nada de los valores que no guarda, y cada panel suyo que dibuja todas las series lo dice.
Cada panel cuyo gemelo en otro almacén es más rico lo dice en una frase de su descripción.
Veinticuatro paneles no tienen respuesta en Prometheus
Sección titulada «Veinticuatro paneles no tienen respuesta en Prometheus»Top paths, el calendario de contribuciones, los dos punch cards de commits y los dos repartos por repositorio del calendario, las pull requests más grandes, pull requests por autor, las issues abiertas más tiempo, la deuda de revisión, los pasos más lentos, los pasos que fallan, los workflows que nunca se ejecutaron, los artefactos creados a lo largo del tiempo, los commits que dejaron la rama en rojo, las últimas discusiones y las respuestas dejadas fuera, los assets de release, lo que ganó cada asset, las alertas abiertas más antiguas, los eventos por repositorio, las últimas notificaciones, las etiquetas de contenedor y la configuración que cambió. El exportador o se salta la medida, o descarta la identidad de la que trata el panel, o el panel es un cruce entre dos medidas.
Adónde fue la salida de los fallos es un panel de texto en todos los almacenes, este incluido: es una nota sobre dónde mirar, no una consulta.
Tres de esos son cruces o diferencias de conjuntos y tampoco tienen respuesta en Graphite ni en Elasticsearch, por lo mismo: una agregación corre dentro de un índice o de un árbol, y estos necesitan dos. El calendario no la tiene en ninguno de los dos por otra razón: la rejilla necesita la semana en un eje y el día de la semana en el otro, y un histograma de fechas o un summarize agrupan por un solo intervalo. Cada uno de los dos pierde algo más por su cuenta: Graphite las alertas abiertas más antiguas y las últimas notificaciones, porque guarda números y no las cadenas de las que están hechas esas tablas, y Elasticsearch lo que ganó cada asset, que es la diferencia entre el primer y el último valor del rango.
Se emiten igualmente, como paneles de texto con el mismo título que dicen qué mostrarían y por qué el almacén no puede, para que los diseños sigan siendo idénticos.
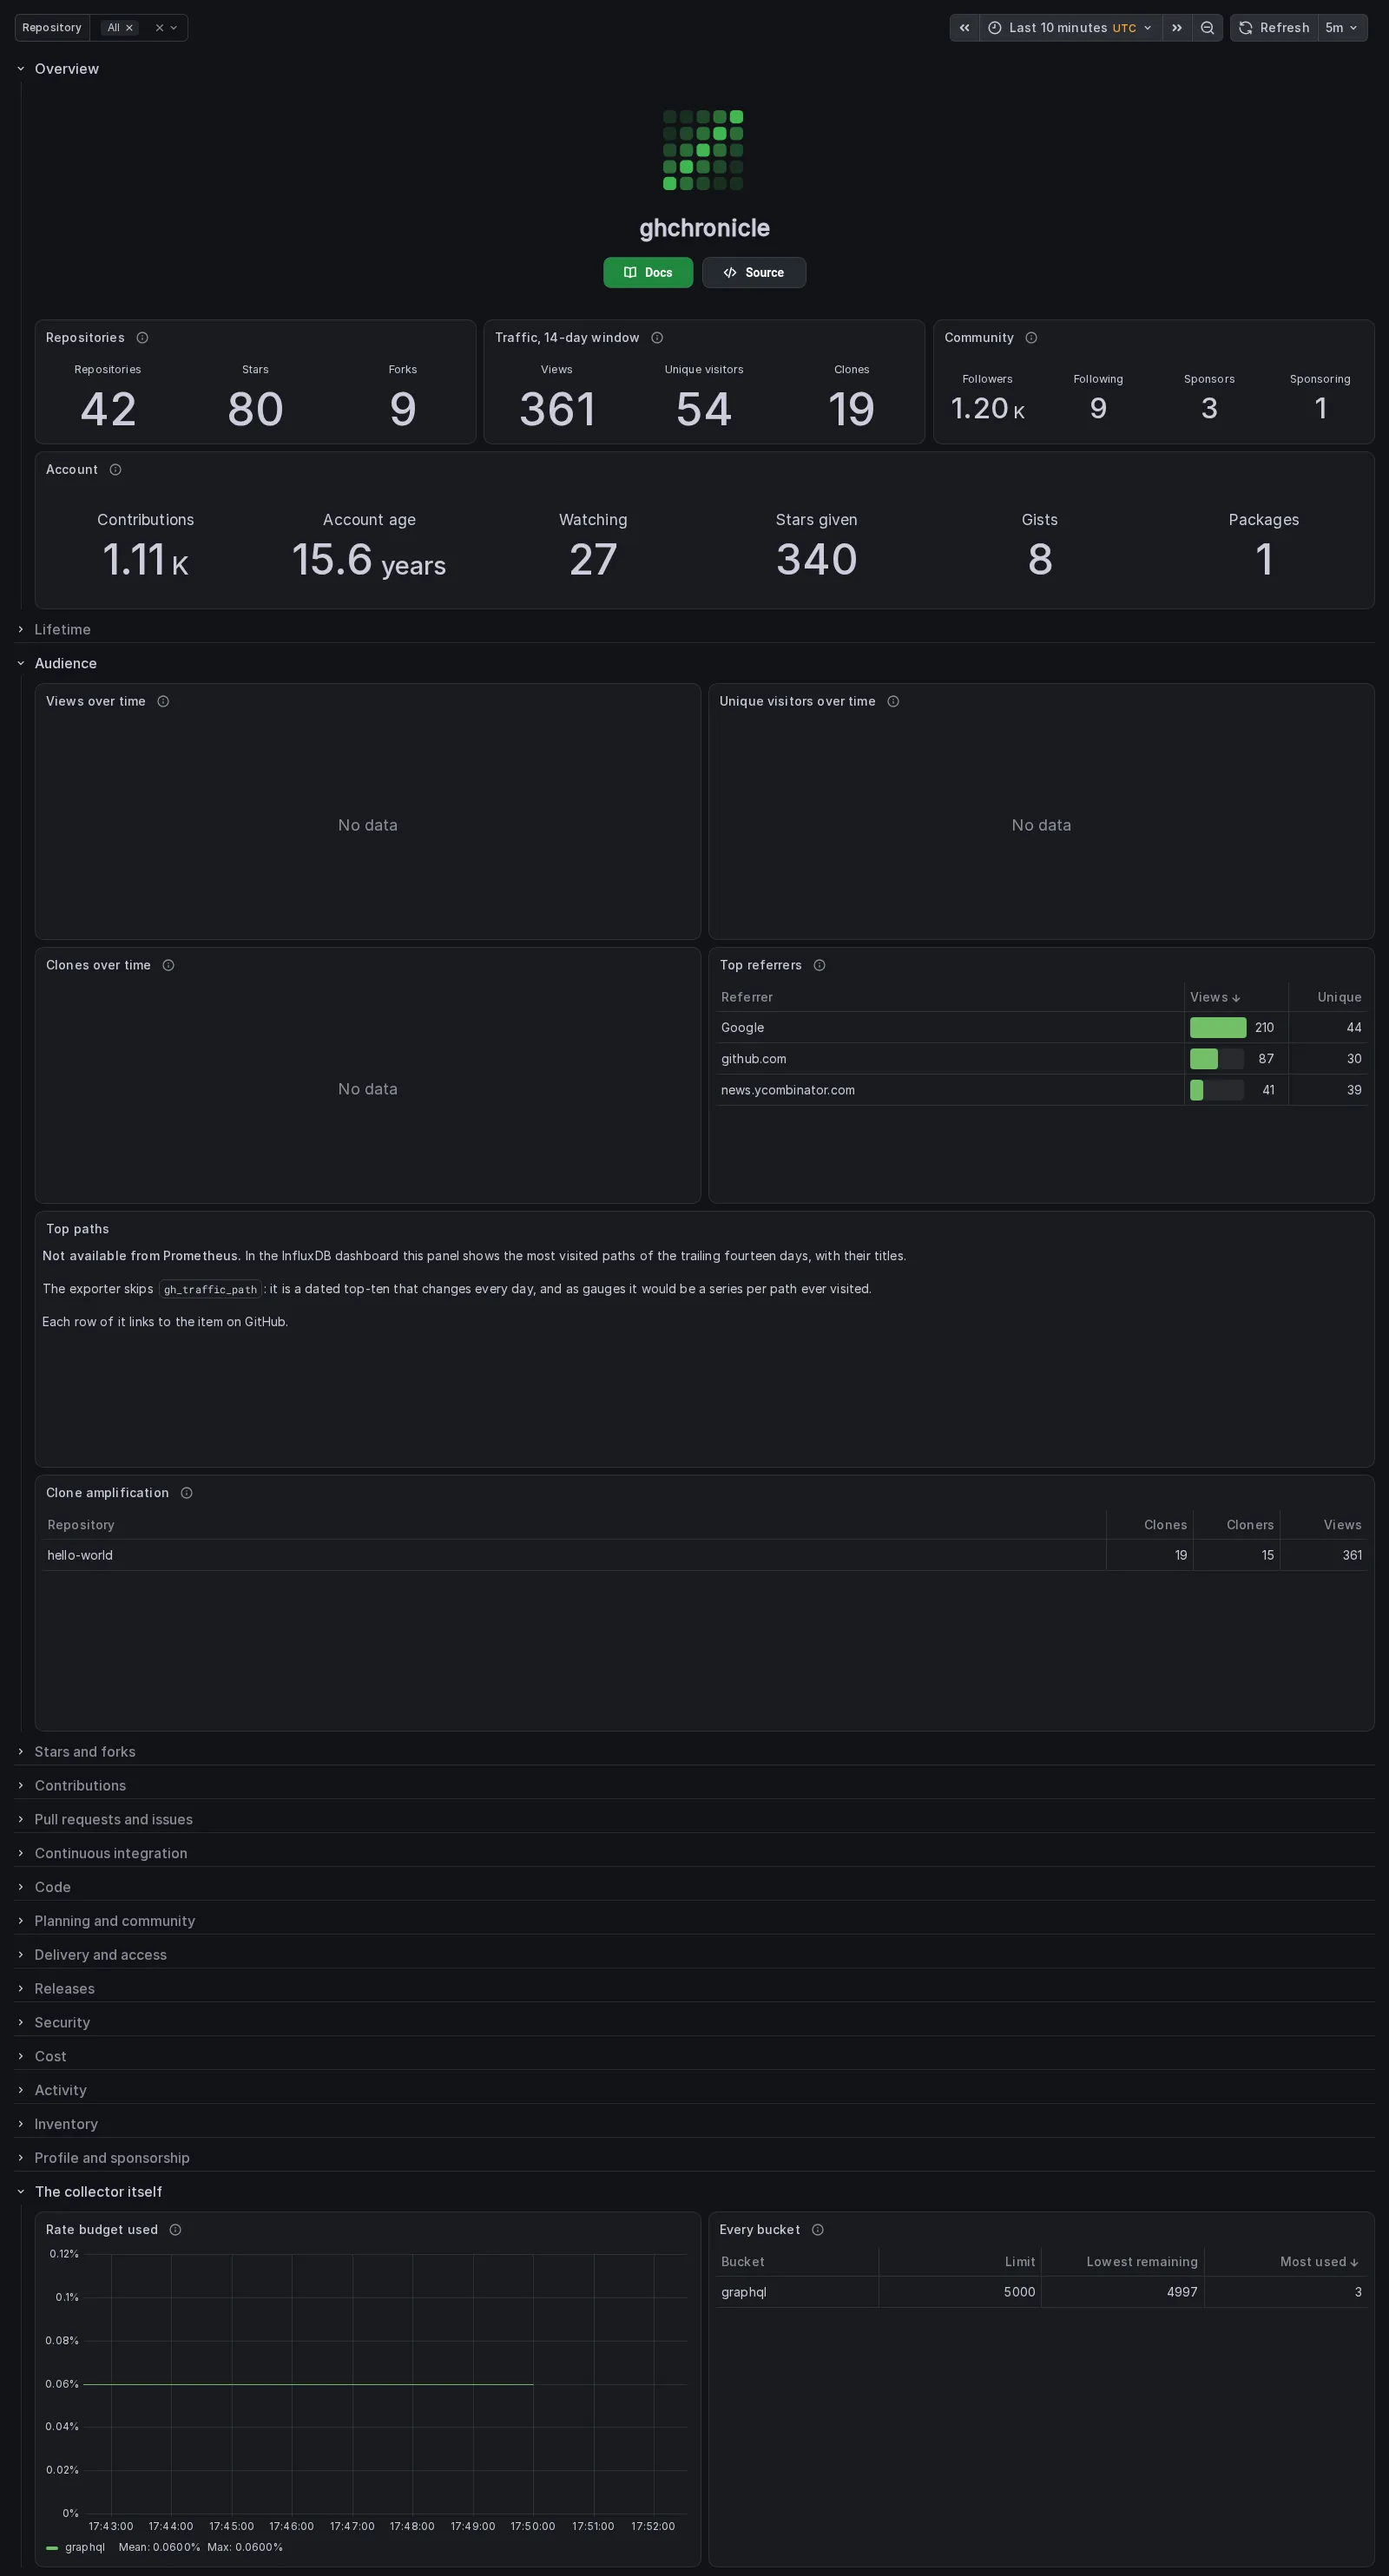
Esa captura no es de ninguna cuenta. Es el dashboard de Prometheus de la suite
end-to-end en contenedores (test/e2e/docker), donde el colector recorre el
GitHub falso de test/e2e/fakegh, cuya cuenta es octocat con un solo
repositorio, y Prometheus hace scrape del exportador cada cinco segundos. El
rango son los diez minutos que llevaba recolectando cuando se tomó la captura,
que es lo que hace que merezca la pena enseñarla: cada número del Overview, y
las dos tablas de la sección Audience, es un valor actual, porque un valor
actual es todo lo que el exportador puede servir; Rate budget used es una
línea plana, porque un gauge repetido en cada scrape es una línea plana; Top paths es el panel de texto descrito arriba; y Views, Unique visitors y
Clones over time dicen “No data” porque su bucket tiene un suelo de un día y
este Prometheus lleva minutos. En un servidor que lleve meses haciendo scrape
esos tres dibujan, empezando el día en que arrancó el exportador.