Importar
Cinco dashboards, todos en inglés, todos en el formato de exportación compartible
de Grafana: el datasource es un marcador ${DS_...} y el bloque __inputs pide
a quien importa que elija el suyo.
| Fichero | Paneles | Almacén |
|---|---|---|
ghchronicle- | 154 | InfluxDB 3, consultado con SQL |
ghchronicle- | 154 | Prometheus |
ghchronicle- | 154 | PostgreSQL o TimescaleDB, desde el destino que conecta o desde el fichero SQL |
ghchronicle- | 154 | Graphite, desde el destino de Graphite |
ghchronicle- | 154 | Elasticsearch u OpenSearch, desde el destino de Elasticsearch |
Las cinco tienen los mismos paneles en el mismo orden. Lo que cambia es cuántos puede responder el almacén que hay detrás de cada una.
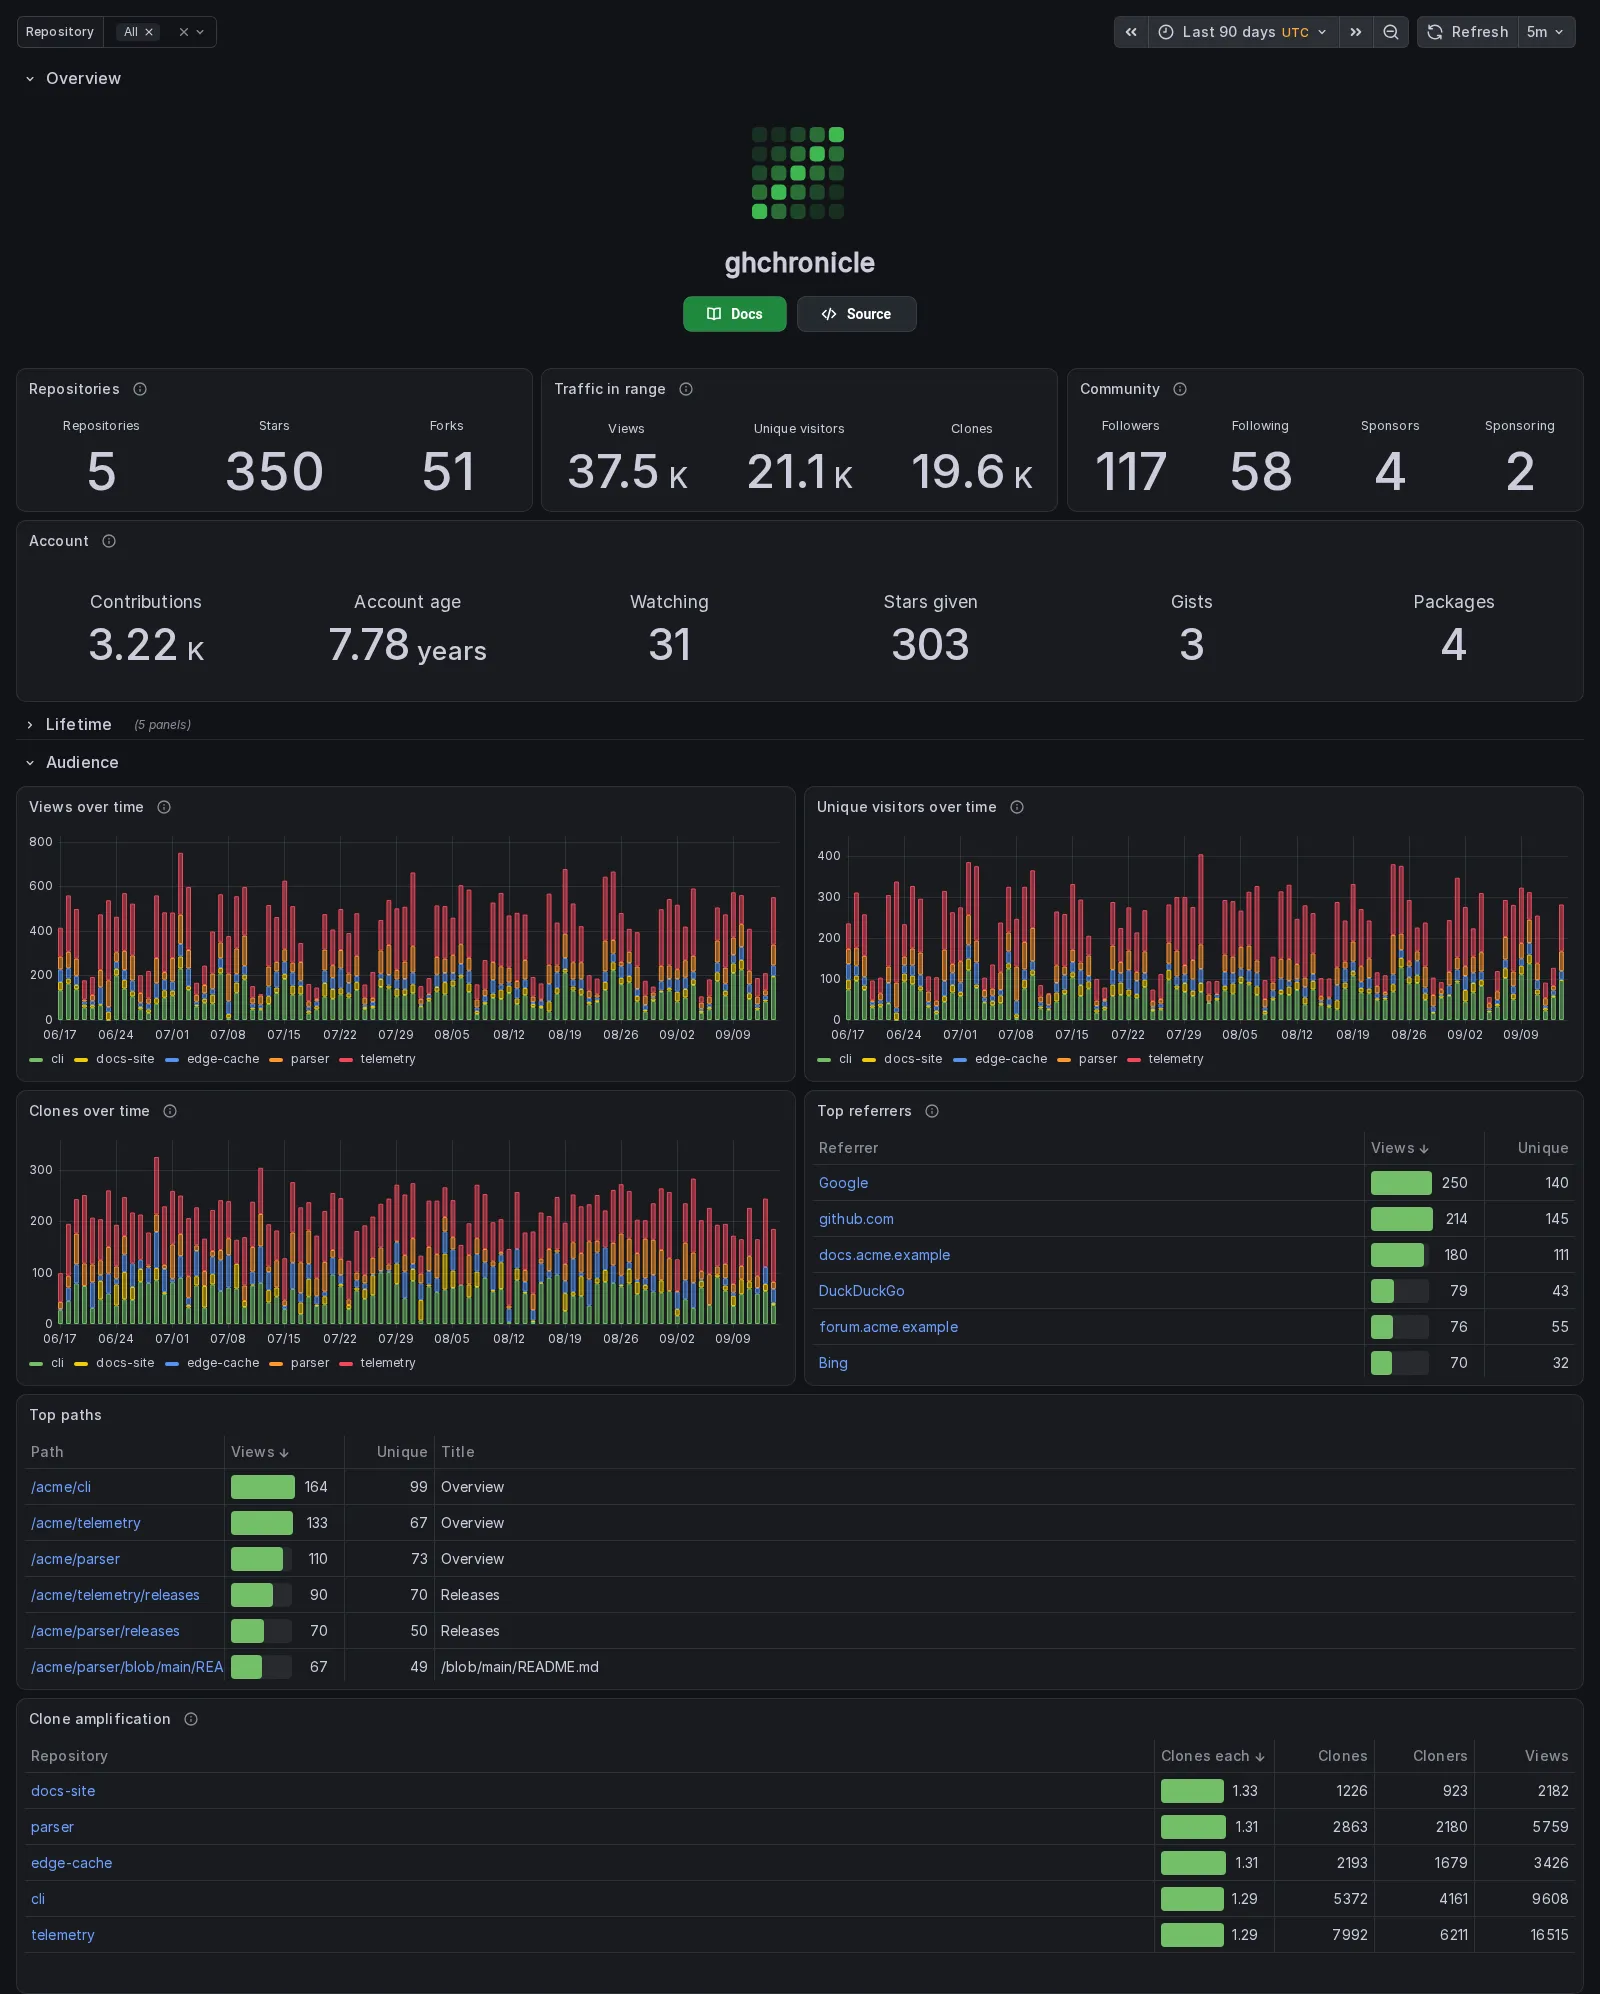
La cuenta de esa captura es la inventada que usan todas las capturas de esta
documentación, acme y cinco repositorios, descrita junto a lo que muestran
los paneles. Todas las secciones salvo el
Overview se envían plegadas, por eso Lifetime es ahí una cabecera.
Dejárselo al binario
Sección titulada «Dejárselo al binario»El dashboard se construye con el mismo código que lleva el binario, así que el binario puede publicarlo. Dándole un Grafana, reconcilia el datasource a partir del sink al que ya escribe, le pregunta a ese datasource si de verdad se le puede alcanzar, y publica el dashboard de cada almacén al que escribe.
grafana: url: http://localhost:3000 token: ${GRAFANA_TOKEN}ghchronicle -config config.yaml -publish-dashboardNo le pregunta nada a GitHub, así que no necesita token de GitHub, e imprime lo que hizo con cada datasource y cada dashboard.
Tres de los cinco sinks describen su propio datasource sin decirles nada más, porque aquello a lo que escriben es lo que Grafana consulta: InfluxDB, Elasticsearch y el sink de PostgreSQL que conecta, cuyo DSN lleva el servidor, la base, el usuario y, cuando el propio DSN la escribe, la contraseña.
Otros dos necesitan la dirección y nada más, porque escriben en un sitio que no es al que va una consulta: el sink de Prometheus se raspa en vez de recibir escrituras, y el de Graphite habla el puerto de ingesta mientras que Grafana pregunta a la API web, en otro puerto. Dales la dirección y el datasource se crea igual:
grafana: datasource: url: http://prometheus:9090El que no se puede describir de ninguna manera es el sink SQL, el que escribe sentencias a un fichero: nunca se conecta, así que no hay host, puerto, usuario ni contraseña en ninguna parte de su configuración. Ese, y cualquier datasource que prefieras gestionar tú, se nombra en su lugar:
grafana: datasource: uid: ae3x9k2Un datasource nombrado así se adopta y se deja exactamente como está, porque corregir uno que no hizo esto sobreescribiría ajustes que nadie le pidió tener.
publish_on_start: true hace lo mismo una vez al arrancar el colector, antes
de la primera pasada. Viene apagado, y es lo que evita que un servidor se quede
callado por detrás del binario que lo alimenta: el dashboard se genera del
código, así que actualizar el binario actualiza el dashboard. Un fallo ahí
avisa y la pasada sigue, porque las métricas de una hora sin recoger no se
recuperan y un dashboard publicado al siguiente arranque sí.
Qué crea, y con qué nombres
Sección titulada «Qué crea, y con qué nombres»Aquí no hay nada que asigne Grafana, así que no hay nada que leer de vuelta y escribir en tu configuración. Los dos uid salen del nombre del almacén, y la misma ejecución dos veces escribe en los mismos dos sitios:
| Almacén | uid del dashboard | Su datasource |
|---|---|---|
influxdb | ghchronicle-influxdb | creado, desde el sink |
elasticsearch | ghchronicle-elasticsearch | creado, desde el sink |
postgres | ghchronicle-postgres | creado, desde el dsn |
prometheus | ghchronicle-prometheus | creado, si le das la dirección |
graphite | ghchronicle-graphite | creado, si le das la dirección |
Un datasource que esto crea toma el uid del dashboard, así que los dos son
ghchronicle-<almacén>, y uno que nombres tú conserva el uid que ya tenga. El
de Loki, cuando la dirección del sink explica dónde encontrarlo, es
ghchronicle-loki, salvo que Grafana ya tenga un datasource de Loki en esa
dirección y el sink no lleve tenant_id: ese se adopta y se deja como está,
porque un datasource de Loki sin tenant es su dirección y nada más. Con tenant
se crea siempre, porque el tenant viaja en un secreto que Grafana nunca
devuelve.
El datasource se crea la primera vez y se corrige después, y solo se comparan los campos que esto escribe, así que un tiempo de espera o una descripción que le hayas puesto tú se quedan como están. Uno que lleve credencial se escribe en cada ejecución, porque Grafana informa de qué secretos hay puestos y nunca de su valor: un token que rotes en la configuración no se puede ver desde fuera, y escribirlo es la única manera de asegurar que el datasource no sigue con el viejo.
El dashboard se publica con overwrite, así que la segunda ejecución actualiza
la primera en vez de añadir otra. Eso es lo que hace que publish_on_start se
pueda dejar encendido.
Una ejecución nombra además lo que encuentra bajo un uid al que ya no escribe. El caso que deja uno es cambiar de almacén: el dashboard y el datasource del viejo se quedan donde están, apuntando a algo que nadie llena, y el uid del nuevo es otra cadena, así que nada los sobreescribe. El aviso dice qué uid y qué almacén, y ahí se queda. Borrar un dashboard sin que nadie lo pida no es cosa de un colector, ni siquiera de uno que lo hizo él: puede ser la copia que alguien sigue mirando, o una que ha editado desde entonces.
Si el dashboard ya está en otro sitio
Sección titulada «Si el dashboard ya está en otro sitio»Importar el JSON desde la interfaz conserva el uid que trae el fichero, así que un dashboard importado así es el que esto sobreescribe y no hay nada que hacer. Solo cambia si se le pidió a Grafana importarlo como nuevo, o si se le cambió el uid a mano: entonces el uid generado está libre, una publicación crea un segundo dashboard al lado del que se está mirando, y el que está abierto deja de ser el que se actualiza. Nombra el que ya existe y se escribe ese:
grafana: dashboard_uid: mi-dashboard-existenteQuitarlo todo otra vez
Sección titulada «Quitarlo todo otra vez»-uninstall quita lo que esto puso, y solo eso. Recibe la lista de qué quitar,
y sin -yes no quita nada e imprime lo que quitaría, porque la alternativa es
una orden mal tecleada que vacía un almacén.
ghchronicle -config config.yaml -uninstall all # dice qué se iríaghchronicle -config config.yaml -uninstall all -yes # y entonces se va| Objetivo | Qué se va |
|---|---|
dashboard | Los dashboards que publicó, y los datasources que haya creado él |
data | Toda tabla del almacén cuyo nombre empiece por gh_ |
state | El fichero de estado, el libro de deduplicación, la caché, los puntos de control del relleno y de la relectura y el fichero de bloqueo que hay a su lado |
all | Los tres de arriba |
Con -yes, data y state toman antes el bloqueo que hay junto al fichero de
estado, y se niegan, nombrando el proceso, mientras lo tiene el servicio o un
-migrate -yes: lo que quitan es lo que ese proceso sigue escribiendo, y el
fichero de bloqueo está entre los ficheros de estado, así que quitado bajo un
servicio en marcha dejaría al siguiente -migrate -yes correr a su lado.
Un datasource nombrado en grafana.datasource.uid o en
grafana.datasource.loki_uid no se quita nunca, ni tampoco un datasource de
Loki que haya adoptado: cada uno era de otro antes de que esto corriera y sigue
siéndolo. Un objetivo que no reconoce
se rechaza entero, en vez de ejecutar el resto de la lista sin él.
Las tablas se le preguntan al almacén en vez de llevarlas compiladas. Una lista dentro del binario serían las mediciones que escribe esta versión, y las que merece la pena quitar son justo las que ya no escribe nadie: lo que recogía una versión anterior, o una familia apagada desde entonces. Preguntando aparecen.
No todos los almacenes se pueden vaciar desde aquí, y los que no dicen por qué en vez de callarse, que se leería como que no hay nada que quitar. Graphite no ofrece borrado, así que sus ficheros whisper se quitan a mano. El sink de Prometheus se raspa en vez de recibir escrituras, así que no guardó nada que quitar. El fichero del sink SQL sí se borra, pero las filas que ya cargaste de ahí a una base de datos de verdad las cargaste tú y hay que quitarlas allí: este sink emite sentencias y nunca se conecta.
Importar desde la interfaz
Sección titulada «Importar desde la interfaz»-
En Grafana, ve a Dashboards, luego New, luego Import.
-
Sube el
ghchronicle-<almacén>.jsondel almacén que estés usando. -
Elige el datasource que pide Grafana.
El datasource de InfluxDB 3 para la base de datos en la que escribe el destino, en modo SQL.
El Prometheus que consulta el exportador de ghchronicle.
El datasource de PostgreSQL para la base de datos en la que escribe el destino
postgres, o a la que se enviaron las sentencias del destino SQL. TimescaleDB es el mismo datasource con el interruptor de TimescaleDB activado; las consultas no cambian.El Graphite en el que escribe el destino. Las rutas suponen el prefijo por omisión,
github, y las funciones necesitan Graphite 1.1 o posterior.Un datasource de Elasticsearch cuyo patrón de índice sea
ghchronicle-*y cuyo campo de tiempo sea@timestamp. Un solo datasource sirve a todos los paneles, porque cada objetivo nombra su propio índice en la consulta. OpenSearch funciona con el mismo plugin.
Importar con la API
Sección titulada «Importar con la API»Nombra la entrada que declara el fichero:
curl -X POST -H "Authorization: Bearer $TOKEN" -H "Content-Type: application/json" \ -d "{\"dashboard\": $(cat ghchronicle-influxdb.json), \"inputs\": [ {\"name\":\"DS_INFLUXDB\",\"type\":\"datasource\",\"pluginId\":\"influxdb\",\"value\":\"<uid>\"}], \"overwrite\": true}" \ "$GRAFANA/api/dashboards/import"Las entradas son DS_INFLUXDB (influxdb), DS_PROMETHEUS (prometheus),
DS_POSTGRES (grafana-postgresql-datasource), DS_GRAPHITE (graphite) y
DS_ELASTICSEARCH (elasticsearch).
Cada fichero lleva un uid fijo (ghchronicle-<almacén>). Eso es deliberado
para una importación desde el repositorio, donde un uid estable significa una
URL estable y una reimportación actualiza en el sitio en vez de duplicar.
Importar dos de estos en un mismo Grafana no da problemas, porque los uid
difieren por almacén y no pueden chocar.
Son generados, nunca editados a mano
Sección titulada «Son generados, nunca editados a mano»Una sola lista de secciones y paneles produce los cinco, así que un panel
arreglado queda arreglado en todos y un almacén que se añade los hereda. Lo que
eso significa para ti es la parte que importa: un dashboard editado en Grafana
es tuyo hasta que la siguiente publicación lo sobreescriba, así que guarda tus
cambios en una copia con un uid propio y nómbrala en grafana.dashboard_uid.
Cómo funciona el generador, y las comprobaciones que mantienen en paso los ficheros y las consultas de los paneles, están en CONTRIBUTING.
Publicar en el directorio de Grafana
Sección titulada «Publicar en el directorio de Grafana»Los ficheros ya tienen la forma que exige el directorio: __inputs declara el
datasource que quien importa debe elegir, __requires nombra la versión de
Grafana y el plugin, y no hay clave id, que el directorio asigna al publicar.
Conserva nombres de listado distintos, porque cinco dashboards con el mismo título son indistinguibles en los resultados de búsqueda: “ghchronicle for InfluxDB”, “ghchronicle for Prometheus”, “ghchronicle for PostgreSQL and TimescaleDB”, “ghchronicle for Graphite”, “ghchronicle for Elasticsearch and OpenSearch”.
Publicar de nuevo contra el mismo listado añade una revisión en vez de reemplazarlo, así que una regeneración que cambie paneles es una revisión nueva de los mismos cinco listados, no cinco listados nuevos.
Eso es lo que necesita saber quien lee. El paso a paso, con los nombres de los
listados, qué debe mostrar cada captura y qué hacer cuando rechazan una
revisión, es tarea de quien mantiene el proyecto y vive en
dashboards/PUBLISHING.md
dentro del repositorio.