Dashboards
Cinco dashboards de Grafana, uno por cada almacén que Grafana puede consultar (InfluxDB 3,
Prometheus, PostgreSQL, Graphite y Elasticsearch), generados a partir de una única lista de paneles
en internal/dashboards/, con un fichero de reglas de alerta junto a tres de ellos
(Reglas de alerta). install no los pone en Grafana: solo
escribe en el router.
Los dashboards están en inglés. Los títulos de filas y paneles se citan aquí tal como los muestra Grafana, sin traducir, para que puedas encontrarlos.
Llevarlos a Grafana
Sección titulada «Llevarlos a Grafana»Un dashboard lee el almacén en el que escribe el colector (Ejecutar el colector), y llega a Grafana de una de tres formas:
- Desde el colector:
forward … --grafana <url>crea la fuente de datos y publica el dashboard en cada arranque, ydashboards publishhace lo mismo una sola vez (detalles). - Con la CLI:
dashboards import --store <almacén> --datasource-uid <uid>, contra una fuente de datos que ya tengas (detalles). - A mano: sube el JSON en Grafana (detalles).
Configurar en Grafana tiene la fuente de datos de cada almacén y la comprobación que ejecuta cada panel.
Capturas
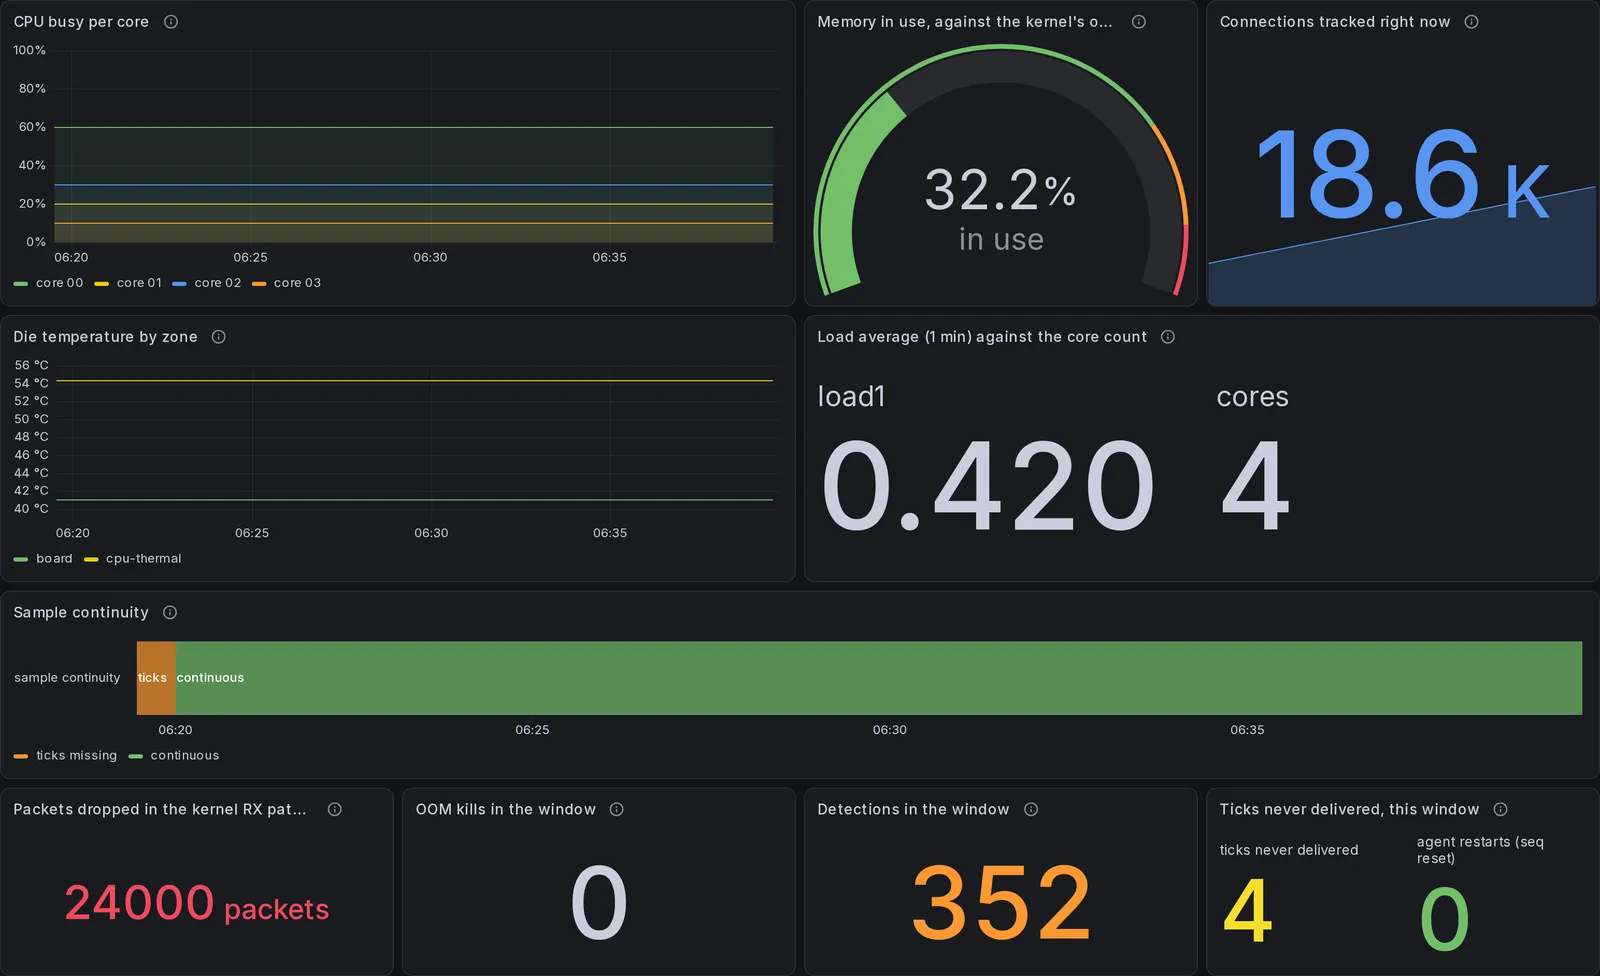
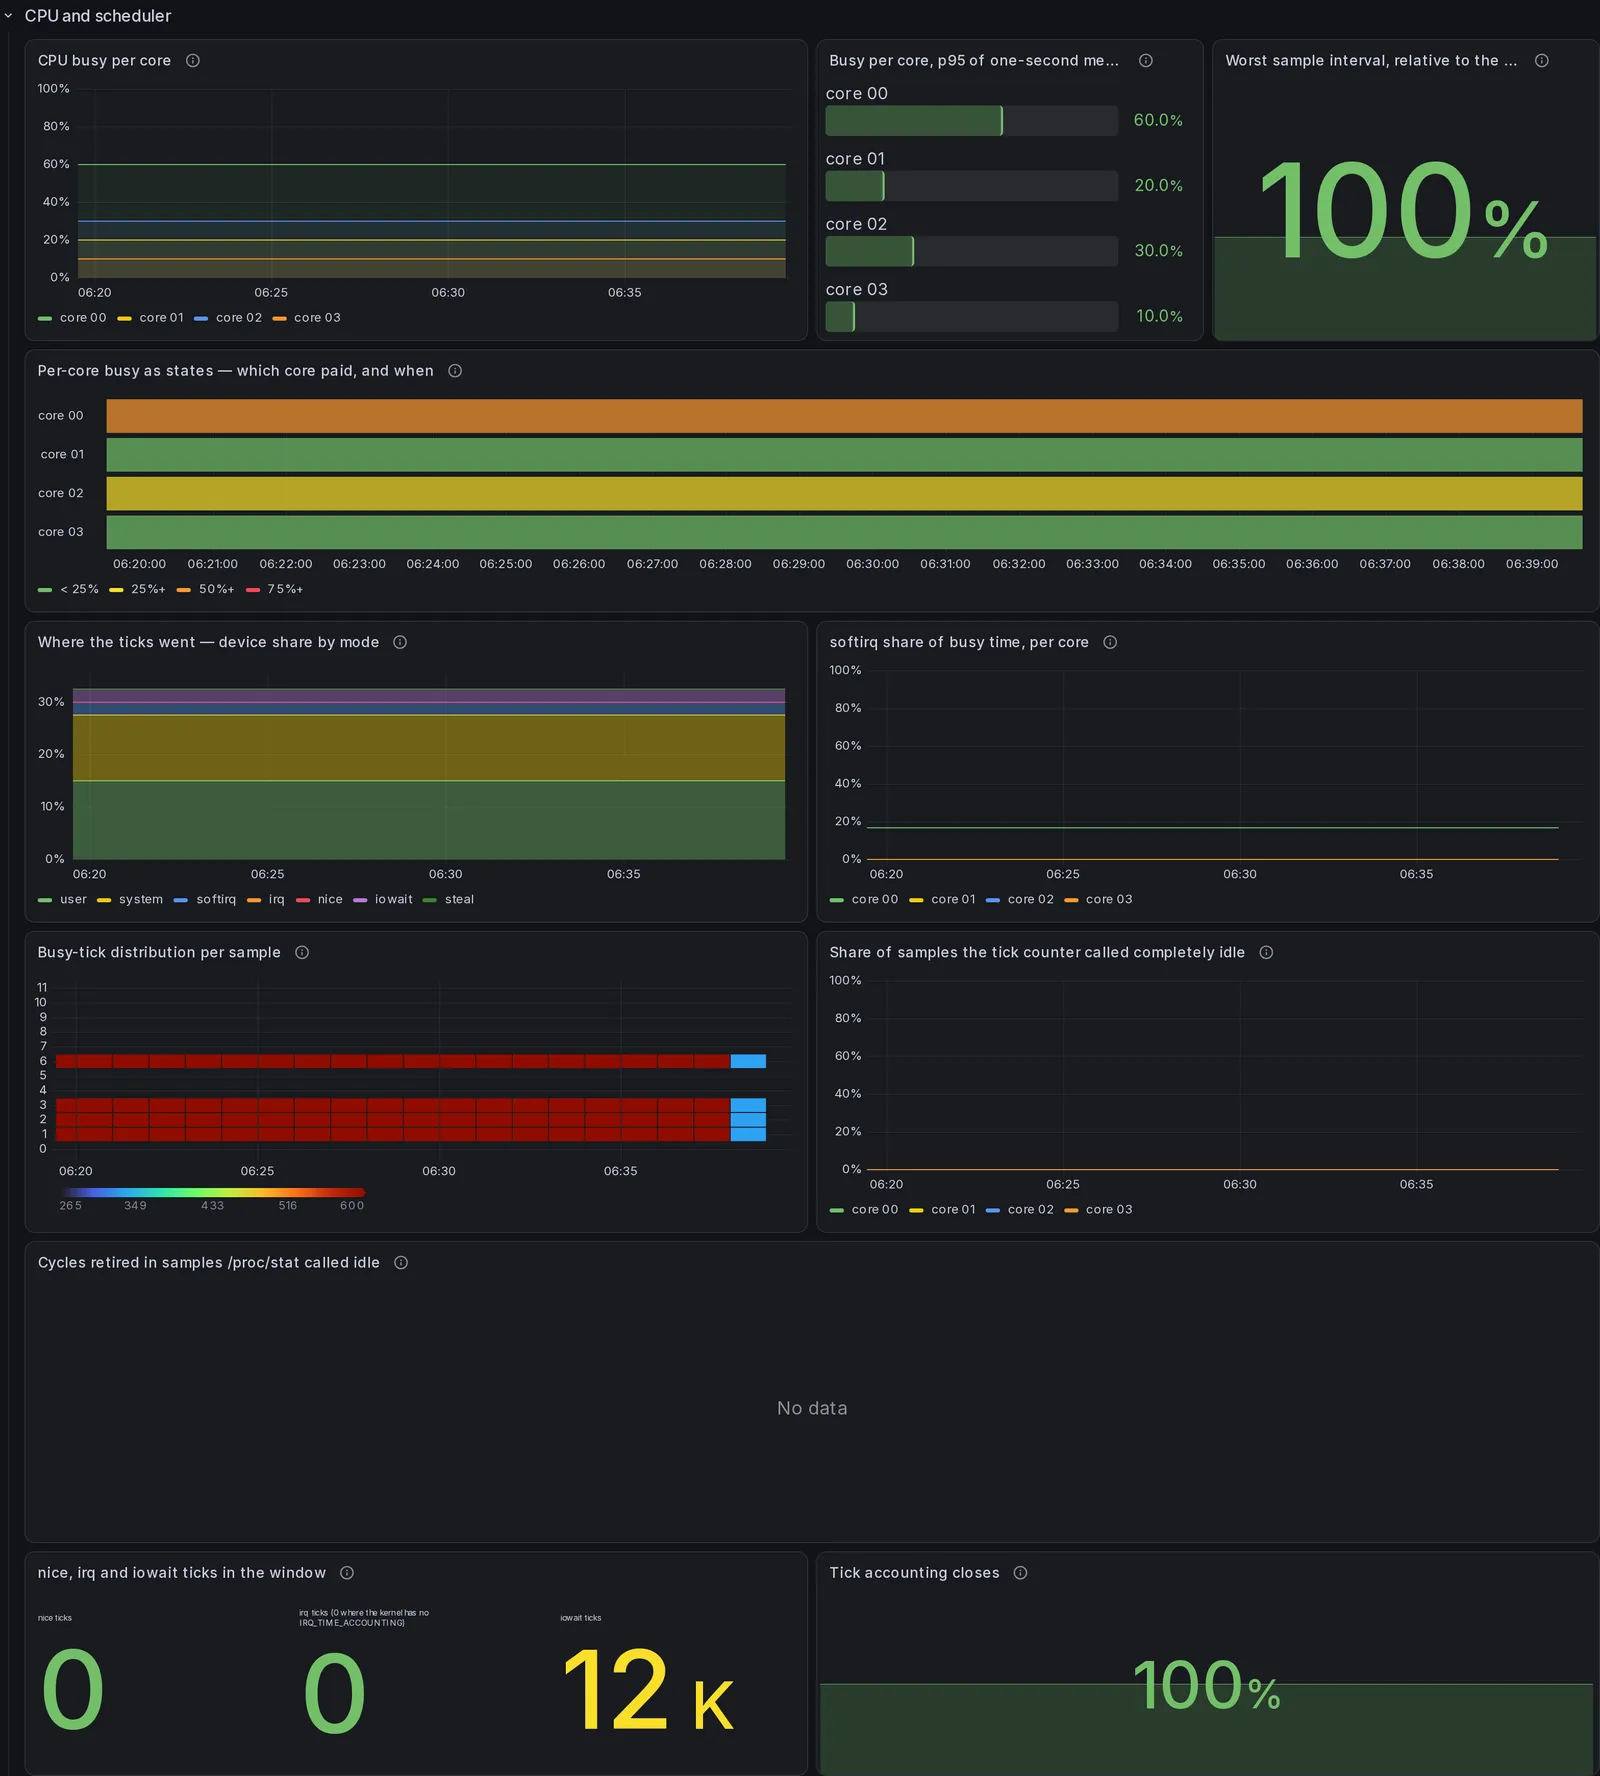
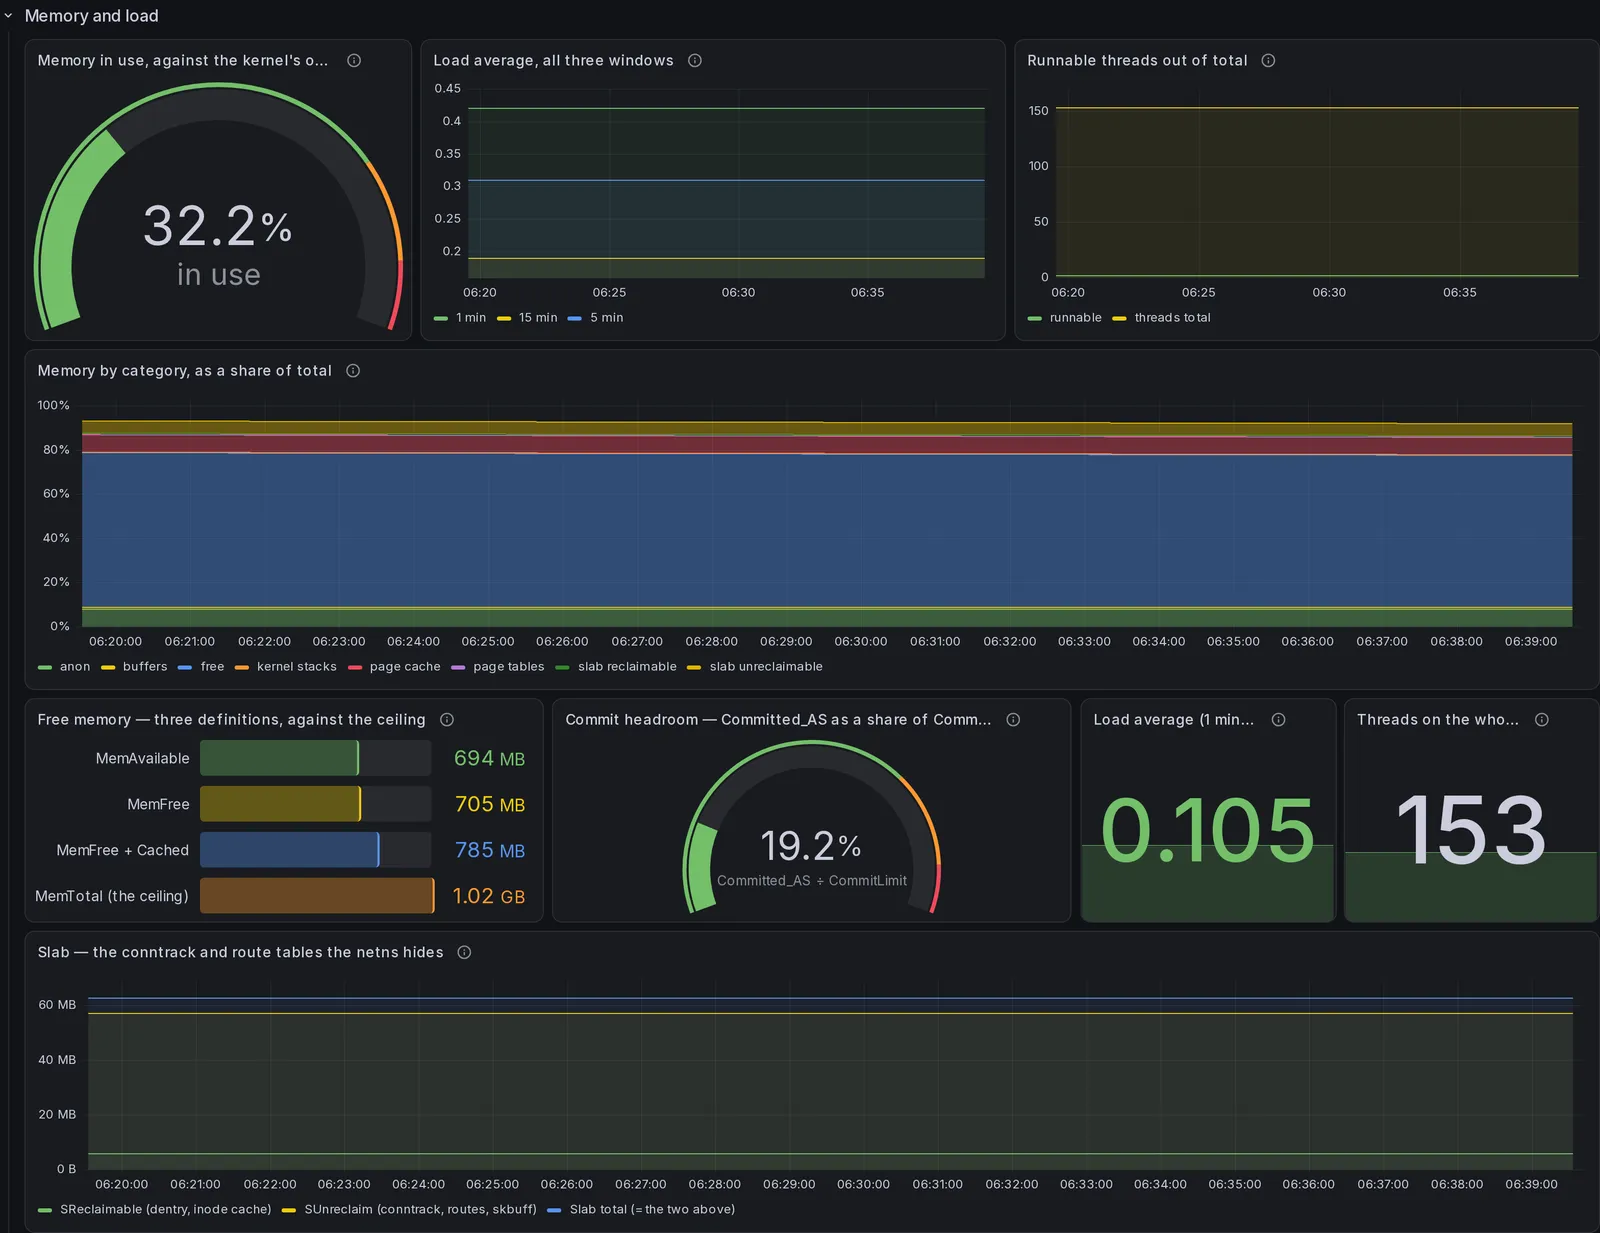
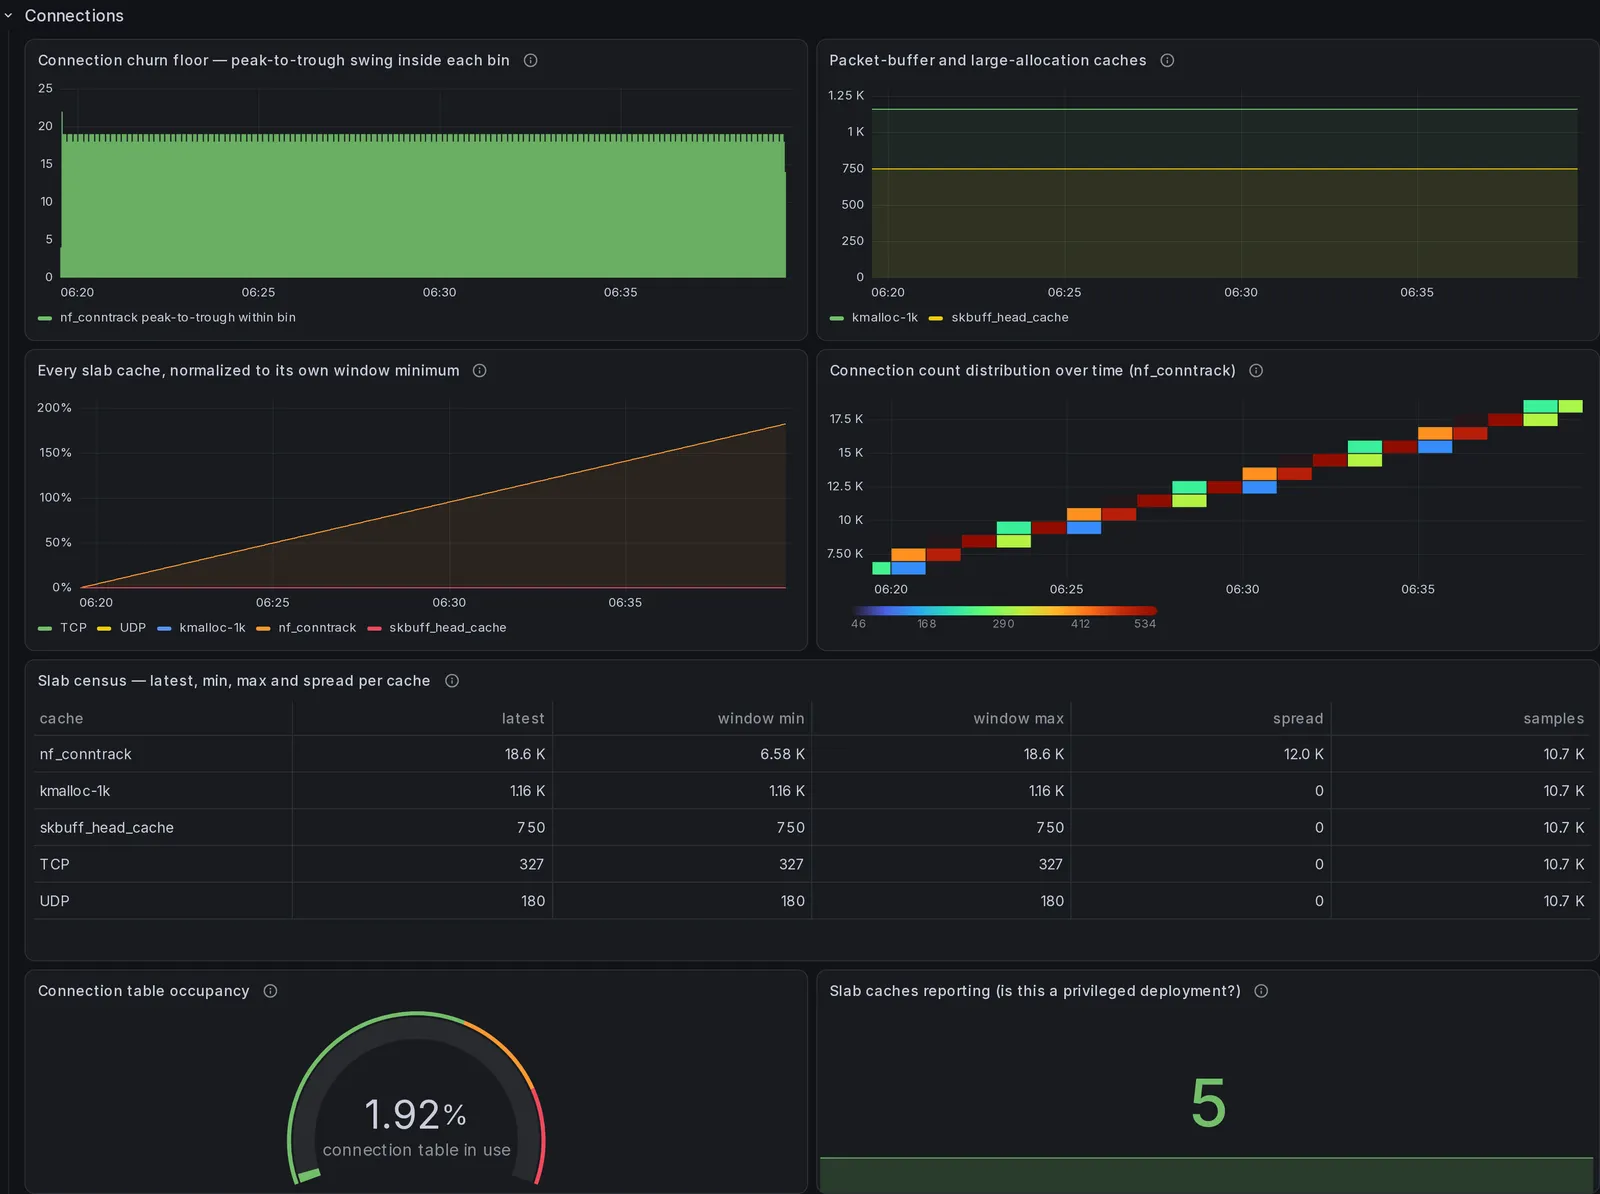
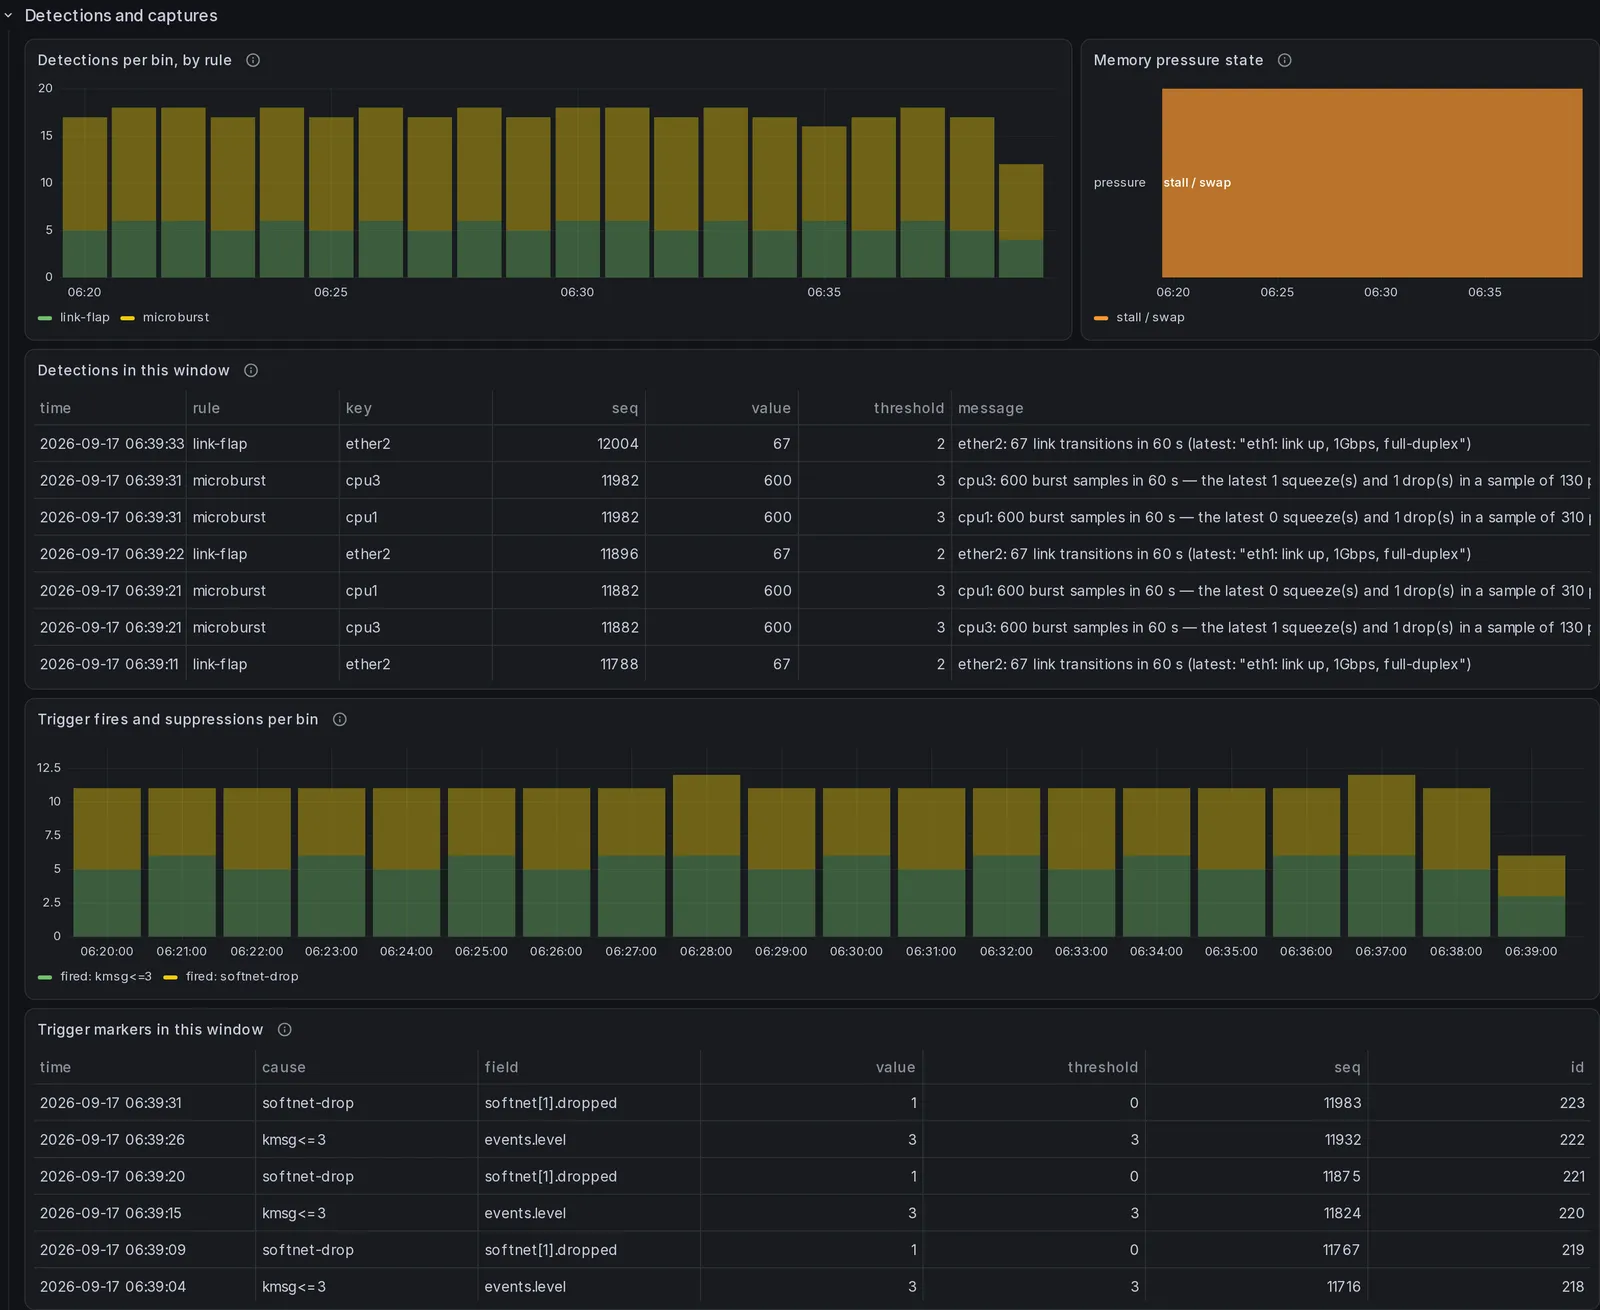
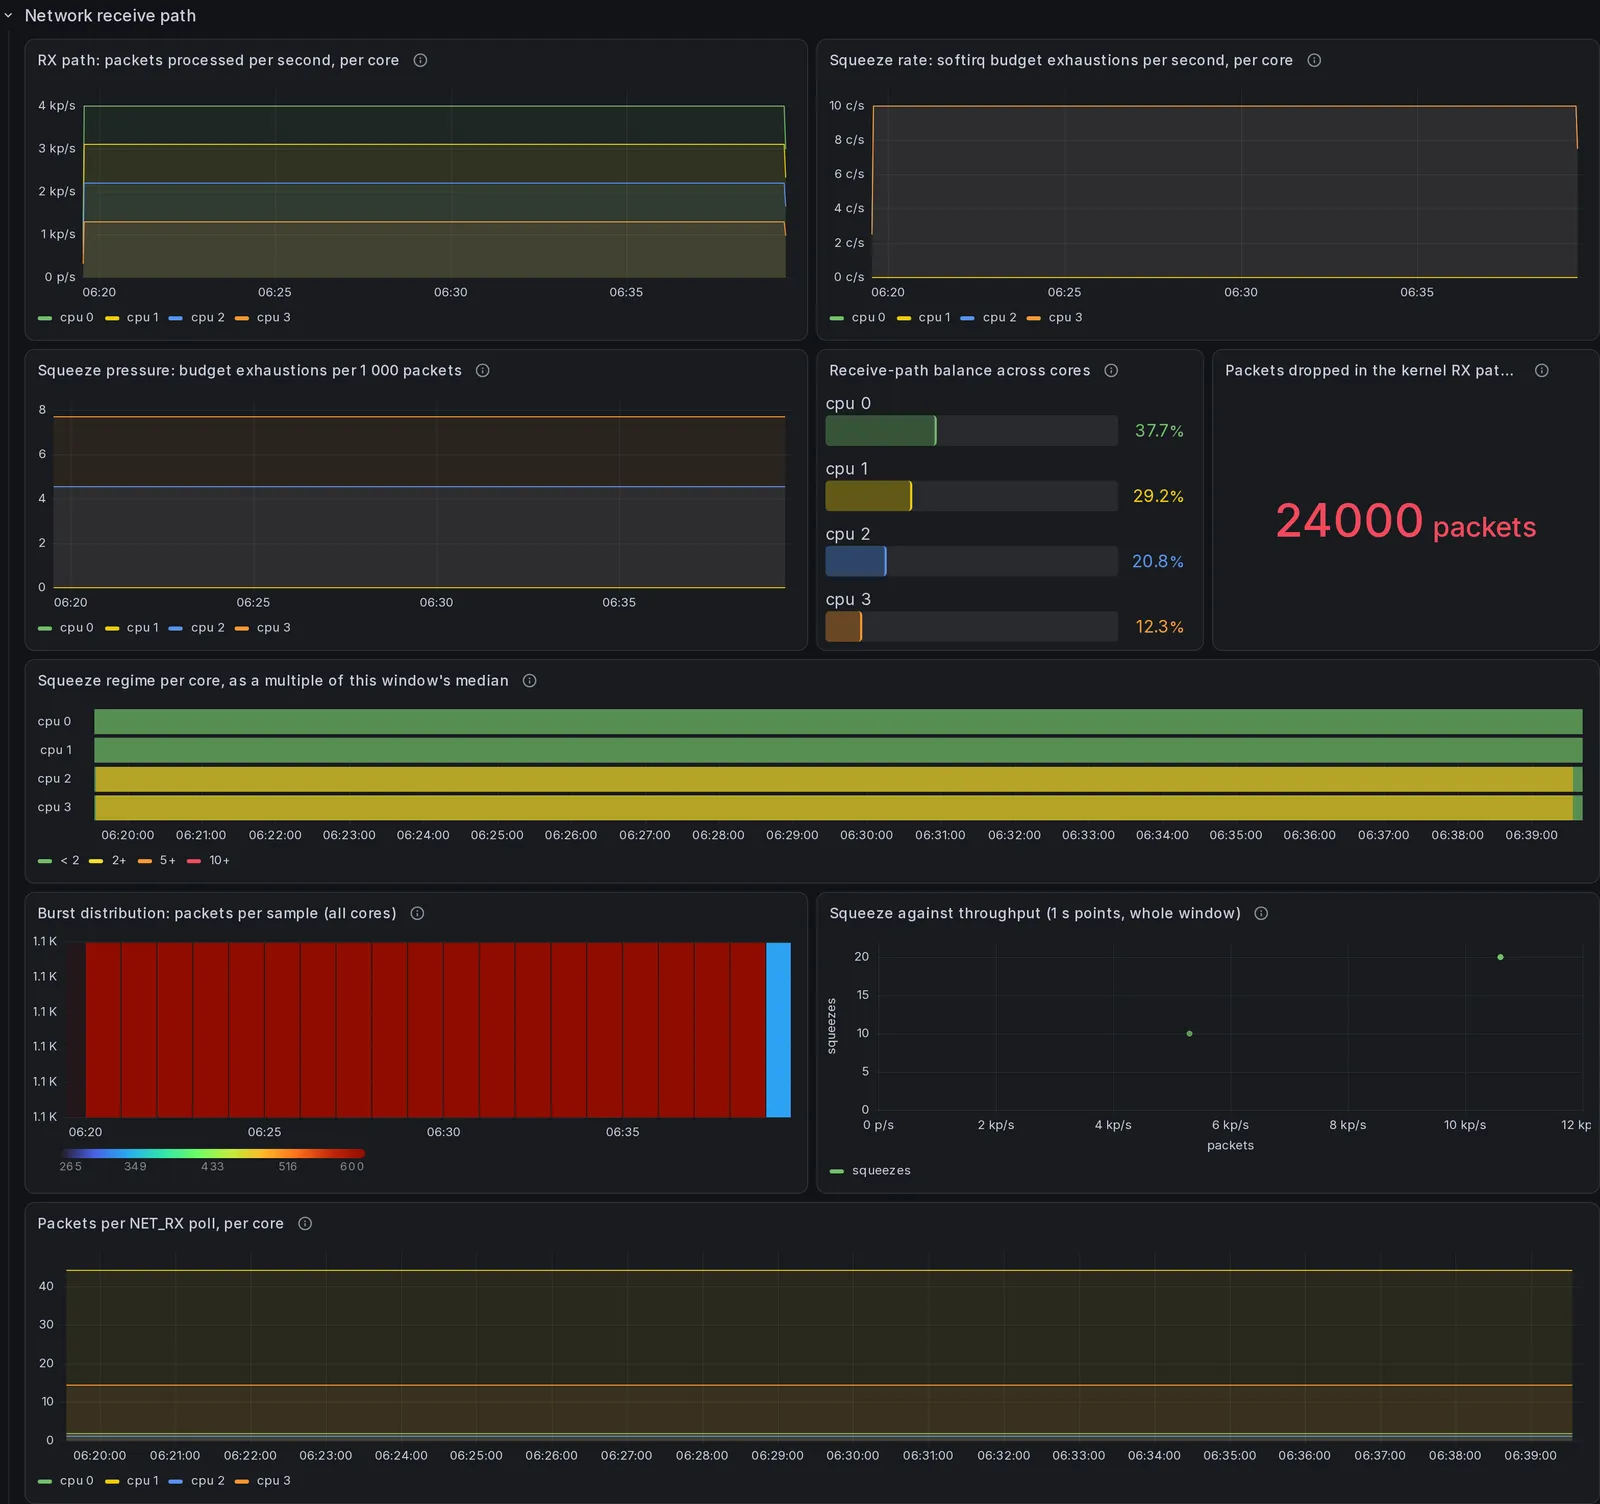
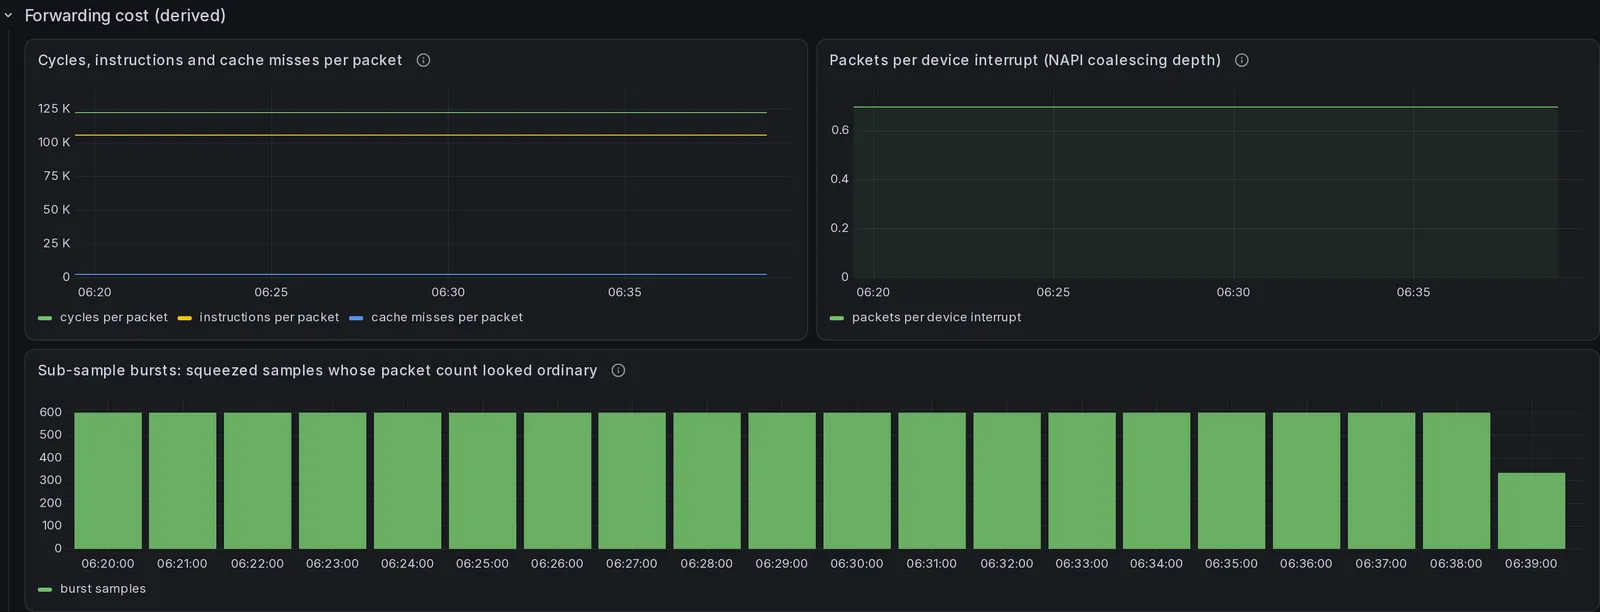
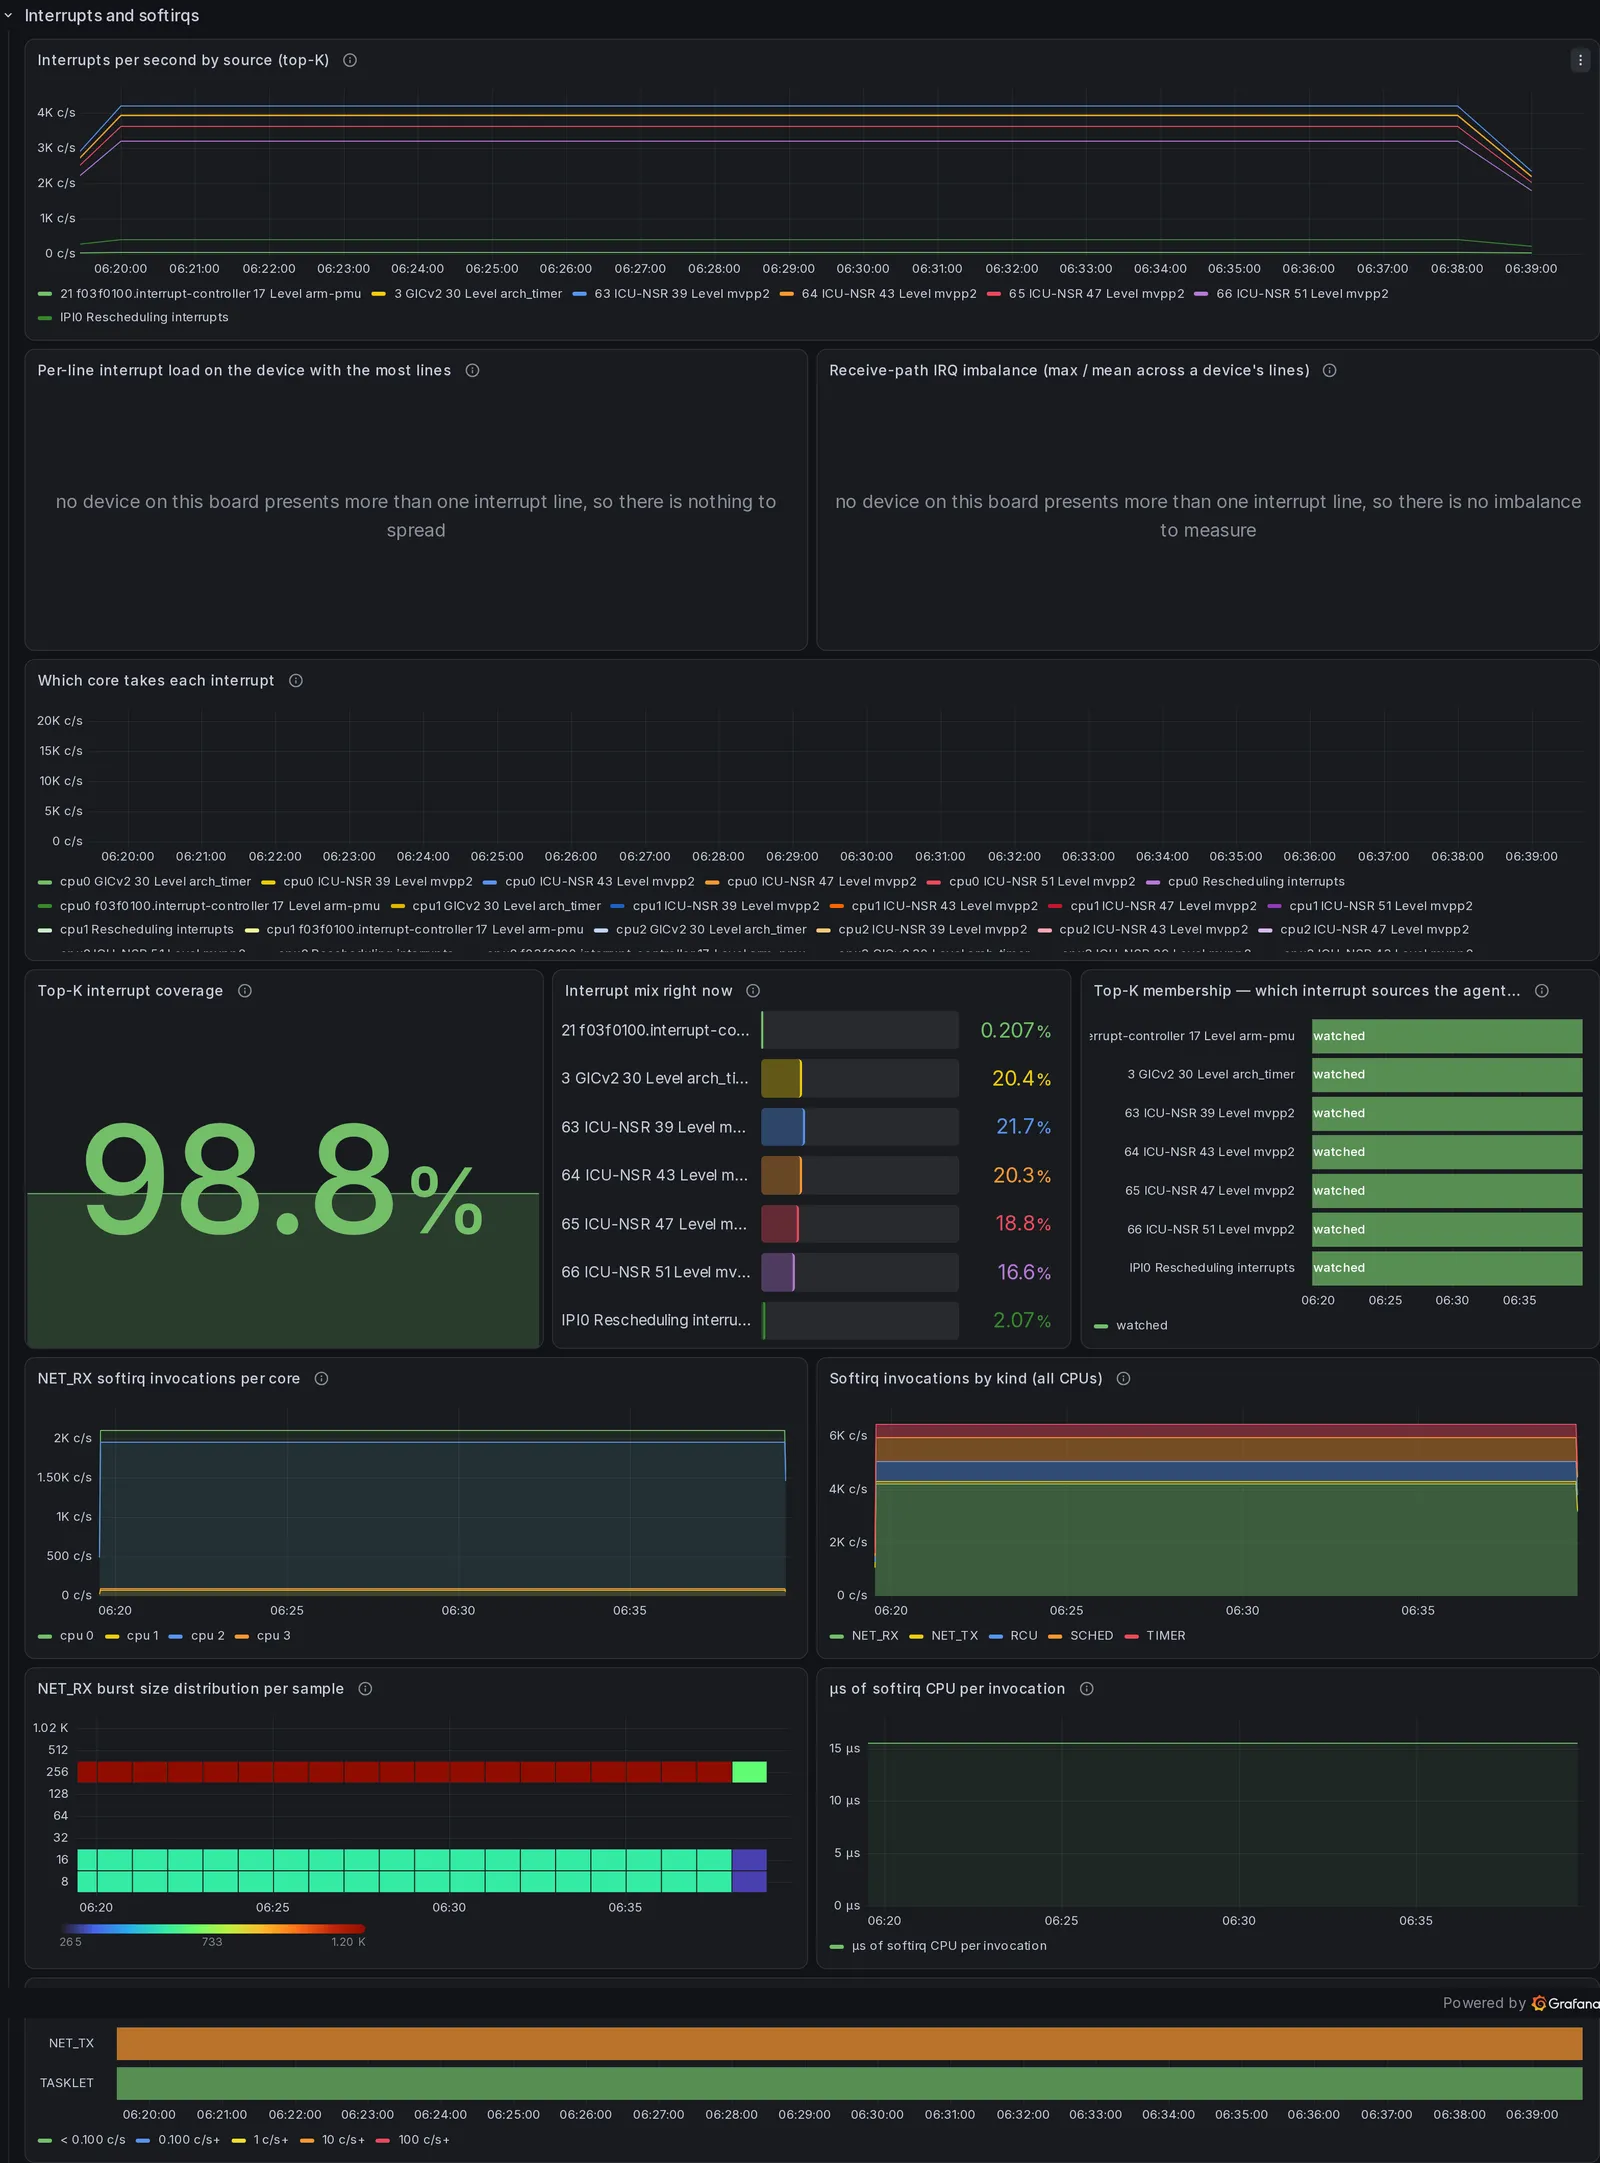
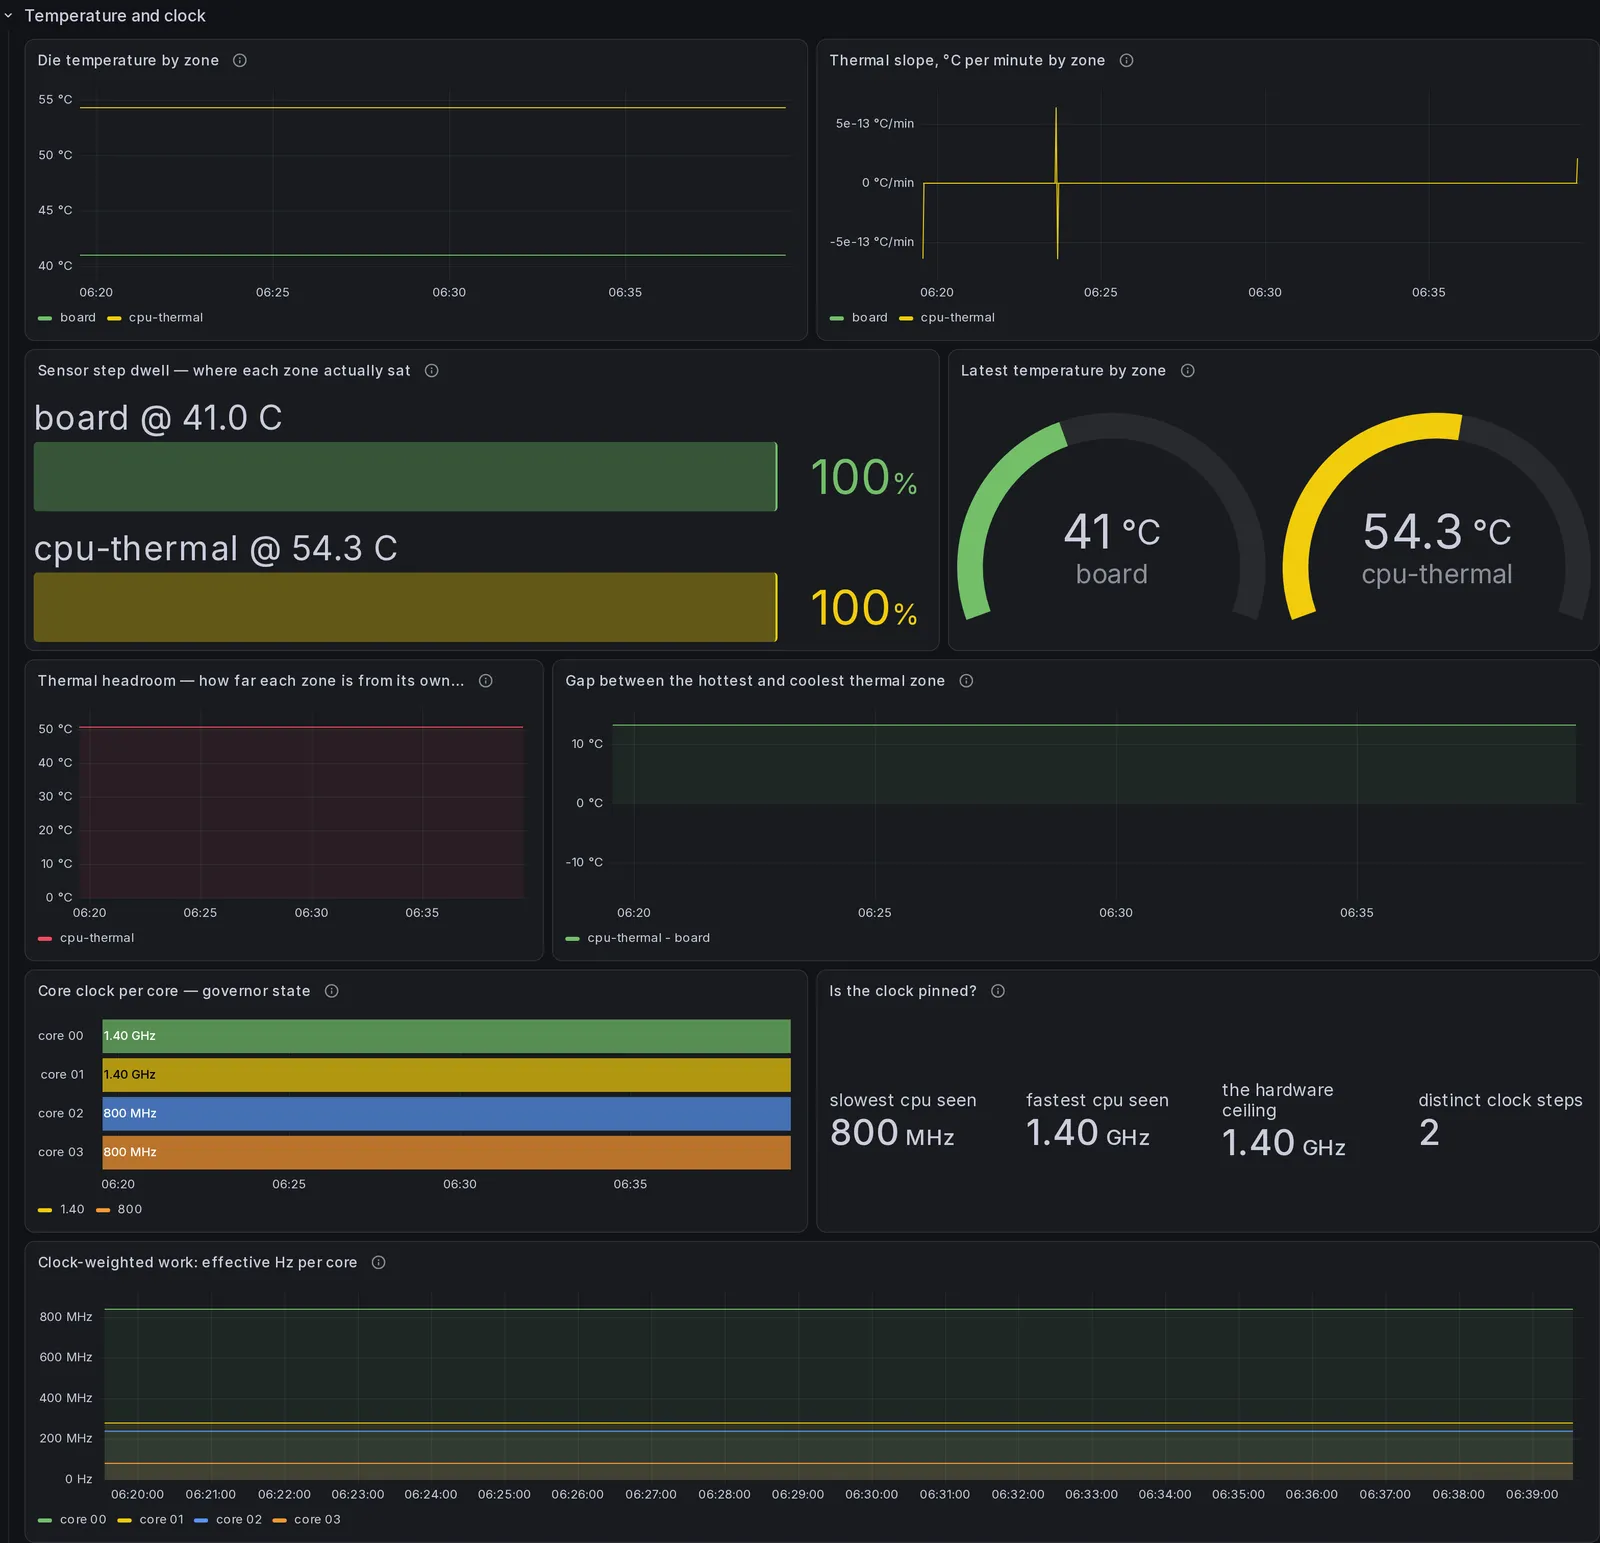
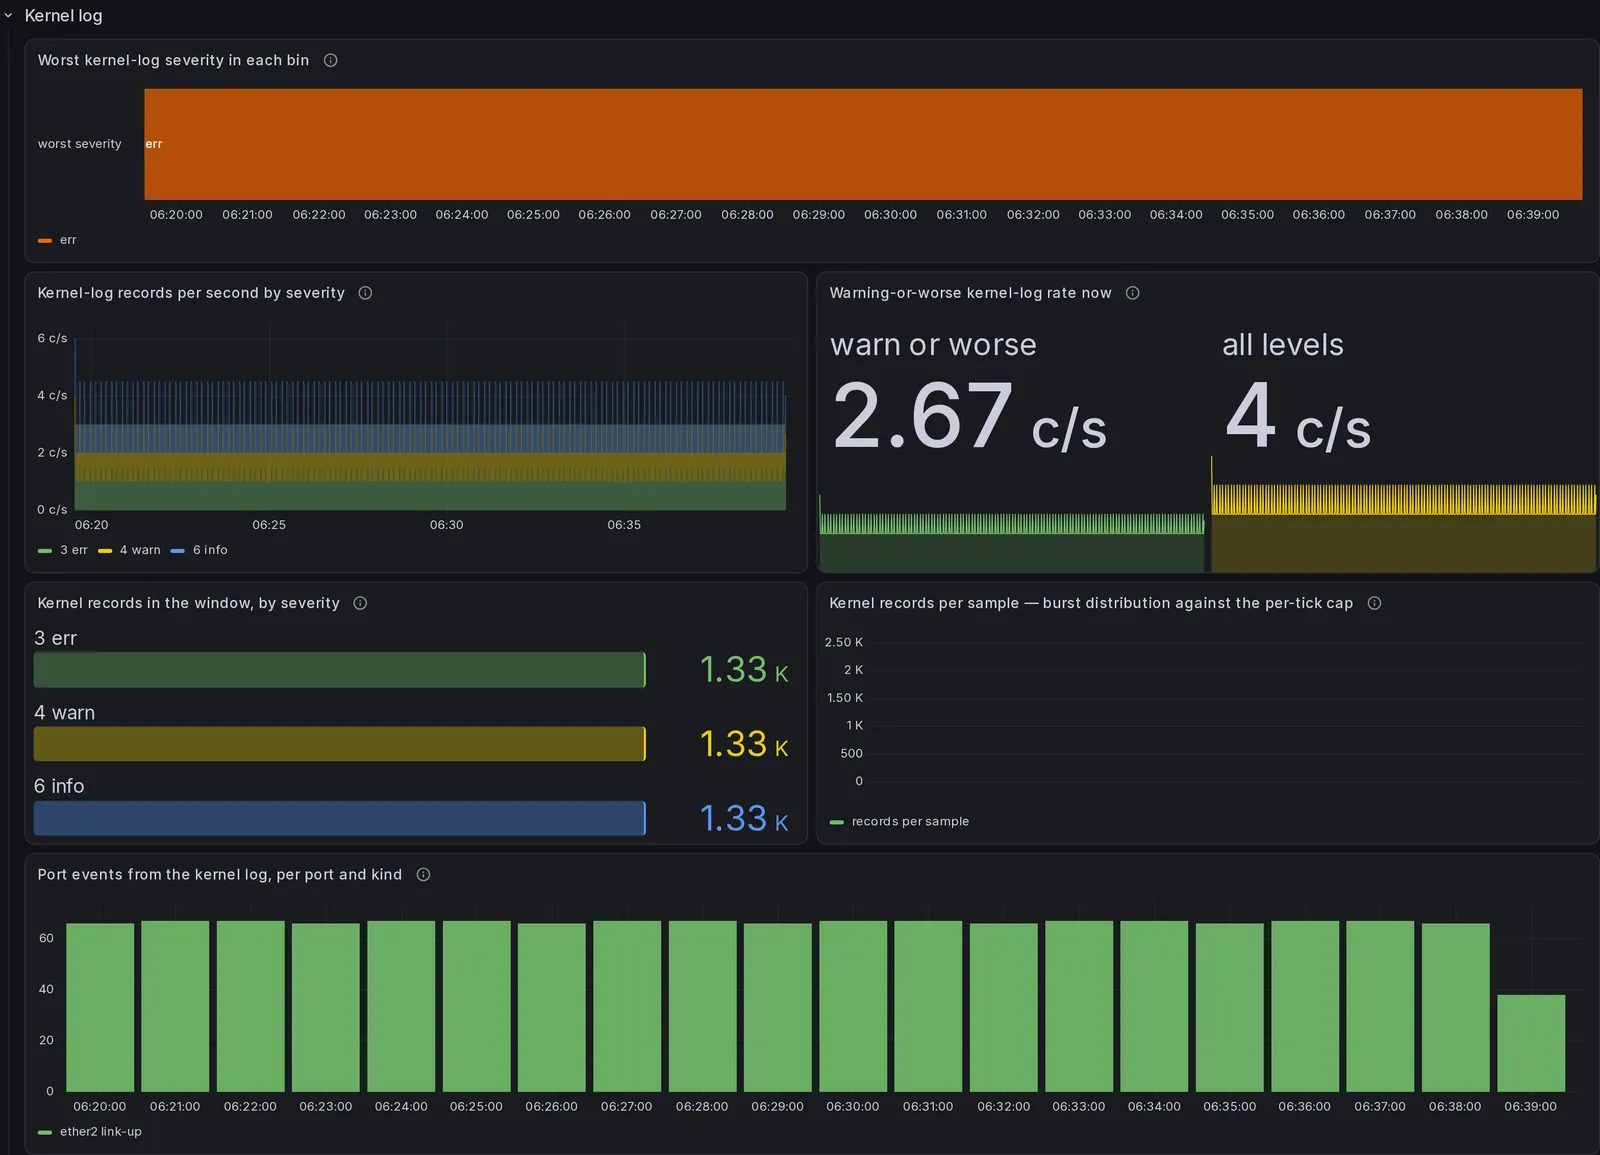
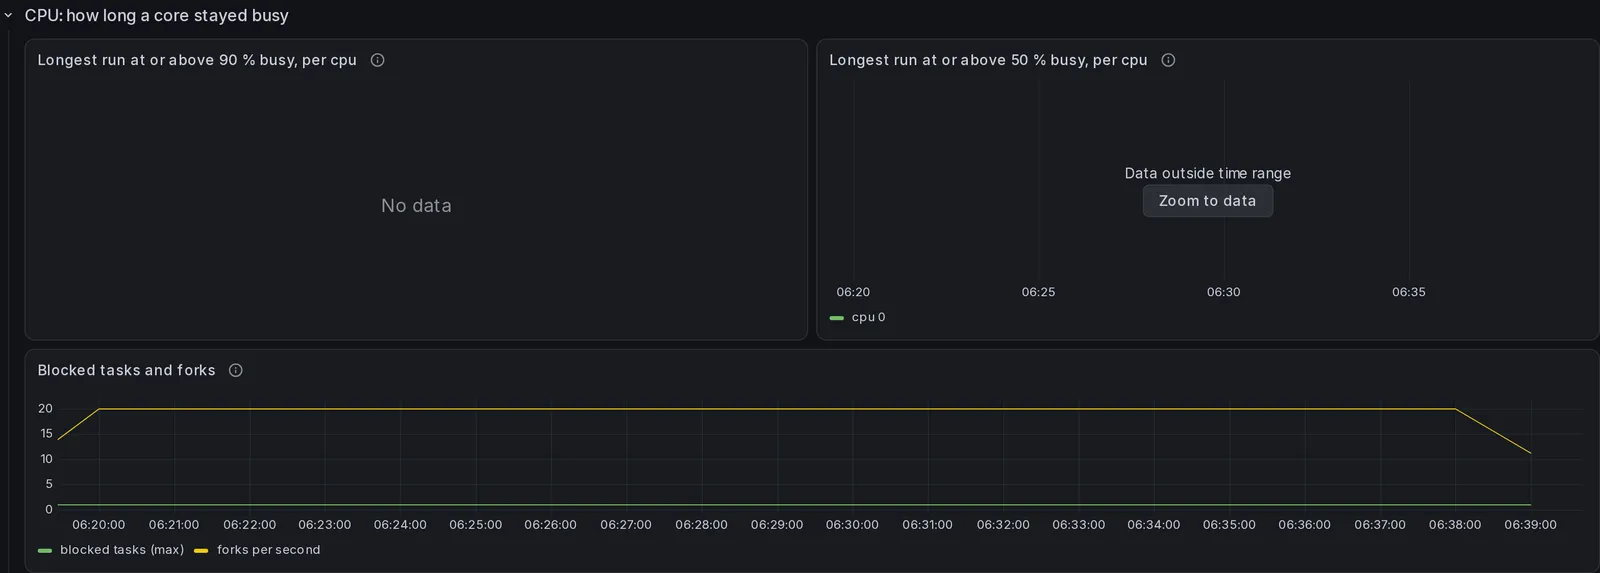
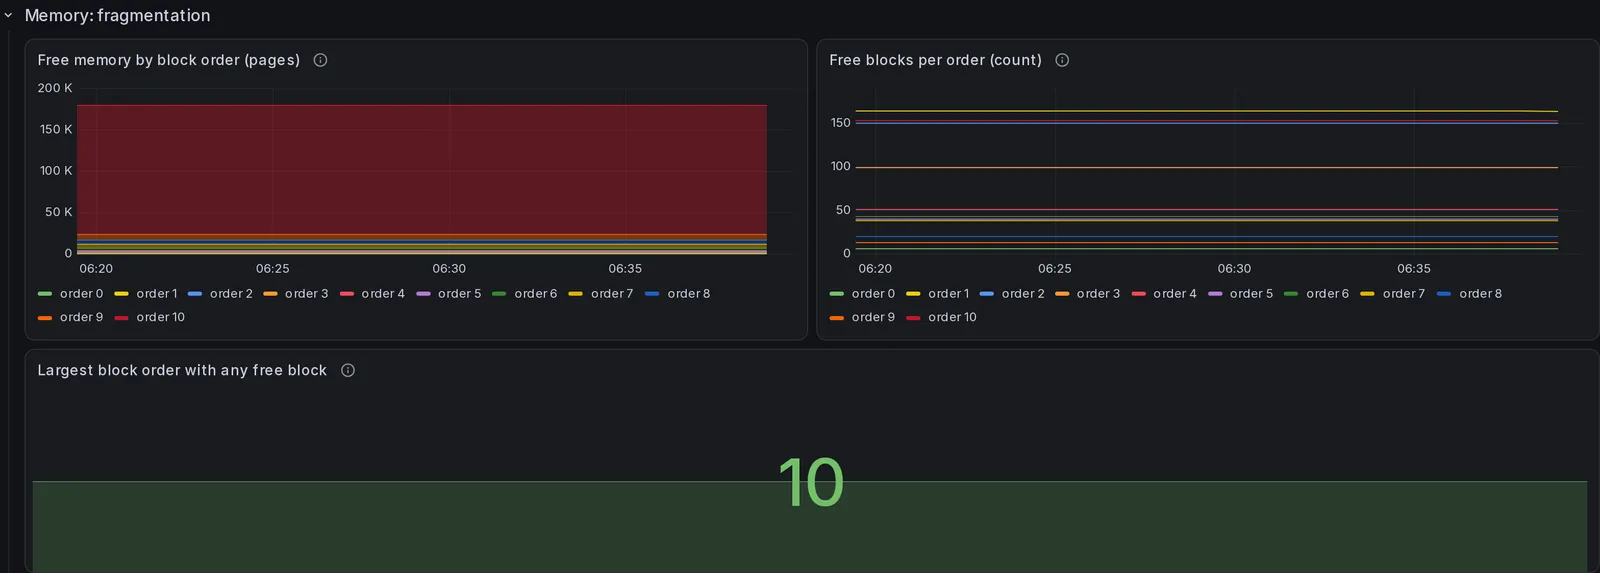
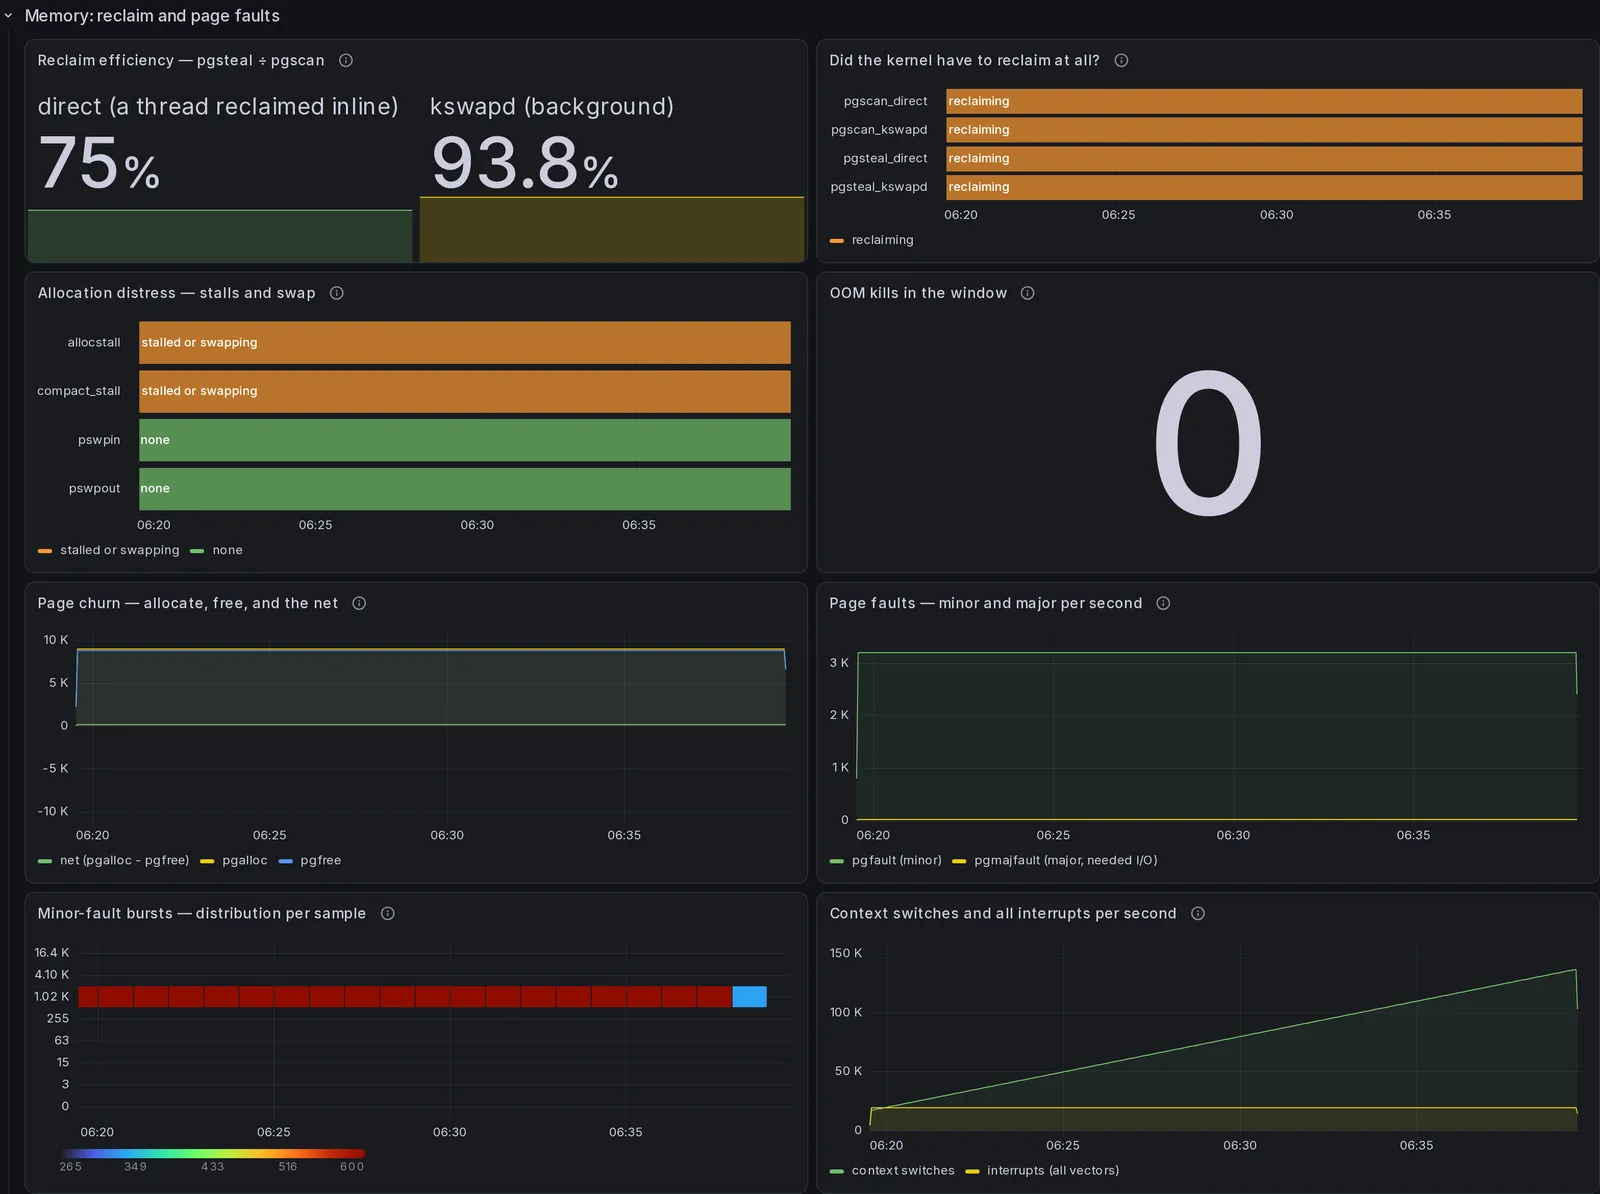
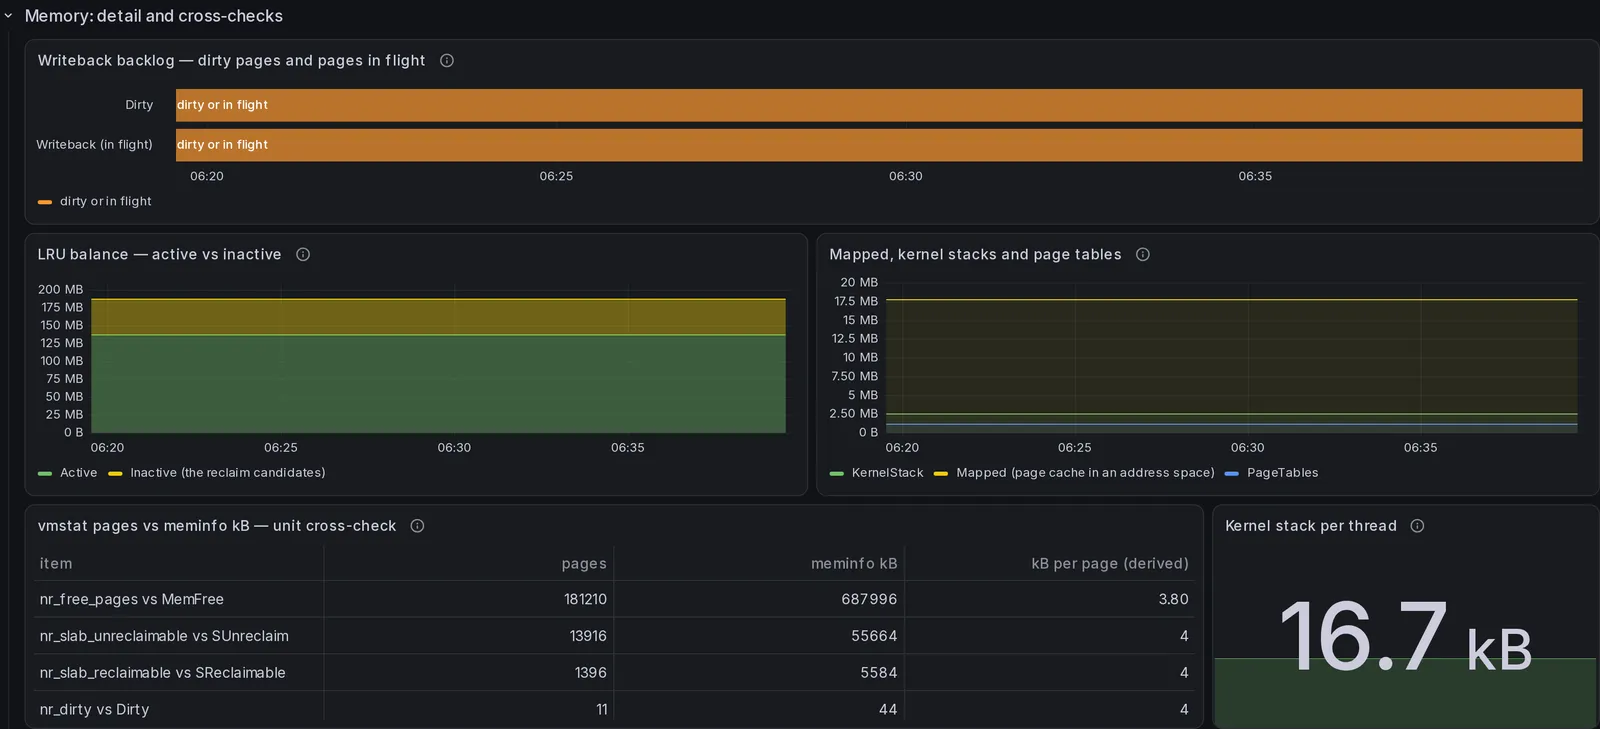
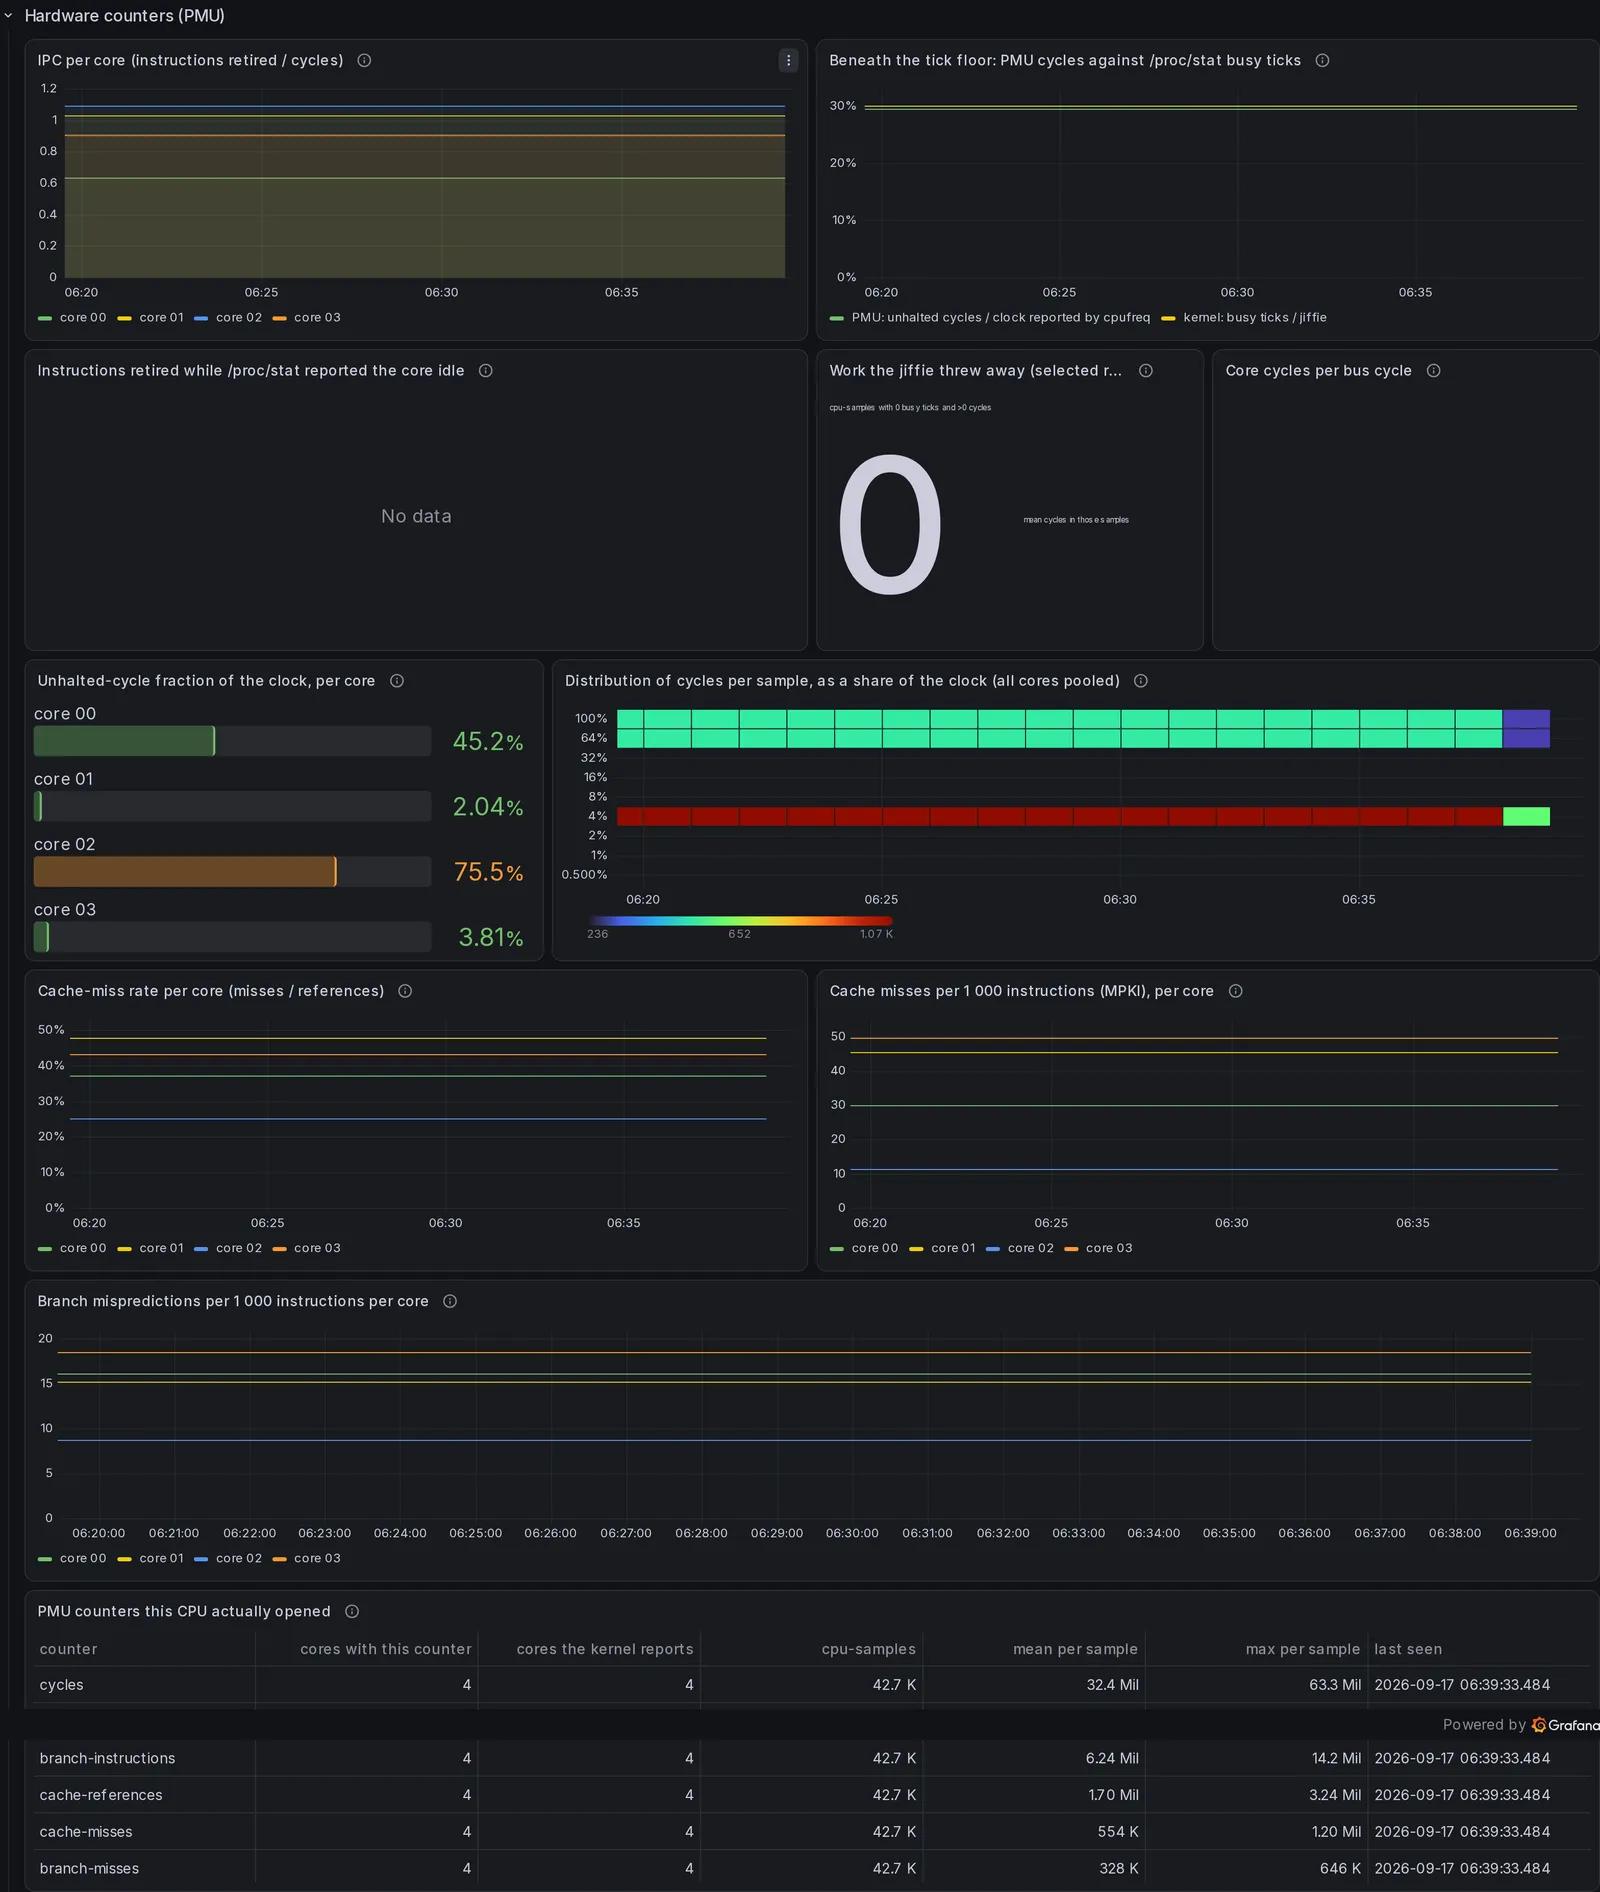
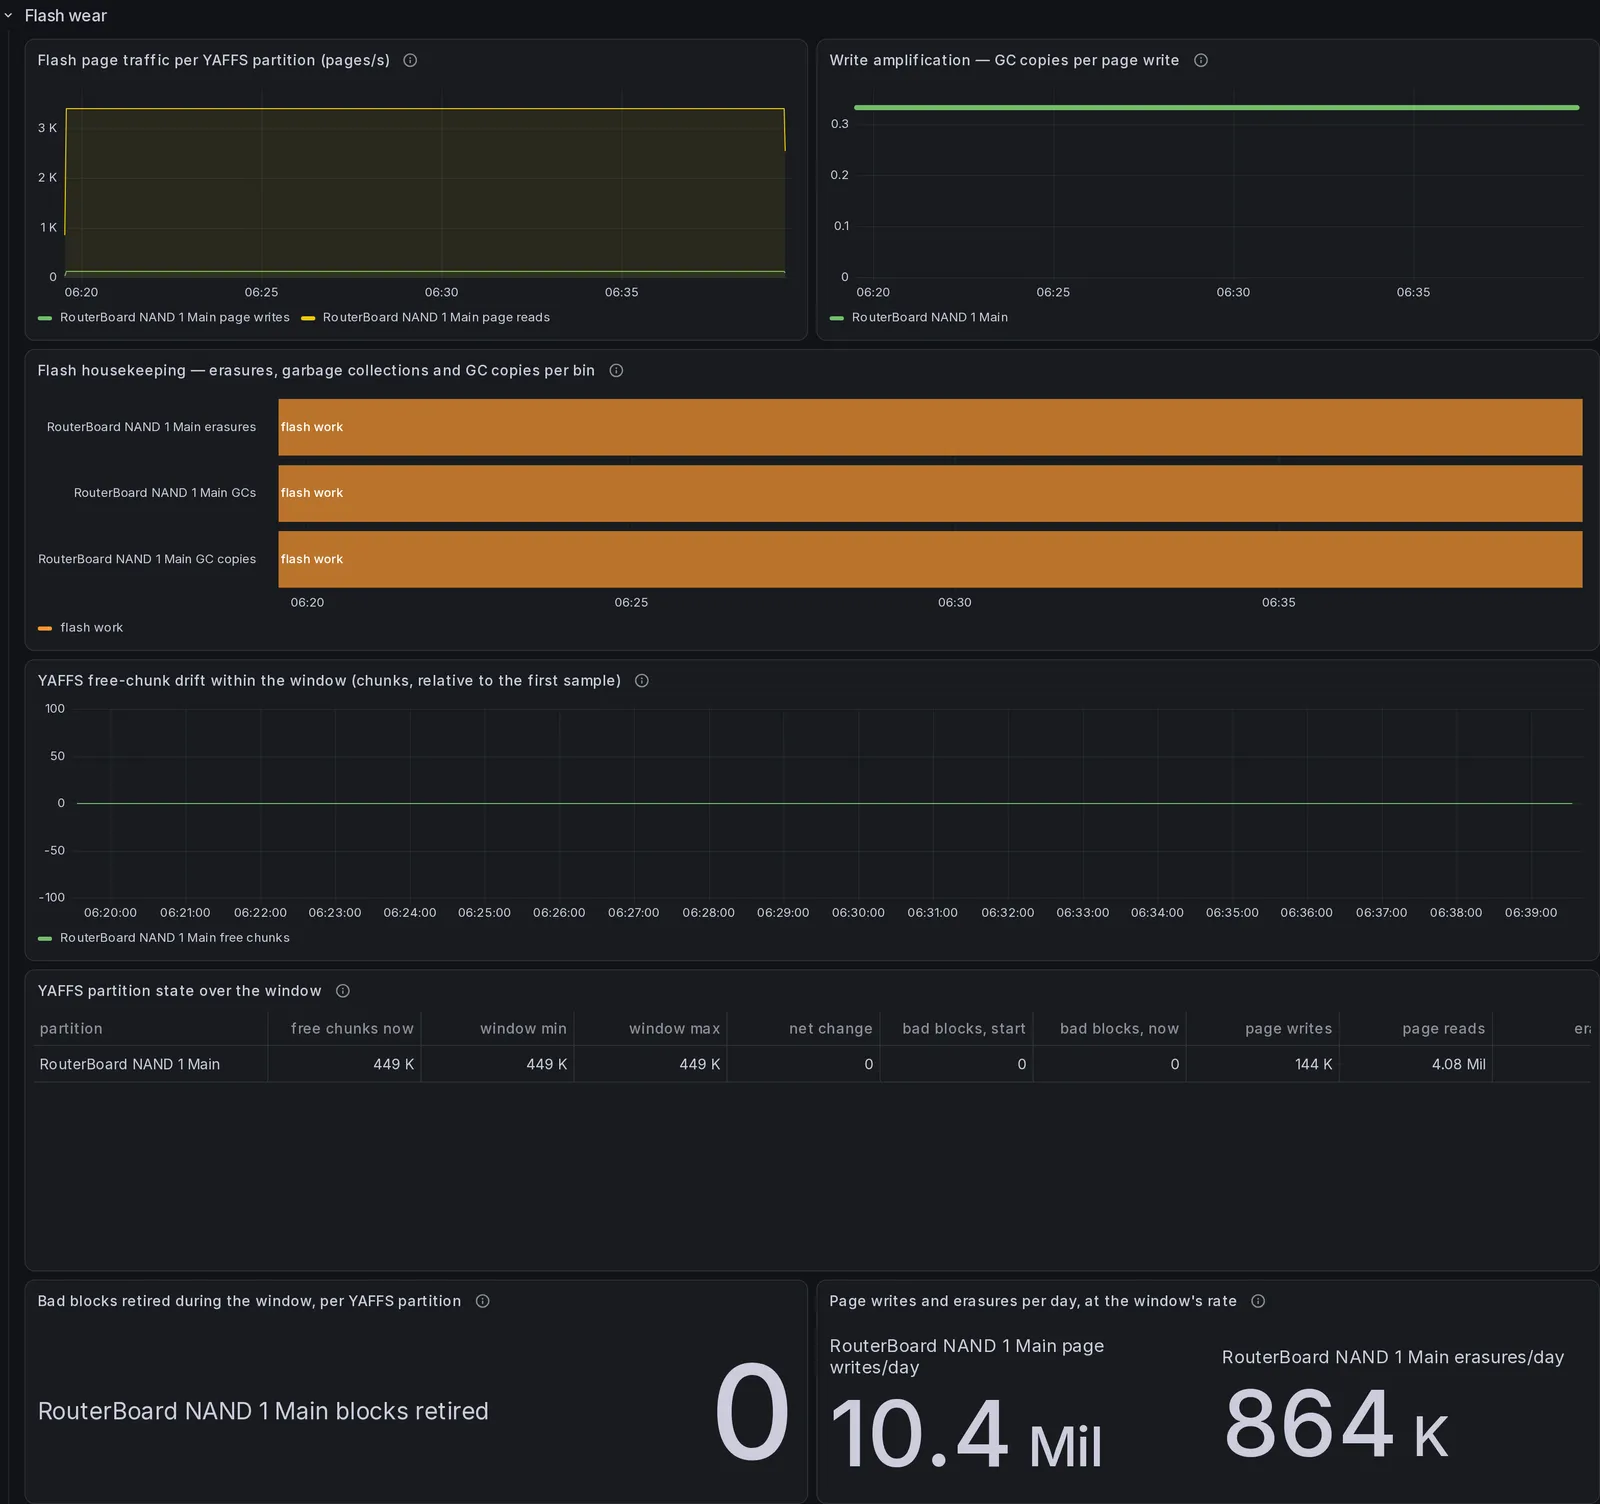
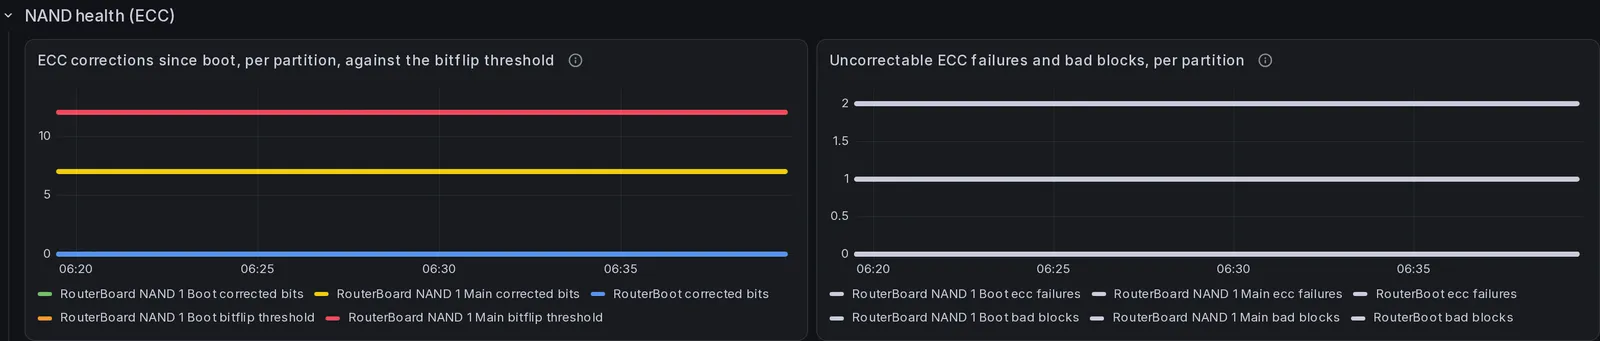
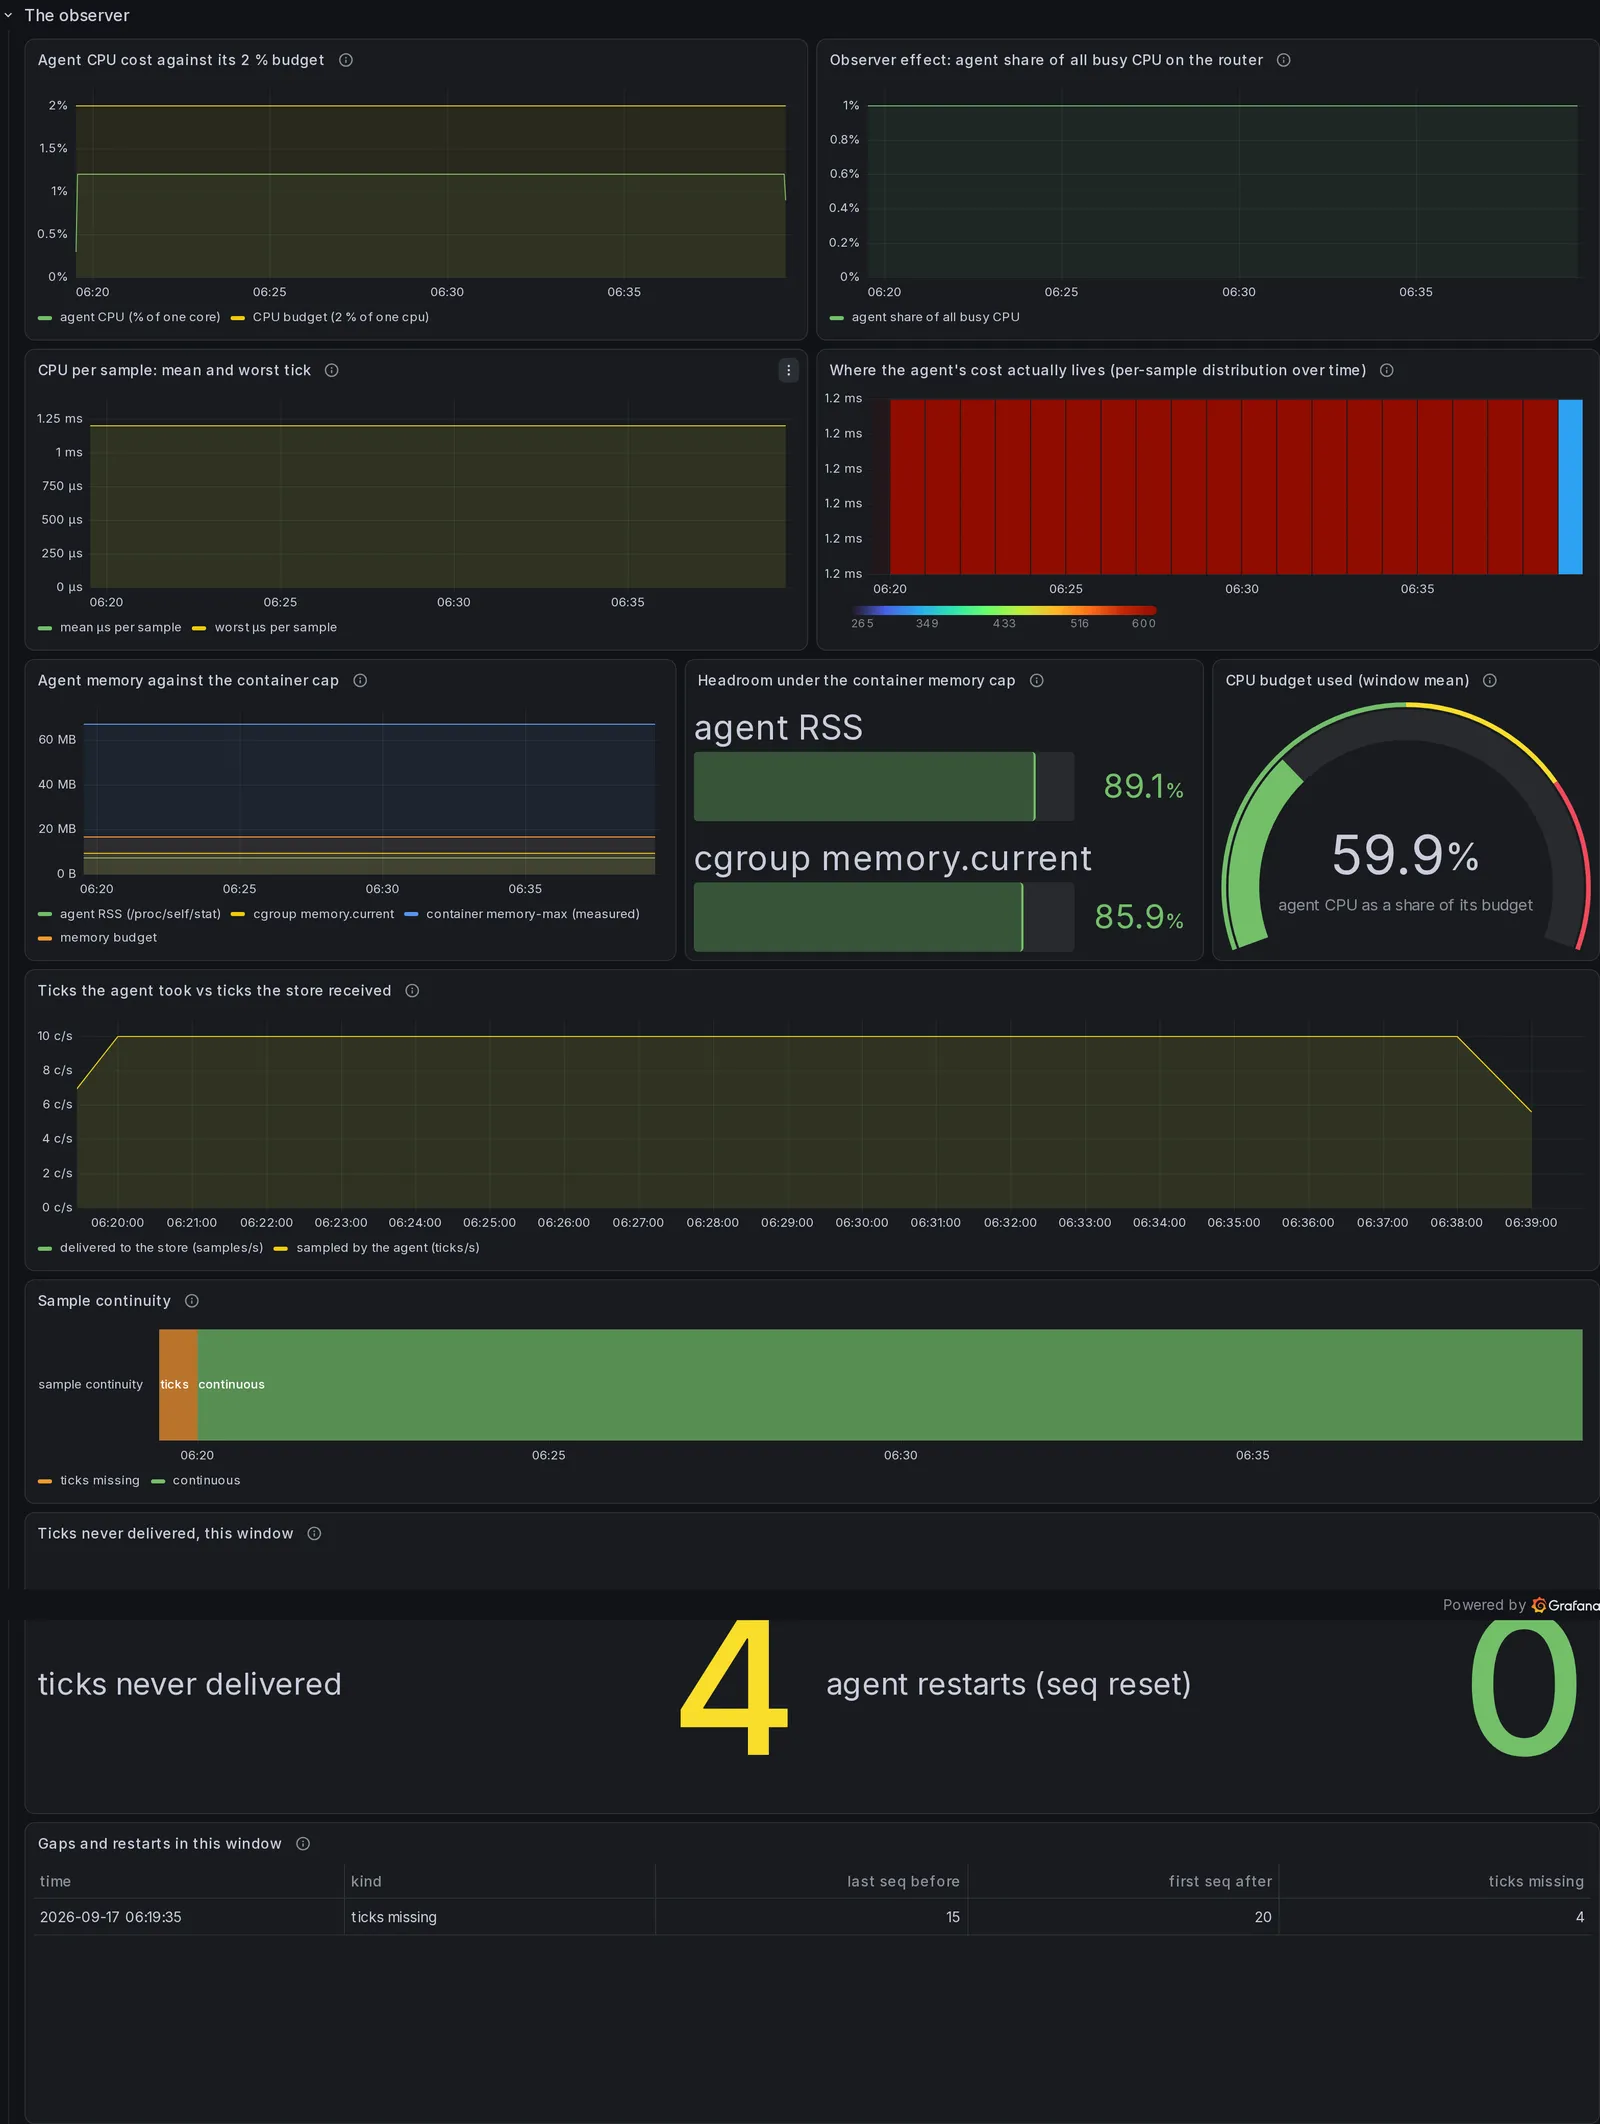
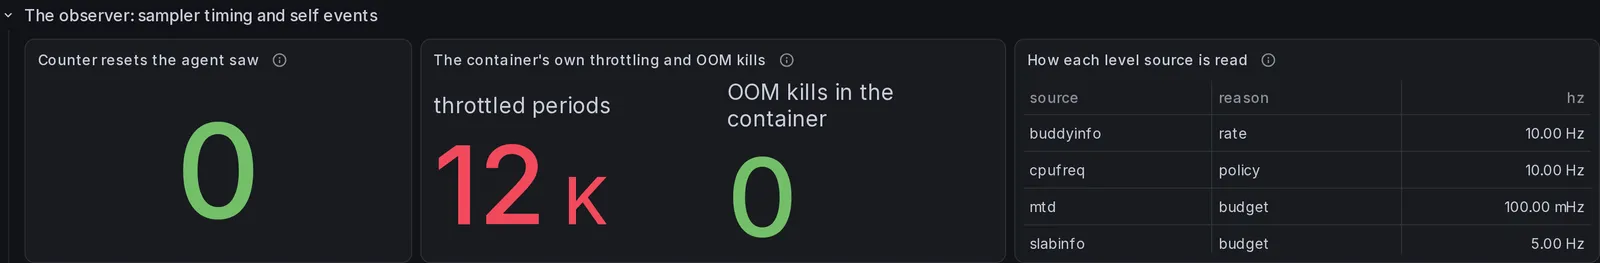
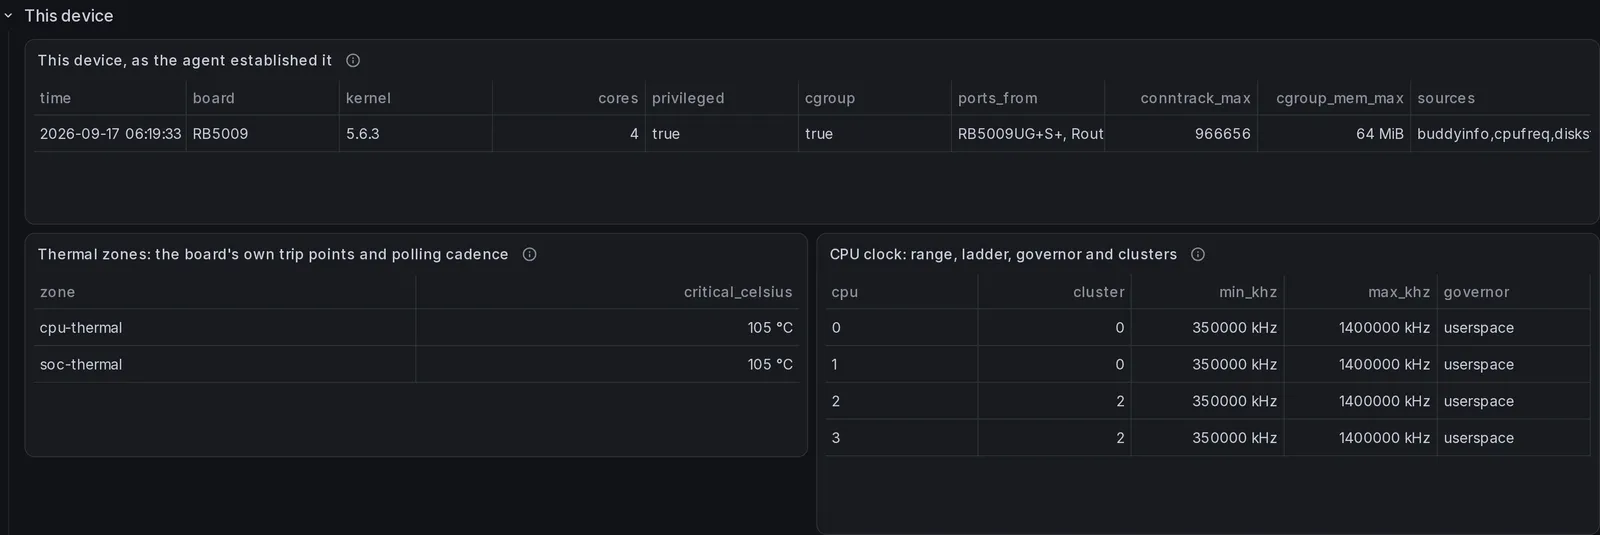
Sección titulada «Capturas»Una captura por sección del dashboard de InfluxDB, en el orden en que las pone el dashboard. Cada una enlaza al fichero a tamaño completo.
Las capturas muestran una base de demostración, no un router: el dashboard de InfluxDB sobre una
ejecución del agente simulado enlatado que usan las baterías de extremo a extremo, escrita en un
almacén en contenedor por el paso de llenado de test/e2e/docker/ y fotografiada por
el script site/. El host se llama rb5009 porque
el agente simulado imita el /proc capturado de esa placa, y las cifras son las que publique el
simulador: léelas como la forma de la página, nunca como una medición. Un panel vacío en una
captura es uno para el que el agente simulado no produce nada; en un router real con la capa de la
API en marcha, varios se llenan, y vuelven dos secciones enteras que el sondeo del almacén movió a
«no disponible».
Paneles por almacén
Sección titulada «Paneles por almacén»Cada panel se declara una sola vez, con su SQL y su PromQL uno al lado del otro, de modo que un panel añadido a un almacén queda añadido al otro. Cuando un panel no tiene consulta para un almacén, el generador lo quita del dashboard de ese almacén en vez de publicarlo para que muestre “No data” para siempre. Una sección a la que se le quitan todos los paneles no emite ninguna fila.
Por eso difieren los recuentos, y difieren en los dos sentidos. Casi toda la familia térmica y de
reloj, la sección de desgaste de la flash, el censo de slab y varios paneles de memoria tienen SQL y
no PromQL, así que solo existen en InfluxDB. Tres cosas existen solo en Prometheus, porque ninguna
se escribe en InfluxDB: las supresiones de disparadores, la racha de ocupación aún en curso y la
antigüedad de cada lectura retenida, todas ellas familias de la exposición del /metrics del
colector. Los histogramas de temporización del muestreador y el presupuesto de capturas también
están en el /metrics del colector, pero tienen además forma en InfluxDB. Cada panel de abajo que
está en un solo almacén dice en cuál.
| Sección (fila en Grafana) | InfluxDB 3 | Prometheus | PostgreSQL | Graphite | Elasticsearch |
|---|---|---|---|---|---|
| Overview | 13 | 13 | 12 | 10 | 6 |
| CPU and scheduler | 11 | 9 | 11 | 1 | sin fila |
| Memory and load | 9 | 9 | 9 | 7 | 5 |
| Connections | 9 | 3 | 9 | 1 | 1 |
| Interface traffic | 14 | 12 | 10 | 2 | sin fila |
| Detections and captures | 6 | 4 | 6 | sin fila | sin fila |
| Network receive path | 9 | 7 | 9 | 3 | 3 |
| Forwarding cost (derived) | 4 | 4 | 4 | sin fila | sin fila |
| Interrupts and softirqs | 12 | 10 | 12 | 2 | 2 |
| Temperature and clock | 10 | 2 | 10 | 2 | 2 |
| Kernel log | 7 | 6 | sin fila | sin fila | sin fila |
| CPU: how long a core stayed busy | 3 | 4 | 3 | sin fila | sin fila |
| Memory: fragmentation | 3 | 1 | sin fila | sin fila | sin fila |
| Memory: reclaim and page faults | 8 | 6 | 8 | 2 | 1 |
| Memory: detail and cross-checks | 5 | 3 | 5 | 1 | 1 |
| Hardware counters (PMU) | 11 | 7 | 11 | sin fila | sin fila |
| Flash wear | 7 | sin fila | 7 | 1 | 1 |
| NAND health (ECC) | 2 | 2 | 2 | sin fila | sin fila |
| RouterOS API cross-checks — CPU and memory | 9 | 9 | 9 | 1 | sin fila |
| The observer | 11 | 9 | 10 | 3 | 3 |
| The observer: sampler timing and self events | 6 | 7 | 6 | sin fila | sin fila |
| This device | 3 | 3 | 3 | sin fila | sin fila |
| Not available on this device | 5 | 5 | 5 | 3 | 3 |
| Total | 177 | 135 | 161 | 39 | 28 |
Desliza en horizontal para ver todas las columnas
Los recuentos son los de los ficheros del repositorio, que llevan los valores compilados por defecto.
dashboards import, dashboards publish y forward --grafana preguntan primero a la fuente de
datos qué contiene y pueden meter paneles en la última fila o sacarlos de ella, y check comprueba
el dashboard que guardaría import; consulta
No disponible en este equipo más abajo.
Orden de las secciones
Sección titulada «Orden de las secciones»Las secciones están ordenadas por la frecuencia con que se abren, no por taxonomía:
- las cuatro preguntas con las que llega un operador: cuánto trabaja el router, cuánta memoria le queda, cuántas conexiones mantiene y cuánto tráfico mueve;
- lo que marcaron el colector y el agente;
- las familias que explican las cuatro primeras cuando una tiene mala pinta;
- los niveles profundos a los que un lector va a propósito;
- lo que mikroscope le cuesta al router que está midiendo.
Todas las secciones salvo el Overview se publican plegadas. Grafana guarda los paneles de una fila plegada dentro del objeto de la fila y no ejecuta ninguna de sus consultas hasta que alguien la despliega, así que el primer renderizado pide al almacén los trece paneles del Overview (doce en PostgreSQL) y no los 177.
Los valores por defecto son un rango de 3 horas (now-3h) y un refresco de 5 minutos. Una ventana
de 15 minutos muestra paneles vacíos mientras el agente está parado, y un ruido ilegible de
muestras de 100 ms mientras funciona. El refresco lento es para cuando se despliega una sección: el
censo de slab y los mapas de calor de la PMU y del coste por muestra devuelven una fila por
muestra, y maxDataPoints no se aplica al SQL en bruto. Fija tu propio rango y tu propio refresco
para una investigación en vivo.
Overview
Sección titulada «Overview»Overview es la única sección desplegada por defecto. Muestra si el router está sano ahora y, antes, si puedes fiarte de sus números.
- Solo agregados. Ningún panel es un mapa de calor ni una combinación de varias medidas, y todos devuelven un agregado. Tres paneles (“Reboots in the window”, “Sample continuity” y “Ticks never delivered, this window”) calculan el suyo con una función de ventana sobre las muestras en bruto de la ventana.
- Copias. La mayoría de los paneles son copias de paneles de una sección posterior, porque un panel de Grafana pertenece exactamente a una fila. Las copias comparten su SQL. En Prometheus, el “OOM kills in the window” del Overview y el “Ticks never delivered, this window” del observador difieren de sus homólogos: el del observador lleva una tercera consulta, los ticks perdidos por retraso del muestreador.
- Solo aquí. “Connections tracked right now”, “Load average (1 min) against the core count”, “Reboots in the window”, “Detections in the window” y “Port errors in the window”. En Prometheus, también “OOM kills in the window”: la copia de la sección de recuperación de memoria no tiene PromQL y se quita.
- CPU busy per core, Memory in use, against the kernel’s own total (
(MemTotal − MemAvailable) / MemTotalen el tiempo, con líneas discontinuas al 75 % y al 90 %) y Connections tracked right now (los objetos activos del slabnf_conntrack; en blanco en un contenedor sin privilegios, y el panel lo dice). - Interface throughput — rx above, tx below (capa de la API; en blanco con
--api-mode off, y el panel nombra la opción), Die temperature by zone y Load average (1 min) against the core count, donde el número de núcleos se mide en el almacén en vez de suponerse. - Sample continuity, a todo lo ancho: cada intervalo, nunca más estrecho que un minuto, clasificado como continuo, con ticks perdidos o con el agente reiniciado, a partir de la primera diferencia del número de secuencia de las muestras. En Prometheus, que no tiene número de secuencia, la franja lo aproxima a partir del contador de huecos del colector y de los reinicios del contador de muestras del agente, y su descripción lo dice. Todos los demás paneles del dashboard deben leerse contra esta franja.
- Packets dropped in the kernel RX path (window total), OOM kills in the window, Reboots in the window y Detections in the window — cada uno a cero en un equipo sano y coloreado según sus propios umbrales.
- Port errors in the window (todos los errores MAC tipificados de todos los puertos, sumados;
capa de la API, en blanco con
--api-mode off) y Ticks never delivered, this window, que cuenta además los reinicios del agente.
El Overview mide 31 unidades de cuadrícula de alto en InfluxDB, Prometheus y PostgreSQL, cabecera de fila incluida (21 en Graphite, 14 en Elasticsearch). Por debajo de unos 768 px de ancho, Grafana apila cada fila de 24 columnas en una sola columna, así que en un móvil el Overview ocupa varias pantallas (alturas renderizadas).
Secciones de uso diario
Sección titulada «Secciones de uso diario»CPU y planificador
Sección titulada «CPU y planificador»Ticks de /proc/stat y la cadencia del propio muestreador. Cada serie por núcleo sale de los datos
(GROUP BY cpu, by (cpu)), así que una placa de 2 núcleos y una de 8 dibujan cada una sus propias
líneas.
- CPU busy per core
- Busy per core, p95 of one-second means
- Worst sample interval, relative to the window's median
- Per-core busy as states — which core paid, and when
- Where the ticks went — device share by mode
- softirq share of busy time, per core
- Busy-tick distribution per sample
- Share of samples the tick counter called completely idle
- Cycles retired in samples /proc/stat called idle — solo InfluxDB
- nice, irq and iowait ticks in the window
- Tick accounting closes — solo InfluxDB
Memoria y carga
Sección titulada «Memoria y carga»Los niveles de /proc/meminfo y /proc/loadavg, promediados o con el máximo sobre un intervalo y
nunca sumados. Todo “porcentaje de RAM” divide por el total que emite el propio kernel.
- Memory in use, against the kernel's own total
- Load average, all three windows
- Runnable threads out of total
- Memory by category, as a share of total
- Free memory — three definitions, against the ceiling
- Commit headroom — Committed_AS as a share of CommitLimit
- Load average (1 min) per core
- Threads on the whole router
- Slab — the conntrack and route tables the netns hides
Conexiones
Sección titulada «Conexiones»La tabla de conexiones del router, sacada del asignador de slab global (/proc/slabinfo, solo con
privilegios), junto al recuento de la capa de la API cuando se consulta. Una sección vacía aquí
significa un agente sin privilegios, no un router en reposo; el panel “Slab caches reporting” existe
para decir cuál de los dos es.
- Connection table, two ways — slab objects against the RouterOS API count
- Connection churn floor — peak-to-trough swing inside each bin — solo InfluxDB
- Packet-buffer and large-allocation caches — solo InfluxDB
- Every slab cache, normalized to its own window minimum — solo InfluxDB
- Connection count distribution over time (nf_conntrack) — solo InfluxDB
- Slab census — latest, min, max and spread per cache — solo InfluxDB
- Connection table occupancy
- Connections as RouterOS counts them (API poll)
- Slab caches reporting (is this a privileged deployment?) — solo InfluxDB
Tráfico por interfaz
Sección titulada «Tráfico por interfaz»/interface/, los contadores por puerto del MAC y /system/health desde la API de
RouterOS — los únicos contadores por interfaz que tiene mikroscope, porque el /proc/net/dev del
contenedor describe su propio veth — junto a la configuración que la capa de la API lee al arrancar
y cada --labels-every: qué es cada interfaz. Las tasas llegan ya por segundo y nunca se suman, y
los contadores por puerto tampoco, porque RouterOS cuenta una cosa distinta en cada tipo. Un puerto
del switch cuenta su cable, tramas reenviadas por hardware incluidas; el bridge cuenta su lado de
CPU; una VLAN o un PPPoE cuentan lo que la CPU envió y recibió. Un puerto del switch y el bridge son
por tanto planos distintos, y ninguno es un subconjunto del otro
(medido). El conjunto de interfaces de los paneles de tasas es el
que seleccionó --interfaces, así que una interfaz que falta en uno puede estar en reposo, sin
configurar o sin seleccionar, y las tres cosas se ven igual.
- Interface throughput — rx above, tx below
- Interface packet rate — rx above, tx below
- Mean packet size per interface
- CPU cost of forwarding: cpu-load against the busiest interface's packet rate — solo InfluxDB
- Port errors per bin — typed, from the MAC counters
- Where a port's receive bytes went — switched in hardware, CPU fast path, CPU slow path — solo InfluxDB
- Link flaps — link-downs per interface, per bin
- Frame size mix over the window, per Ethernet port
- Egress queue drops — the router's own transmit queue
- Packets the interface itself dropped — rx and tx
- What each interface is: type, role, bridge and label
- Interface inventory and window summary
- /system/health sensors, as RouterOS reads them
- API tier coverage — which sources delivered, and when
“What each interface is: type, role, bridge and label” es la tabla que hay que leer antes de comparar
dos series de interfaz: una fila por interfaz que tiene el router — el tipo de RouterOS, sus listas
de interfaces, el bridge del que es puerto, su comentario, su nombre de fábrica y su MTU — a partir
de tres lecturas de configuración, nunca por consulta. “Frame size mix over the window, per Ethernet
port” es una fila por puerto y no lleva total: cada contador tx-rx-* guarda los dos sentidos de su
propio puerto, así que una trama conmutada de ether1 a ether8 se cuenta en los dos, y una suma por
puertos cuenta dos veces cada trama conmutada. “Interface inventory and window summary” no lleva
columnas de errores, porque monitor-traffic no devuelve ninguna tasa de error
(verificado); los contadores de error tipificados del MAC tienen
su propio panel.
Sucesos
Sección titulada «Sucesos»Detecciones y capturas
Sección titulada «Detecciones y capturas»Sucesos, no niveles: lo que la etapa de derivación del colector y la
captura por disparo del agente dijeron de la ventana. Vacío es el
estado sano, y los paneles de sucesos están marcados como vacíos conocidos para que check no falle
por ello.
- Detections per bin, by rule
- Memory pressure state
- Detections in this window — solo InfluxDB
- Trigger fires and suppressions per bin
- Captures held on the agent, and the budget they pin
- Trigger markers in this window — solo InfluxDB
En “Trigger fires and suppressions per bin”, las supresiones solo están en Prometheus: las representa el colector en su exposición y ningún almacén lleva un campo para ellas.
Anotaciones de detecciones
Sección titulada «Anotaciones de detecciones»Un dashboard con detecciones en su ventana dibuja una raya vertical roja discontinua, con un pequeño triángulo al pie del eje, cruzando todos los paneles en el instante de cada una. Son anotaciones, no datos: no son un hueco en el registro, ni un tick perdido, ni un corte de la serie. Te dejan leer el panel en el que estés al lado de lo que el colector señaló en ese momento — un régimen de atasco en memoria en un núcleo, una microrráfaga en una cola, un enlace que parpadeó — sin bajar a la sección de detecciones.
Cada dashboard trae dos capas:
| Capa | Color | Por defecto | Qué es cada marca |
|---|---|---|---|
| detections | rojo | activada; desactivada tras un sondeo de InfluxDB que no encuentra mikroscope_detection |
una fila de mikroscope_detection: regla: mensaje, de la etapa de derivación del colector |
| triggers | naranja | desactivada | un marcador de captura del agente: la condición que se disparó, el campo y el valor |
Desliza en horizontal para ver todas las columnas
Al pasar el ratón por una marca sale el mensaje que lleva la fila, así que la raya responde al qué
además de al cuándo. Una regla que se dispara por clave (un núcleo, un puerto, una zona térmica)
empieza su mensaje con esa clave, así que la marca dice, por ejemplo, microburst: cpu0: …. El SQL
no lee la columna key: el sink de InfluxDB solo la escribe cuando la detección tiene una, y seis
reglas no la tienen nunca, así que un almacén cuyas detecciones son todas de esas no tiene esa
columna y una consulta que la nombre falla. La capa de disparos viene apagada para que un dashboard
tranquilo siga tranquilo; actívala cuando estés trabajando con
capturas disparadas.
Antes de la primera detección. Un almacén InfluxDB no tiene la tabla mikroscope_detection
hasta que el colector escribe su primera detección, e InfluxDB 3 rechaza una consulta que nombra
una tabla que no existe; ninguna forma de la consulta lo evita
(formas probadas). dashboards import, dashboards publish
y forward --grafana preguntan antes al almacén y, si la tabla no está, publican la capa de
detecciones apagada, con su consulta, para que puedas encenderla más adelante. Los ficheros del repositorio y una
importación a mano no tienen a quién
preguntar, así que la capa sigue encendida: su consulta falla en cada carga y cada refresco sin
mostrar nada en el dashboard, y Grafana escribe cada vez una línea de nivel error
Partial data response error en su log (observado). Las
marcas aparecen solas cuando la primera detección crea la tabla. En Prometheus el contador
simplemente no existe y la consulta devuelve un resultado vacío, así que la capa sigue encendida
también tras un sondeo. El sink de PostgreSQL crea todas las tablas antes de su primera inserción,
así que allí la consulta devuelve cero filas hasta la primera detección
(comprobado en la batería de contenedores). En una de las
versiones de Grafana probadas, la consulta de la capa de InfluxDB no llega a enviarse, con la tabla
o sin ella, y no se dibuja ninguna marca (problema conocido).
Cómo apagarlas. Las dos capas son casillas en la fila de submenú de debajo del título del dashboard — la misma fila en la que van las variables de un dashboard, que en los de InfluxDB, Prometheus y PostgreSQL no lleva nada más. Pulsa el nombre de la capa para ocultar sus marcas. Es un ajuste de vista: dura la sesión, y guardar el dashboard lo conserva. No cambia nada de las filas subyacentes, y la sección de detecciones las sigue contando.
Cada almacén dibuja las capas a partir de lo que escribe su sink, en su propio lenguaje de consulta:
- InfluxDB y PostgreSQL: una fila de
mikroscope_detectionomikroscope_triggerpor marca, con su mensaje. - Prometheus:
increase(…[1m]) > 0con un paso de 1 minuto, así que allí una marca es el minuto, no el instante. - Elasticsearch: un filtro Lucene,
kind:detection AND host.(okeyword:$host kind:trigger), sobre los documentos de suceso. El texto de una detección es sumessagey su etiqueta larule; un documento de disparo no lleva mensaje, así que su texto es elfieldque cruzó y su etiqueta lacause. - Graphite:
aliasByNode($prefix.(o$host. detection.*, 3) .trigger.*), el punto por suceso que escribe el sink. Grafana pone una marca en cada punto no nulo y la titula con el nombre de la serie, que es la regla o la causa. No hay mensaje, porque Graphite solo guarda números, y la marca cae en el instante del punto que Grafana recibe: Grafana pide como mucho 100 puntos, así que varios sucesos muy juntos pueden volver como uno.
Las capas de Elasticsearch y Graphite las comprueban los tests unitarios contra lo que escribe cada sink (no ejecutadas en Grafana): la comprobación de importación solo recorre paneles.
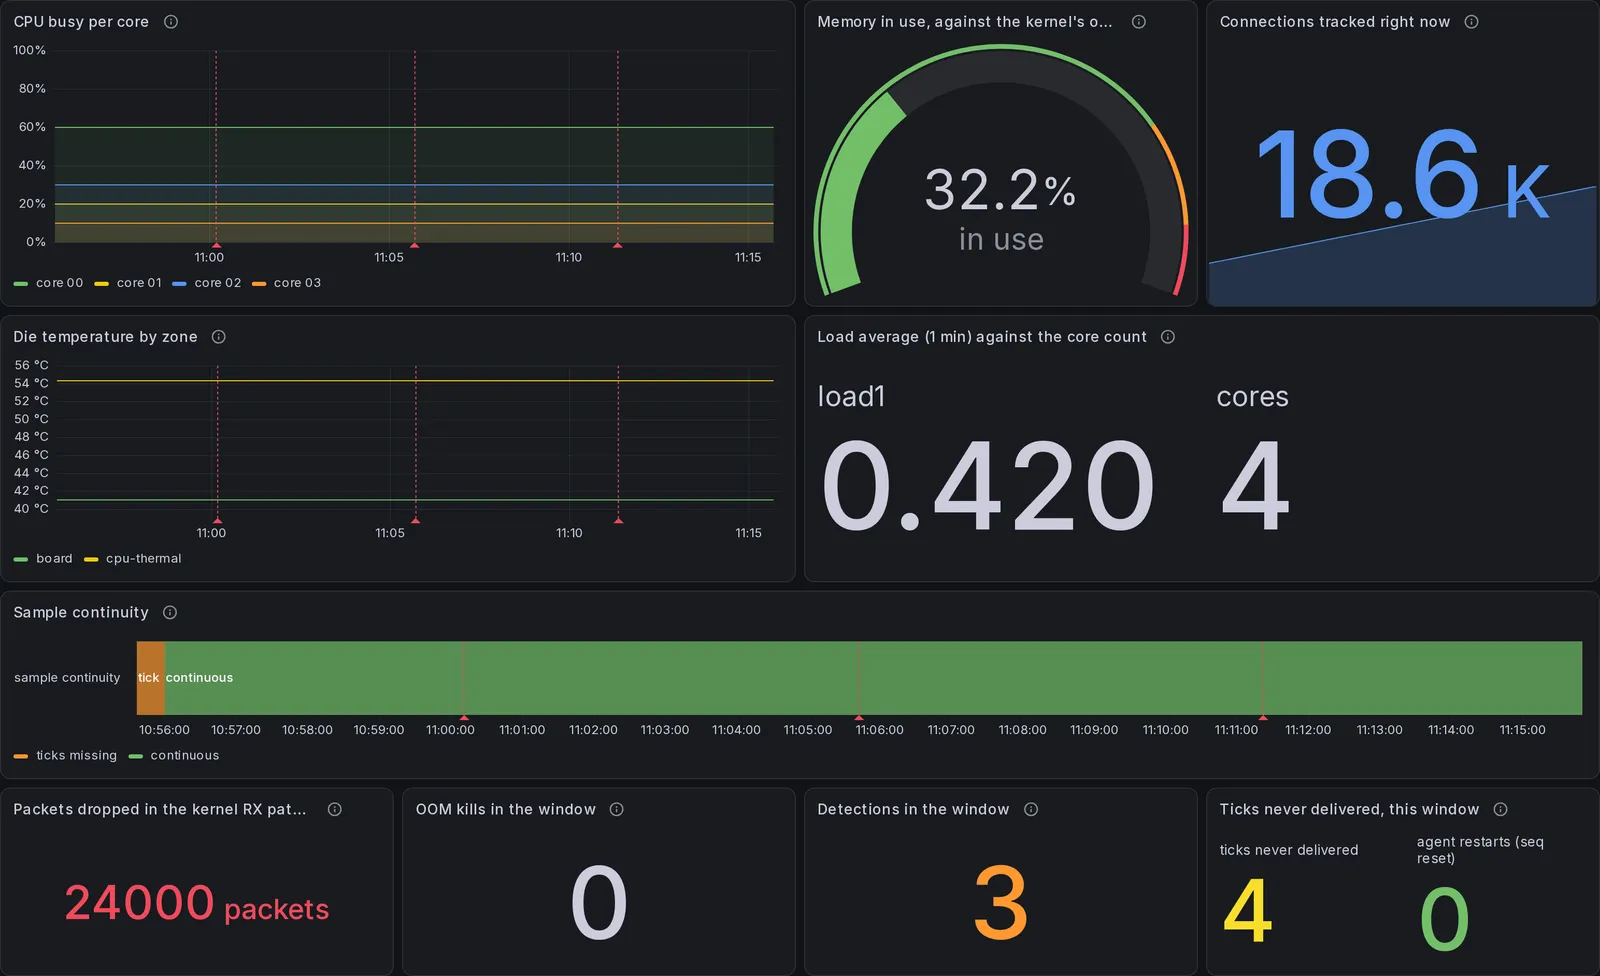
Las capturas por sección de más arriba están tomadas con las dos capas apagadas, porque el agente simulado que llena la base de demostración dispara una detección cada pocos segundos y veinte minutos de eso salen fotografiados como una mancha roja. Esta es la misma vista general con la capa de detecciones activada, sobre una base de demostración que lleva tres — la densidad que produce un despliegue real, y el recuadro de abajo a la derecha cuenta esas mismas tres:
Secciones de diagnóstico
Sección titulada «Secciones de diagnóstico»Ruta de recepción de red
Sección titulada «Ruta de recepción de red»/proc/net/softnet_stat, que es global incluso dentro del espacio de nombres de red del contenedor.
Aquí no sobrevive ninguna banda absoluta de tasa de paquetes: el régimen de squeeze se clasifica como
un múltiplo de la mediana de la propia ventana.
- RX path: packets processed per second, per core
- Squeeze rate: softirq budget exhaustions per second, per core
- Squeeze pressure: budget exhaustions per 1 000 packets
- Receive-path balance across cores
- Packets dropped in the kernel RX path (window total)
- Squeeze regime per core, as a multiple of this window's median
- Burst distribution: packets per sample (all cores) — solo InfluxDB
- Squeeze against throughput (1 s points, whole window) — solo InfluxDB
- Packets per NET_RX poll, per core
Coste de reenvío (derivado)
Sección titulada «Coste de reenvío (derivado)»Los cocientes por paquete y la proporción de ruta rápida que el colector deriva cruzando subsistemas — la PMU contra softnet, softnet contra las interrupciones, los contadores de puerto de RouterOS entre sí.
La proporción de ruta rápida es la proporción del tráfico que una interfaz le entrega a la CPU, no
una proporción del cable: fp-rx-byte sobre driver-rx-byte en un puerto del switch, sobre
rx-byte en una interfaz software, con las tramas conmutadas por hardware fuera de los dos números.
Ese reparto lo enseña el panel “Where a port’s receive bytes went”, a partir de los contadores en
bruto. La línea de tx suele estar ausente: fp-tx-byte puede quedarse en 0 en todas las interfaces
después de cientos de GB transmitidos (observado), así que el
colector retiene la proporción de tx mientras el contador acumulado sea 0 en vez de dibujar un 0 %
que no ha medido. Por intervalo, la proporción está ponderada por bytes — los bytes de ruta rápida
del intervalo sobre los bytes del intervalo — porque una interfaz que mueve unos pocos paquetes por
consulta oscila entre 0 y 100 % de una consulta a otra. La forma de Prometheus es el medidor por
consulta del colector y conserva ese ruido.
- Cycles, instructions and cache misses per packet
- Packets per device interrupt (NAPI coalescing depth)
- Fast-path share of the traffic each interface hands the CPU
- Sub-sample bursts: squeezed samples whose packet count looked ordinary
Interrupciones y softirqs
Sección titulada «Interrupciones y softirqs»Deltas de /proc/interrupts y /proc/softirqs. El nombre del dispositivo se recupera en la consulta
a partir del texto en bruto de /proc/interrupts, no comparándolo con un nombre de driver.
- Interrupts per second by source (top-K)
- Per-line interrupt load on the device with the most lines
- Receive-path IRQ imbalance (max / mean across a device's lines)
- Which core takes each interrupt
- Top-K interrupt coverage
- Interrupt mix right now
- Top-K membership — which interrupt sources the agent was watching — solo InfluxDB
- NET_RX softirq invocations per core
- Softirq invocations by kind (all CPUs)
- NET_RX burst size distribution per sample — solo InfluxDB
- µs of softirq CPU per invocation
- NET_TX and TASKLET softirq invocations per second
Temperatura y reloj
Sección titulada «Temperatura y reloj»/sys/class/thermal y cpufreq. Todo umbral térmico se mide desde el punto de disparo crítico de la
propia zona, leído de la placa: los umbrales del panel de margen están a 10 °C y 5 °C de margen por
debajo de él. Ningún panel lleva una temperatura que la placa no haya publicado.
- Die temperature by zone
- Temperature by source — kernel zones, and the RouterOS sensor when it is polled — solo InfluxDB
- Thermal slope, °C per minute by zone
- Sensor step dwell — where each zone actually sat — solo InfluxDB
- Latest temperature by zone — solo InfluxDB
- Thermal headroom — how far each zone is from its own critical trip — solo InfluxDB
- Gap between the hottest and coolest thermal zone — solo InfluxDB
- Core clock per core — governor state — solo InfluxDB
- Is the clock pinned? — solo InfluxDB
- Clock-weighted work: effective Hz per core — solo InfluxDB
Log del kernel
Sección titulada «Log del kernel»/dev/kmsg, solo con privilegios. Cuando el log está vacío no está ausente, está en silencio, y el
silencio es el estado sano.
- Worst kernel-log severity in each bin
- Kernel-log records per second by severity
- Warning-or-worse kernel-log rate now
- Kernel records in the window, by severity
- Kernel records per sample — burst distribution against the per-tick cap — solo InfluxDB
- Port events from the kernel log, per port and kind
- Port events in the window, per port
Dos de ellos leen los registros del kernel que nombran un puerto de red:
- Port events from the kernel log, per port and kind los cuenta por intervalo, una serie por puerto y clase.
- Port events in the window, per port es el censo que va a su lado: una fila por puerto, con la etiqueta, el rol y una columna por clase.
Cómo se forma y se lee un registro de puerto:
- Clase. Cada registro lleva una: link-up, link-down,
stp-<estado>, own-address (el bridge recibiendo una trama con su propia MAC como origen, la firma de un bucle de capa 2) u otra. El agente la clasifica mientras lee/dev/kmsg; el colector clasifica los registros de un agente que no lo hace. - Nombre y etiquetas. El colector sustituye el nombre de fábrica del puerto por el nombre actual de la interfaz en RouterOS y le añade su comentario y sus listas de interfaces desde el inventario de la capa de la API. Sin la capa de la API el registro conserva el nombre de fábrica y no lleva etiqueta.
- Coste y punto ciego. Esta vista por puerto viene gratis con el contenedor: el log del kernel no le cuesta nada al router y fecha cada transición al microsegundo, mientras que los contadores por puerto de RouterOS necesitan una lectura de la API en cada consulta. Es ciega a todo lo que el kernel nunca llega a oír, las tramas conmutadas por hardware incluidas.
- Secuencia STP. A un link-up le siguen stp-blocking, stp-learning y stp-forwarding en su puerto del bridge: cuatro registros, no cuatro fallos.
- Vacíos conocidos. Los dos paneles están marcados como vacíos conocidos, porque un conjunto de puertos tranquilo es el estado sano.
- Prometheus. La forma de Prometheus lee el
/metricsdel colector, donde todo registro de puerto lleva unkindporque el colector clasifica lo que le llega sin clasificar.
En InfluxDB la tabla mikroscope_kmsg se crea con el primer registro del kernel que se escribe, y su
columna kind con el primer registro de puerto que se escribe ya clasificado. En un router cuyo
kernel no ha dicho nada desde que arrancó el colector, la tabla no existe e InfluxDB 3 rechaza la
consulta al planificarla; la sección plegada impide que esa consulta se ejecute hasta que alguien la
abre. El código lo llama una mitigación, no un arreglo. Una publicación con sondeo, la de
dashboards import o la del colector, lleva esos paneles a la fila de no disponibles.
Secciones de detalle
Sección titulada «Secciones de detalle»CPU: cuánto tiempo siguió ocupado un núcleo
Sección titulada «CPU: cuánto tiempo siguió ocupado un núcleo»La contigüidad, que ningún histograma por muestra puede recuperar: una meseta de 2 s y veinte picos
sueltos caen en los mismos intervalos. En InfluxDB las longitudes de racha son una consulta sobre las
muestras en bruto; en Prometheus son el borde superior del bucket poblado más alto de
mikroscope_, recortado a 60 s, así que 60 se lee como “más de un minuto”, no
como una medida.
- Longest run at or above 90 % busy, per cpu
- Longest run at or above 50 % busy, per cpu
- Busy run in progress right now — solo Prometheus
- Blocked tasks and forks
Memoria: fragmentación
Sección titulada «Memoria: fragmentación»/proc/buddyinfo, el único número de memoria que /proc/meminfo no puede dar.
- Free memory by block order (pages) — solo InfluxDB
- Free blocks per order (count)
- Largest block order with any free block — solo InfluxDB
Memoria: recuperación y fallos de página
Sección titulada «Memoria: recuperación y fallos de página»Los deltas de /proc/vmstat, sumados o convertidos en tasa sobre un intervalo y nunca promediados —
en una sección separada de los niveles para que los dos tipos de reductor no puedan mezclarse.
- Reclaim efficiency — pgsteal ÷ pgscan
- Did the kernel have to reclaim at all?
- Allocation distress — stalls and swap
- OOM kills in the window — solo InfluxDB
- Page churn — allocate, free, and the net
- Page faults — minor and major per second
- Minor-fault bursts — distribution per sample — solo InfluxDB
- Context switches and all interrupts per second
Memoria: detalle y comprobaciones cruzadas
Sección titulada «Memoria: detalle y comprobaciones cruzadas»La escritura diferida, la LRU, los niveles pequeños y dos paneles que validan el propio instrumento. Se leen una vez por equipo nuevo, no durante un incidente.
- Writeback backlog — dirty pages and pages in flight
- LRU balance — active vs inactive
- Mapped, kernel stacks and page tables
- vmstat pages vs meminfo kB — unit cross-check — solo InfluxDB
- Kernel stack per thread — solo InfluxDB
Contadores hardware (PMU)
Sección titulada «Contadores hardware (PMU)»perf_event_open desde el contenedor privilegiado. Cada panel divide dos recuentos en bruto; los
normalizados por reloj dividen por la frecuencia que el kernel informó para ese núcleo en esa
muestra.
- IPC per core (instructions retired / cycles)
- Beneath the tick floor: PMU cycles against /proc/stat busy ticks — solo InfluxDB
- Instructions retired while /proc/stat reported the core idle — solo InfluxDB
- Work the jiffie threw away (selected range) — solo InfluxDB
- Core cycles per bus cycle
- Unhalted-cycle fraction of the clock, per core
- Distribution of cycles per sample, as a share of the clock (all cores pooled) — solo InfluxDB
- Cache-miss rate per core (misses / references)
- Cache misses per 1 000 instructions (MPKI), per core
- Branch mispredictions per 1 000 instructions per core
- PMU counters this CPU actually opened
Desgaste de la flash
Sección titulada «Desgaste de la flash»/proc/yaffs, la única señal de desgaste de la NAND en una RouterBOARD. Solo InfluxDB: la sección no
tiene fila en el dashboard de Prometheus. Ningún panel puede mostrar una proporción de la partición,
porque el agente no analiza el rango de bloques de la partición, así que no hay denominador para ello.
- Flash page traffic per YAFFS partition (pages/s)
- Write amplification — GC copies per page write
- Flash housekeeping — erasures, garbage collections and GC copies per bin
- YAFFS free-chunk drift within the window (chunks, relative to the first sample)
- YAFFS partition state over the window
- Bad blocks retired during the window, per YAFFS partition
- Page writes and erasures per day, at the window's rate
Salud de la NAND (ECC)
Sección titulada «Salud de la NAND (ECC)»Los contadores ECC de MTD bajo /sys/class/mtd, solo con privilegios — el indicador adelantado de la
flash, mientras que el recuento de bloques defectuosos de YAFFS es la autopsia.
- ECC corrections since boot, per partition, against the bitflip threshold
- Uncorrectable ECC failures and bad blocks, per partition
Comprobaciones cruzadas con la API de RouterOS — CPU y memoria
Sección titulada «Comprobaciones cruzadas con la API de RouterOS — CPU y memoria»/system/resource y /system/resource/cpu: la capa independiente contra la que se comprueban las
cifras del kernel. RouterOS las recalcula una vez por segundo, así que cada campo es de 1 Hz como
mucho y está cuantizado en enteros; ningún panel de aquí pretende una lectura por debajo del segundo.
- RouterOS cpu-load vs kernel busy — do the two tiers agree?
- Cross-tier residual: cpu-load − kernel busy, distribution
- Per-core load, RouterOS's own accounting
- Per-core mean over the window: RouterOS load next to kernel busy
- Per-core IRQ time as RouterOS accounts it, against kernel softirq+system
- Per-core disk time (RouterOS) — max over the window
- RAM used, as RouterOS accounts it
- Free memory: RouterOS free-memory vs the kernel's two answers
- RouterOS uptime
Secciones del observador
Sección titulada «Secciones del observador»El observador
Sección titulada «El observador»Lo que mikroscope le cuesta al router que está midiendo, y si estaba funcionando. En InfluxDB, la continuidad se deriva del número de secuencia de cada muestra (Prometheus la aproxima, como en el Overview), lo que puede destapar ticks perdidos y reinicios que el registro de huecos del colector no muestra (ejemplo).
- Agent CPU cost against its 2 % budget
- Observer effect: agent share of all busy CPU on the router
- CPU per sample: mean and worst tick
- Where the agent's cost actually lives (per-sample distribution over time) — solo InfluxDB
- Agent memory against the container cap
- Headroom under the container memory cap
- CPU budget used (window mean)
- Ticks the agent took vs ticks the store received
- Sample continuity
- Ticks never delivered, this window
- Gaps and restarts in this window — solo InfluxDB
El observador: temporización del muestreador y sucesos propios
Sección titulada «El observador: temporización del muestreador y sucesos propios»El emborronamiento del propio muestreador — con cuánto retraso despertó y cuánto tardó la lectura — y
los sucesos de cgroup que el agente registra sobre sí mismo. Las temporizaciones viajan en el bloque self de cada muestra como
wake_ns y read_ns, así que los tres mapas de calor existen también en los paneles de InfluxDB y
PostgreSQL, no solo en Prometheus.
- Tick interval distribution, relative to the nominal period
- Wake latency: how late the sampler ran after its ticker
- Read duration: how long every source took to read
- Counter resets the agent saw
- The container's own throttling and OOM kills
- How each level source is read
- Age of each held reading — solo Prometheus
Este equipo
Sección titulada «Este equipo»El flujo de datos del equipo: lo que el agente estableció sobre la placa al arrancar sin la API de RouterOS — identidad, techos, la escalera de frecuencias.
- This device, as the agent established it
- Thermal zones: the board's own trip points and polling cadence
- CPU clock: range, ladder, governor and clusters
No disponible en este equipo
Sección titulada «No disponible en este equipo»La última fila se titula “Not available on this device — measurements this kernel or board does not produce (open to read why)” y está plegada. Un panel cuya medida no está en el almacén se saca de su sección y se lleva a esta fila, donde su descripción dice qué está esperando.
En los ficheros del repositorio — los valores compilados por defecto, que son lo que escribe gen a
secas y lo que recibe una subida manual a Grafana — la fila contiene cinco paneles: el de PSI y los
cuatro de dispositivos de bloques. En Graphite y Elasticsearch contiene tres: los paneles de
profundidad de cola y de porcentaje ocupado no tienen consulta en el lenguaje de ninguno de los dos
almacenes, así que esos dos dashboards los dejan fuera.
- Pressure stall (PSI), where the kernel exposes it
- Block-device queue depth (requests in flight)
- Block-device requests per second (reads and writes completed)
- Block-device busy percent (io_s / wall time)
- Block-device throughput (sectors → bytes per second)
El panel de PSI necesita un kernel con /proc/pressure. Los paneles de dispositivos de bloques
necesitan un dispositivo de bloques que se mueva: el agente descarta un dispositivo de bloques cuyas
lecturas, escrituras y peticiones en curso son todas cero en un tick, así que en un router cuyos
dispositivos listados se quedan todos a cero ningún destino llega a crear la tabla. Los valores
compilados por defecto los ponen aquí porque el equipo con el que se construyeron no produce
ninguna de las dos cosas (qué equipo).
En InfluxDB todas las consultas de esta fila se publican apagadas (ocultas, en el editor de
consultas de Grafana), así que abrir la fila no ejecuta nada y cada panel muestra una nota breve en
lugar de datos (renderizado). Si tu almacén sí tiene la
medida, vuelve a encender las consultas del panel en su editor, o publica de nuevo el dashboard con
dashboards import, dashboards publish o reiniciando un colector que se ejecute con --grafana
(InfluxDB y Prometheus; los otros tres no se pueden sondear), que pregunta al almacén y devuelve el
panel a su propia sección.
En los otros cuatro almacenes la fila conserva sus consultas encendidas, porque allí que falte
una medida no es un error. El sink de PostgreSQL crea todas las tablas, mikroscope_psi y
mikroscope_disk incluidas, antes de su primera inserción, así que las consultas devuelven cero
filas; Prometheus responde a una métrica ausente con un resultado vacío, y Graphite a una ruta que
no casa con nada con un cuerpo vacío. Elasticsearch responde con una línea en cero: una sum sobre
documentos que no tienen el campo da 0 en cada intervalo, aunque otro router del mismo índice haya
mapeado el campo (comprobado en la batería de contenedores).
Ese cero es un valor, no un resultado vacío, y no distingue un router que no tiene la medida de uno
cuyos valores suman cero: es el título de la fila, no la línea, lo que dice que la medida no se
produce. Las consultas siguen encendidas para que un router que sí produce la medida llene el panel
sin tocar nada; en PostgreSQL, Graphite y Elasticsearch ningún sondeo podría volver a encenderlas.
Tras un sondeo, en cualquier almacén, un panel que el sondeo no encontró se publica con sus
consultas apagadas, como en InfluxDB.
Para estos paneles hay declaradas dos secciones, Pressure stall (PSI) y Block devices, que no
emiten fila mientras todos sus paneles estén ausentes. En un kernel compilado con PSI, o en una placa
con almacenamiento USB o eMMC que se mueva, import, o el colector en su siguiente arranque,
encuentra la medida y la sección aparece en su sitio, con las consultas encendidas, sin tocar el
generador. Eso requiere un almacén que import
pueda sondear, InfluxDB o Prometheus; los otros tres no se pueden sondear y conservan la fila
compilada. import también funciona en el otro sentido: en un almacén al que le falta una medida
que los valores compilados esperan — o un campo añadido después de que ese almacén se escribiera
por primera vez — el panel pasa a esta fila con sus consultas apagadas, así que muestra su
explicación y no una insignia roja de error. Cómo decide el sondeo está en
Configurar en Grafana.
Cocientes, huecos y unidades
Sección titulada «Cocientes, huecos y unidades»- Los cocientes nunca son del agente. El agente solo envía contadores en bruto, nunca
porcentajes. Un cociente de estos dashboards se calcula o bien en la consulta del propio
panel o bien en la etapa de derivación del colector (la sección de coste de reenvío y las familias
mikroscope_derived*). Las tasas de interfaz de la capa de la API son la excepción: llegan de RouterOS ya calculadas. - Los huecos cortos no se dibujan. Una línea se corta donde dos puntos vecinos están separados más de 5 minutos. El umbral tiene que superar el intervalo más ancho que seleccione un lector — con un rango de 2 días el intervalo de un panel de 12 columnas es de unos 4 minutos —, así que un hueco de menos de 5 minutos se sigue dibujando como una línea interpolada. Lee los huecos en Sample continuity, no en la forma de una línea.
- Los números stat tienen un tamaño fijo. Un panel stat dibuja su valor a 32 px y su título a 16 px en vez de con el tamaño automático de Grafana, que llena el panel: en un móvil, donde cada panel ocupa todo el ancho, el tamaño automático convierte cada panel stat en un bloque grande de la pantalla.
- Ningún equipo va compilado. Ningún título, consulta ni umbral nombra un equipo, su número de núcleos, sus interfaces o su tamaño de memoria; los únicos números fijos son los objetivos de presupuesto propios de mikroscope (2 % de un núcleo, 16 MiB). La descripción de un panel que cita una cifra medida nombra el equipo y la fecha en que se midió, y las tuyas serán distintas.
Ficheros
Sección titulada «Ficheros»Directoriodashboards/
- mikroscope-influxdb.json 177 paneles, InfluxDB 3 (SQL)
- mikroscope-prometheus.json 135 paneles, Prometheus
- mikroscope-postgres.json 161 paneles, PostgreSQL / TimescaleDB
- mikroscope-graphite.json 39 paneles, Graphite
- mikroscope-elasticsearch.json 28 paneles, Elasticsearch
- mikroscope-alerts-influxdb.yaml 14 reglas
- mikroscope-alerts-prometheus.yaml 15 reglas
- mikroscope-alerts-postgres.yaml 10 reglas
mikroscope dashboards gen # escribe los ocho ficheros en ./dashboards, y crea el directorio si no existemikroscope dashboards gen --out /tmp/dash # o en otro directorio- Formato. El formato de exportación compartible de Grafana: la fuente de datos es un marcador
${DS_MIKROSCOPE}declarado en__inputs, no hayidy eluides fijo,mikroscope-<almacén>, uno por dashboard, así que una reimportación actualiza el mismo dashboard en su sitio en vez de crear un segundo. Un test comprueba que dos generaciones del dashboard de InfluxDB son idénticas. - Versión de Grafana.
__requiresdeclara Grafana 11.0.0. Las opciones de los paneles están escritas según el esquema que espera Grafana 13.2.1: la marca del xychart, por ejemplo, cambió de sitio entre Grafana 11 y 13. Las versiones en las que se han comprobado los dashboards están en Probado en. - InfluxDB 3. Las consultas son SQL, y todas están acotadas por
$__timeFilter, porque InfluxDB 3 Core rechaza los recorridos sin límite. Donde una columna se llamaclusterel SQL la entrecomilla, porqueclusteres una palabra reservada en DataFusion. - Prometheus. Las consultas leen un Prometheus que hace scrape del
/metricsdel colector, y de nada más: el tier de kernel recalculado a partir de las muestras, las familias derivadas y de detección propias del colector, y lo que solo el muestreador puede producir, que llega al colector como dato porque el agente no sirve exposición propia. Prometheus 3 representa el borde del bucket cero de un histograma comole="0.0", así que una consulta que lee ese bucket casa conle=~"0|0.0". El trabajo de scrape está en Configurar en Grafana.